小红书精读:Generative Recommenders Forget the Long Tail: Restoring Memorization in Retrieval and Ranking
生成式推荐忘了长尾?CAPE来补记忆
各位算法同学们,把 beam 加宽 50% 能把长尾救回来吗?这篇论文的答案是:几乎不能,命中数甚至会 −1。它把“生成式推荐为什么记不住长尾”拆成检索和排序两次遗忘,还给出一个不改模型、不重训的补丁,逻辑挺干净。
📄 Generative Recommenders Forget the Long Tail: Restoring Memorization in Retrieval and Ranking
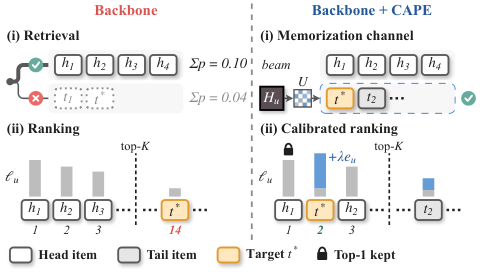
🔧 先定位病根:beam search 是按子树概率质量保留前缀的,长尾 item 的前缀质量小,还没轮到打分就被剪掉;而且 99.97% 的长尾 item 首个 SID token 和某个 head item 共享,所以调 token 分数只会整片前缀被抬高,救不到具体 item。
🧩 记忆通道:在 beam 之外按共现支持度再捞 B′ 个长尾候选,用冻结的生成器做 teacher forcing 打分,保证每个候选都有模型 likelihood,不靠前缀说话。
⚙️ 记忆校准排序:把生成器 log-likelihood 和共现证据各自 min-max 归一化后加权融合,只多一个超参 λ,外加 top-1 锚定保住生成器的首位,主 slot 不变,工程上好接。
📊 50 宽 beam 里只有 5.2–11.9% 的长尾目标进得来,beam 加宽 50% 在 I&S 和 Office 只多进 66 和 63 个,命中的长尾目标变化是 −1 和 +1。
📈 补 25 个共现长尾候选进池后,新进 98–159 个长尾目标,但纯 likelihood 只把 0、9、6、0 个排进 top-10——排序这一步确实在二次遗忘。
✅ CAPE 在四个设置里长尾 HR@10 比 backbone 高 2.5–13.3 个点,比用同一候选集的最强 re-ranker 高 1.6–7.3 个点;整体 HR@10 在 I&S 持平、另外三个更高,额外延迟 11–16%。
要跟的话,跟它“检索和排序必须一起修”的诊断框架,单修一边在两个设置里长尾准确率原地不动。落地前先看两件事:共现统计来自训练交互,冷启 item 的共现证据天然稀薄,长尾里最尾那段可能拿不到收益;λ 按验证集选,别拿线上直接试。评估时把长尾 recall 和整体 HR@10 放在一起看,别只报一个。
原文:AlphaXiv