小红书精读:Progressive Learning from Content to Relevance to Personalization for CTR Prediction
别把图片塞成向量了,切成30个token更管用
各位算法同学们,多模态CTR最反直觉的一点:把图片编码成一个768维稠密向量加入ID网络,效果常常还不如不加。FineSID的做法是别塞向量,把图切成30个离散token当ID用。
📄 Progressive Learning from Content to Relevance to Personalization for CTR Prediction
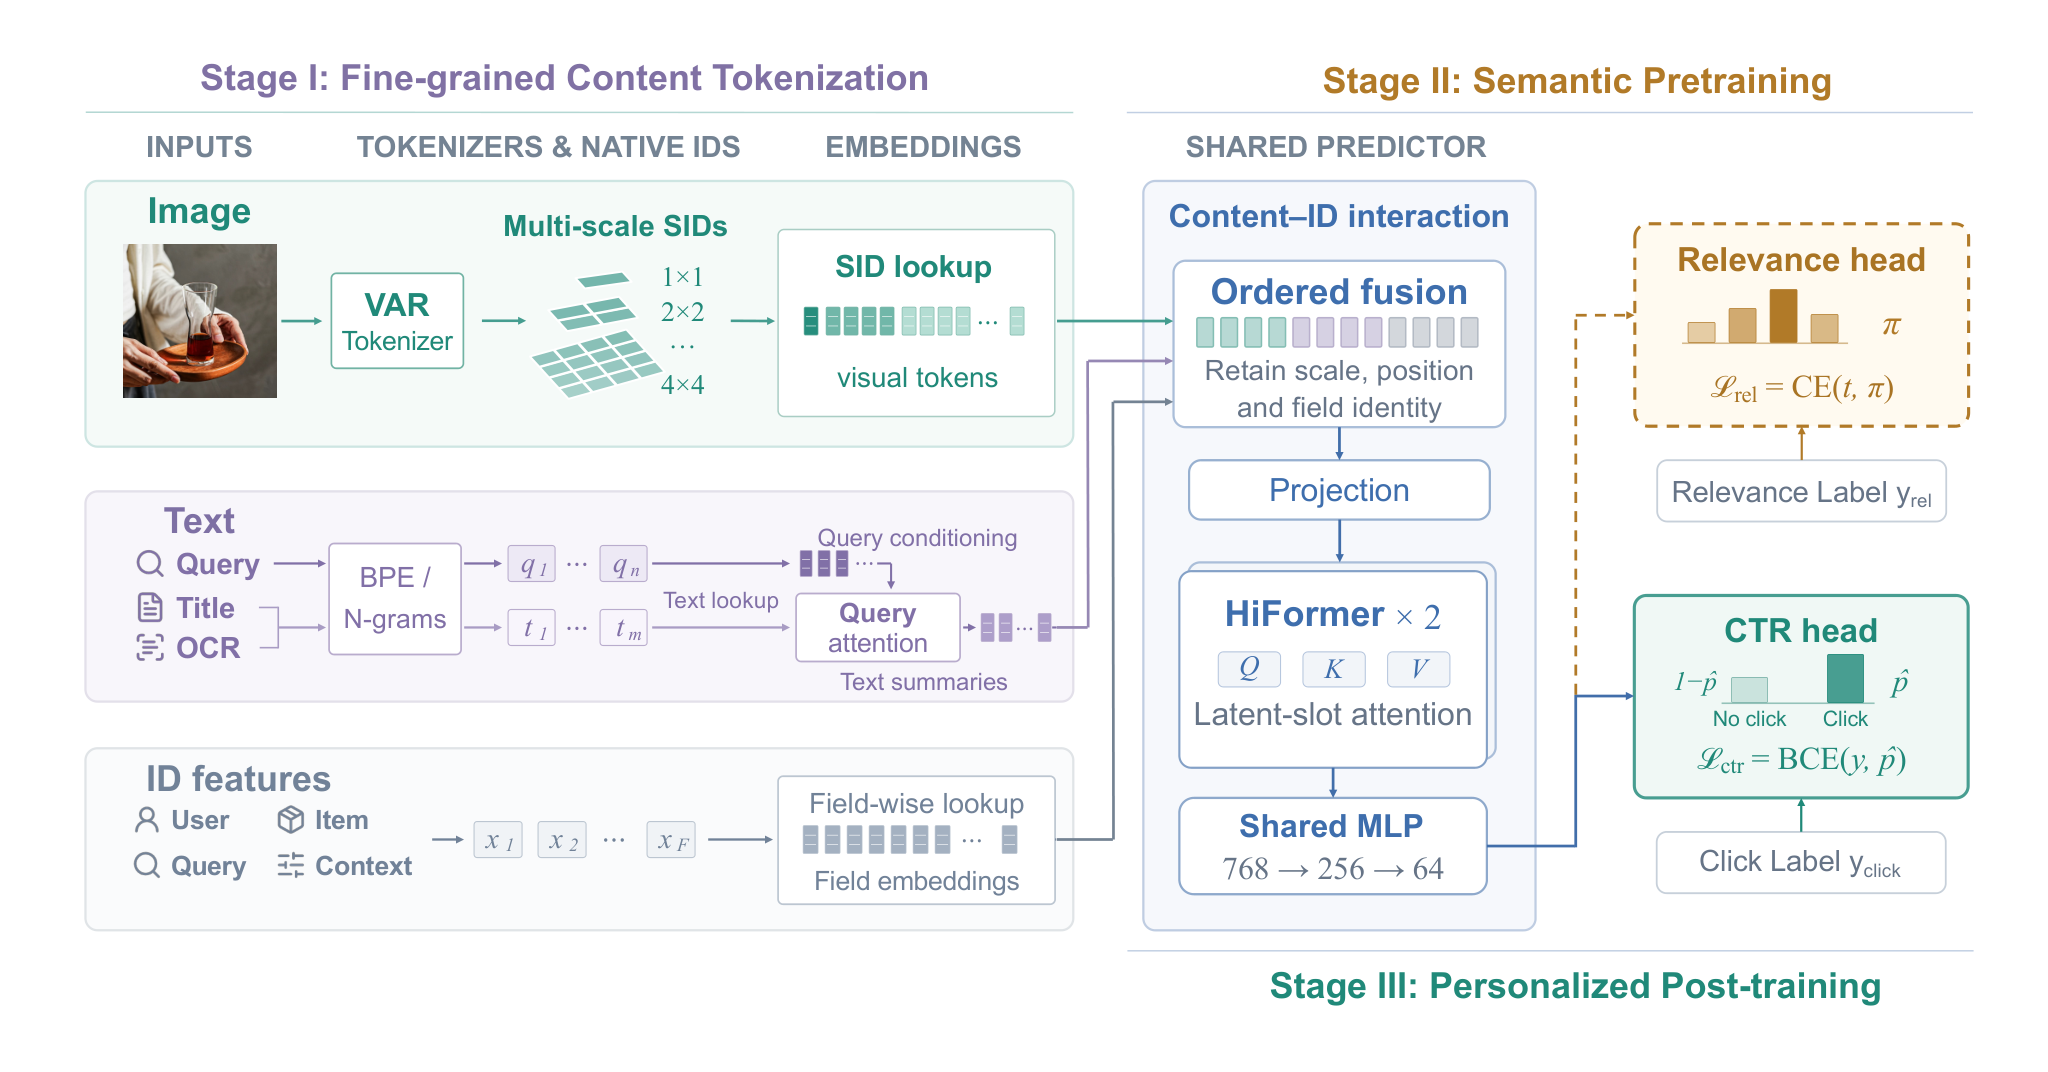
🔧 内容做离散化而不是压缩:用预训练VAR多尺度视觉tokenizer,在1×1、2×2、3×3、4×4四个尺度上取码,共30个带空间位置的SID,和类目ID共用同一套lookup接口,直接进特征交互;码在离线抽好,线上不用跑自回归生成,也就没有额外延迟。
🧩 文本也保留字段身份:query、标题、OCR各自独立tokenize(BPE/ngram),不压成一条摘要向量;再以query为Q做cross-attention拿到query-conditioned表示,按固定顺序和ID特征拼接,尺度和字段位置都不丢。
⚙️ 训练拆三段而不是端到端硬拼:先在query-item相关性监督下全参数预训练共享predictor(HiFormer潜槽注意力+768→256→64 MLP),再用点击label微调同一套参数,相关性先验不用重学。
📊 淘宝工业数据加公开MMCTR,AUC和GAUC相对baseline一致提升,冷启item上提升更明显。
📈 NSCTR指标看同商品不同创意的区分度(item ID完全一样,只变内容),说明模型真的学到了内容差异,不只是背ID。
✅ 线上A/B:点击和GMV均为正向。具体百分点摘要没写,得翻正文表格。
总结感想:这套方法真正的门槛在tokenizer的离线供给和SID与ID特征的embedding对齐,不在模型结构。评估要盯SID覆盖率、冷启占比和NSCTR这类同质样本指标,别只看大盘AUC。ID稀疏、创意更新快的场景值得跟;ID特征本来就稠密、内容同质的场景,收益大概率被稀释。
原文:AlphaXiv