小红书精读:KuaFu: Compressing Long User Behavior into Understanding at Billion Scale
用户行为只编码一次,省下190张GPU
各位算法同学们,同一个用户的历史行为,广告、推荐、画像几个任务各自从头编码一遍,十亿用户规模下这就是纯纯的重复劳动。KuaFu 的做法是把编码单位从「用户」挪到「行为 item」:一条内容只编码一次,谁要用,谁就去缓存里取。
📄 KuaFu: Compressing Long User Behavior into Understanding at Billion Scale
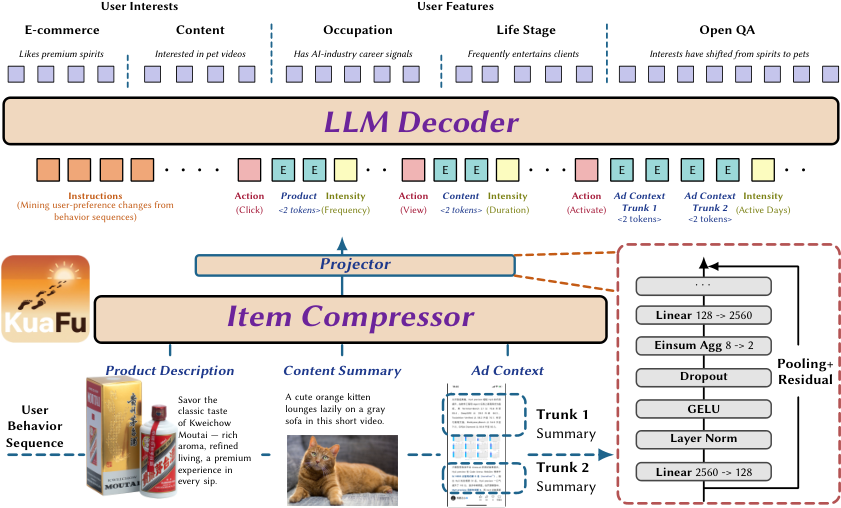
🔧 表示的基本单位从 user-level 换成 item-level:每个行为 item 独立编码成可复用的压缩表示,按时间顺序拼起来就是用户历史;新行为来了只增量追加,不用重算整条序列。
🧩 两轴 projector 是省钱的关键:token 轴把行为序列缩短最多 15 倍,单个 item 从 150KB 压到 10KB;width 轴再把缓存表示压到 0.5KB。
⚙️ 四阶段训练:重建预训练、偏好理解后训练、压缩-生成联合训练、幻觉感知强化学习,专门针对压缩里常见的编造、遗漏、时序错位、推理断裂四类失效做惩罚。
📊 六个 MRQA 加五个 RecBench 基准,在同等压缩比下稳定超过已有压缩方法,最高提升 17.7 EM 和 1.90 AUC。
📈 在腾讯广告推荐平台线上跑了十个月:单 GPU 吞吐最高提升 350%,省下 190 张 GPU,整体 GMV 涨 1.37%。
✅ 另一个细节是省卡和涨 GMV 同时发生,说明偏好信号没被压丢。
总结感想:这套思路对「多个下游任务重复编码同一份长序列」的工业团队最直接有用。评估时得盯压缩比和 EM/AUC 的联合曲线,别只看压缩率。坑在于四阶段加幻觉 RL 的训练成本不低,item 级缓存的时效一致性论文没细讲,接入前先小流量验证缓存刷新延迟和对新 item 的冷启动表现。
原文:AlphaXiv