小红书精读:RecSoup: Efficient Model Merging Approach for Controllable Multi-Objective Recommendation
多目标推荐不重训,推理快两百倍
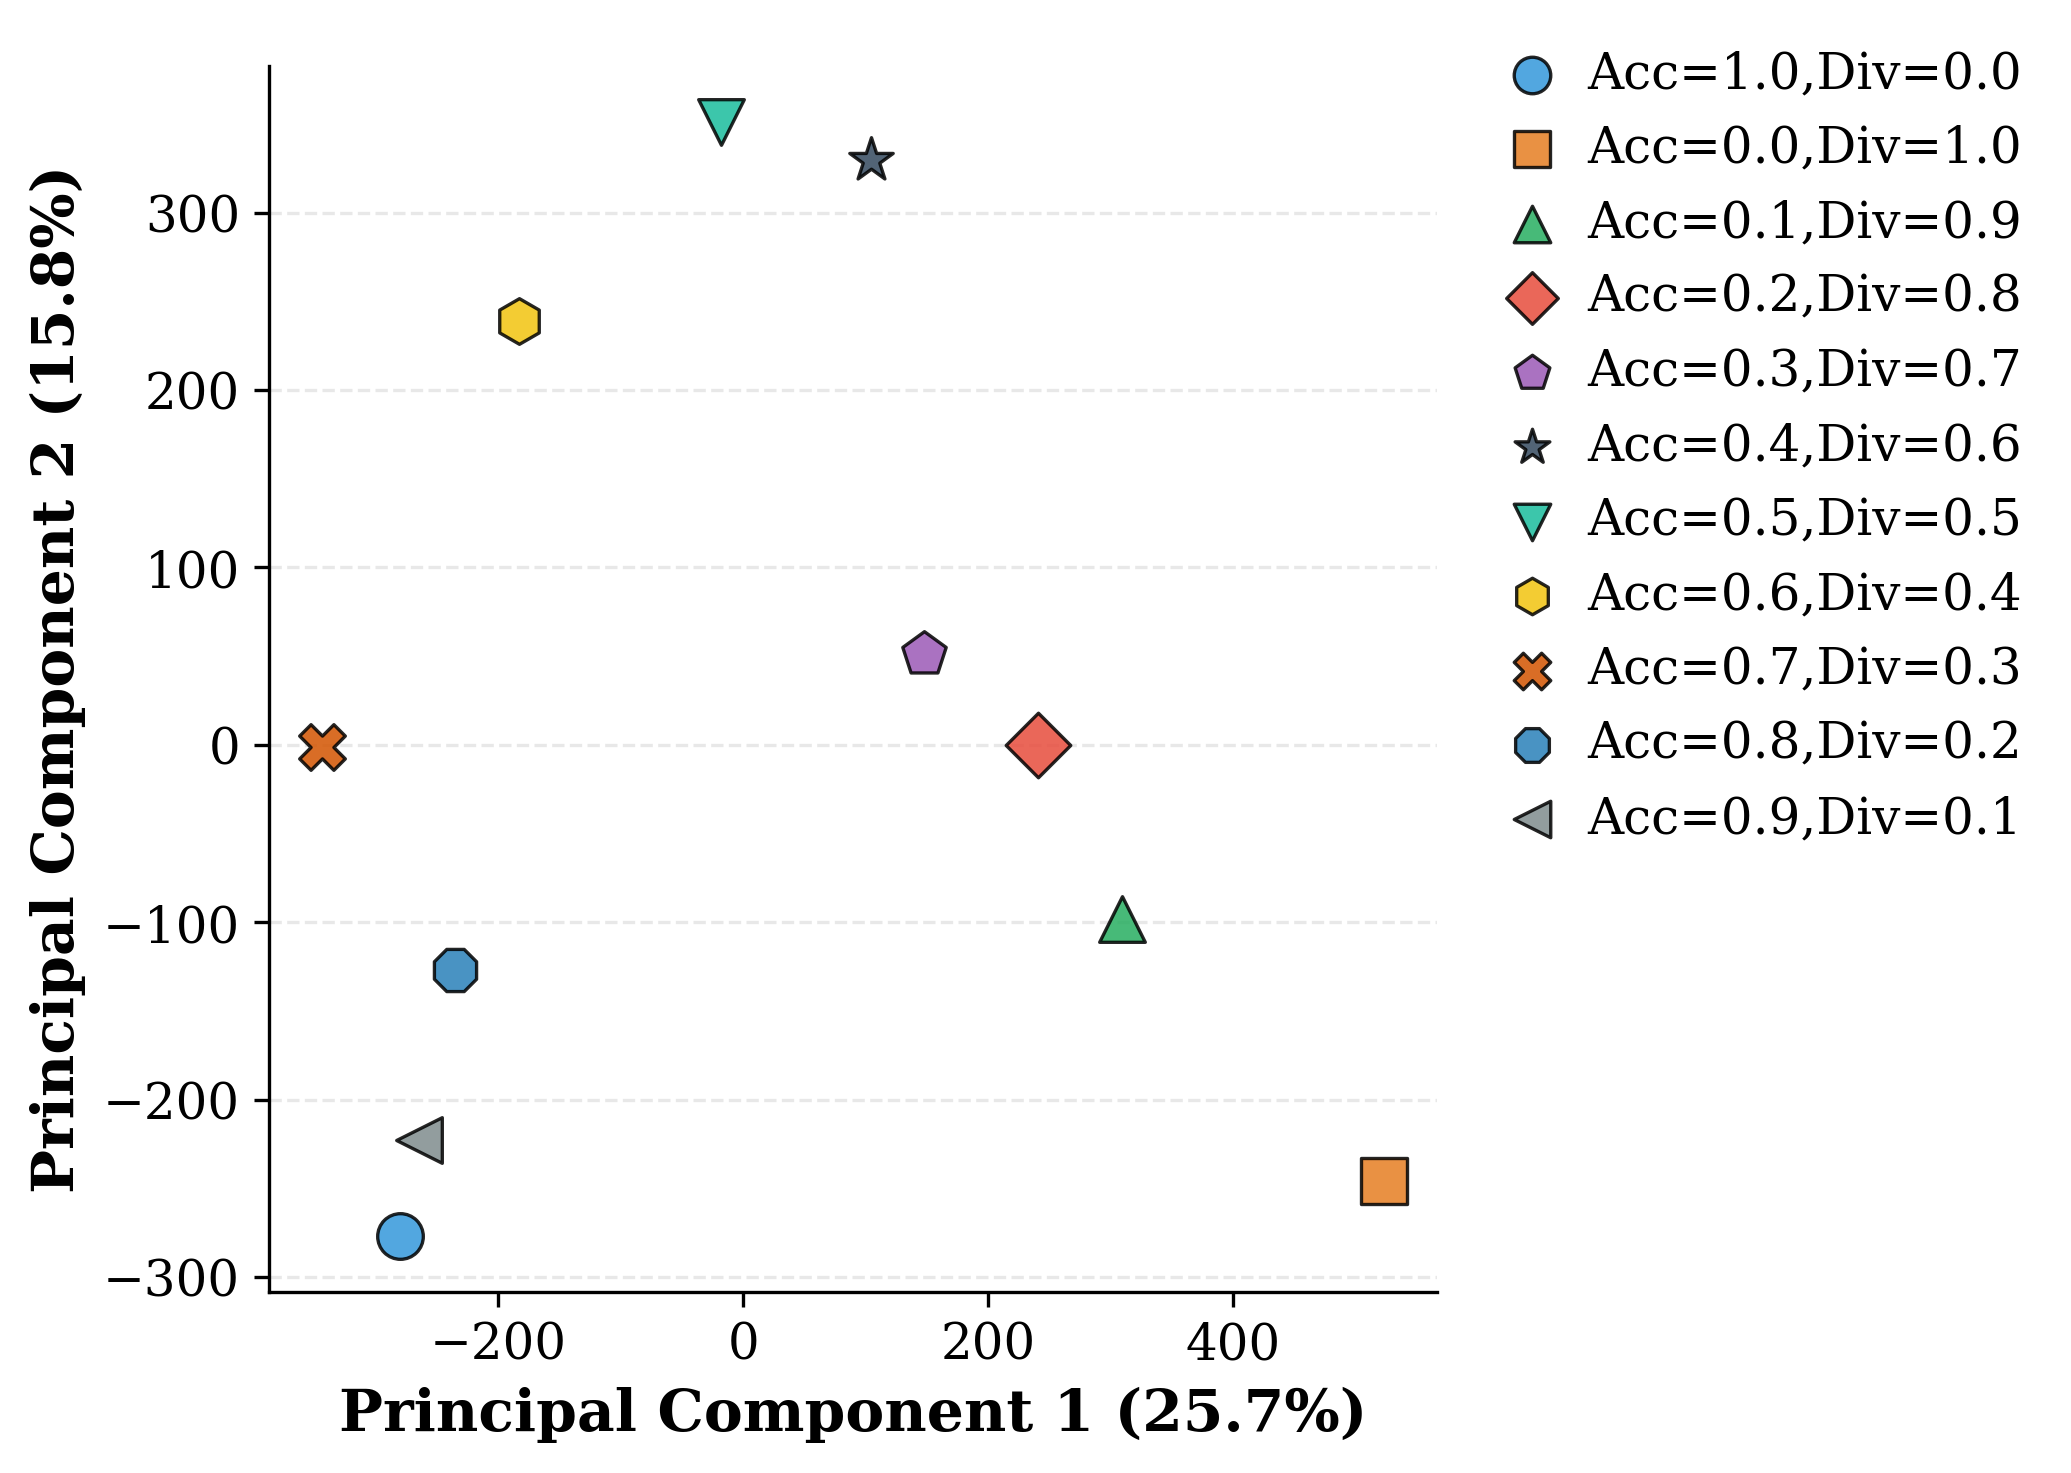
各位算法同学们,如果告诉你:推理时想调准确率和多样性的权重,不用重训、不用额外生成网络,只是换一组“合并系数”就行,你会不会先怀疑效果?这篇把模型合并搬进可控多目标推荐,最反直觉的一点是——精度和多样性的task vector根本不在同一个线性区(PCA前两主成分只解释25.7%和15.8%方差),所以它没有硬做线性插值。
📄 RecSoup: Efficient Model Merging Approach for Controllable Multi-Objective Recommendation
🔧 两阶段框架,先把“打架”的参数挑掉再合并:剪枝准则同时看目标内重要性和跨目标相关性,而不是只看参数幅值,给后续合并在参数空间里留一个冲突更少的底座。
🧩 第二阶段放弃线性插值,学一个偏好向量到合并系数的映射,推理时按用户偏好实时算出λ,模型参数写成base加各项加权task vector,不需要联合重训,也不需要hypernetwork或扩散模块来生成参数。
⚙️ 附带一个理论结论:在不加平滑性约束的前提下,模型合并能走遍整个帕累托前沿,因此在有效性和效率上都优于参数生成范式,这解释了为什么它不用生成模块也能控得住权衡。
📊 推理时延比参数生成类方法快165到228倍,这个量级差主要来自省掉了生成模块的前向开销。
📈 在多个benchmark上帕累托前沿质量优于现有基线,同时可控性与SOTA方法相当,说明快并没有换来前沿质量的明显退化。
✅ 剪枝策略是模块化的,可以接进已有的动态合并机制里一起用,不一定绑定它的系数映射。
总结感想:如果你在做多目标排序,且训练管线里本来就存着一堆目标专精的checkpoint,这套“复用而不是重建”的思路落地成本最低。要盯的指标有三个:帕累托前沿的超体积、偏好权重变化时对应指标是否单调响应、以及剪枝比例对精度的折损曲线。坑在于系数映射是学出来的,真实偏好一旦漂出训练分布,控制可能就不线性了,论文里还是离线benchmark的验证,线上偏好漂移得自己补实验。
原文:AlphaXiv