小红书精读:MAPS: A Multi-Agent Personalized Script-Driven Video Advertising System Enhanced by Reinforcement Learning
视频广告不检索了,改成让模型现写脚本
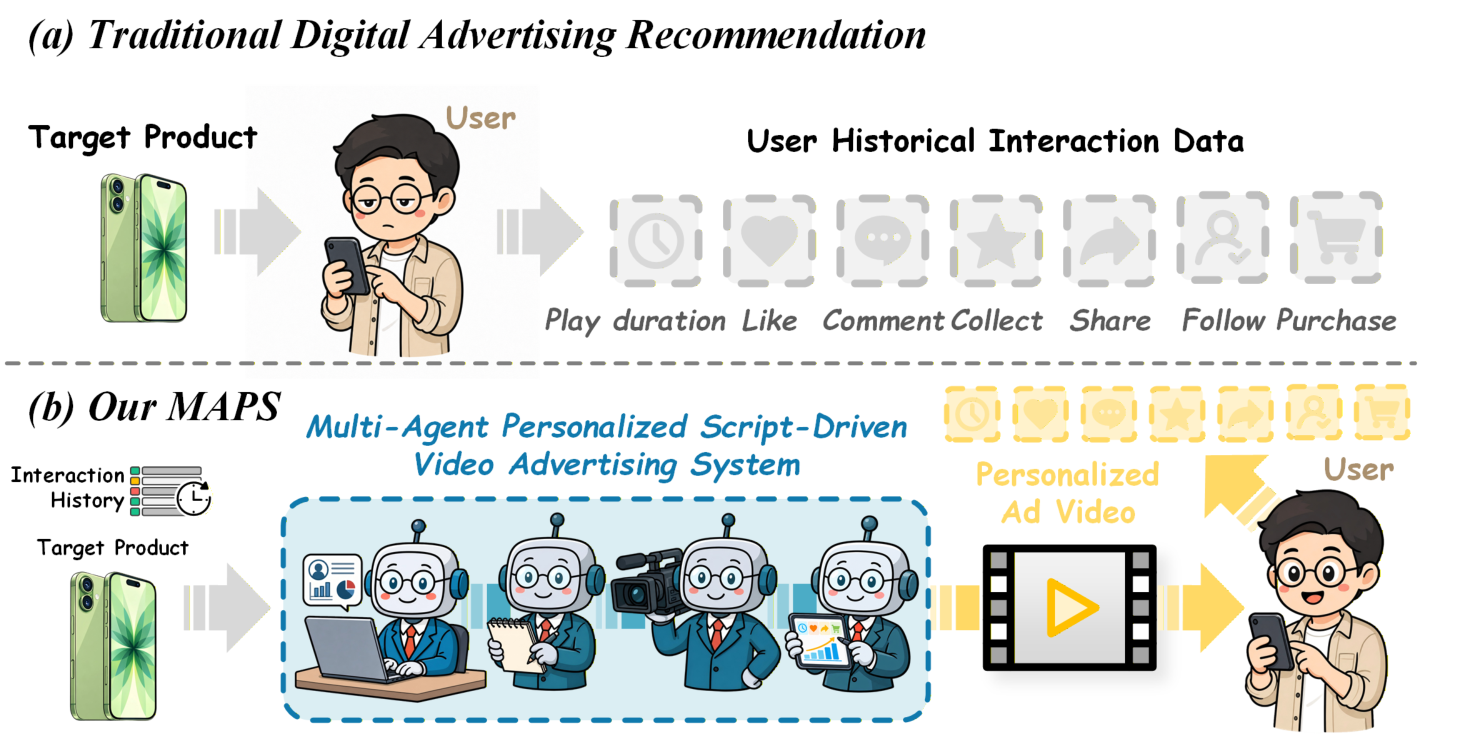
各位算法同学们,视频广告一直被“创意库存”卡着脖子:投放端只有预先拍好的一批素材,用户偏好天天变,也只能等下一轮生产。这篇工作干脆把检索换成生成,脚本由模型写、视频由脚本合成,快手线上 ARPU 提了 9.85%。
📄 MAPS: A Multi-Agent Personalized Script-Driven Video Advertising System Enhanced by Reinforcement Learning
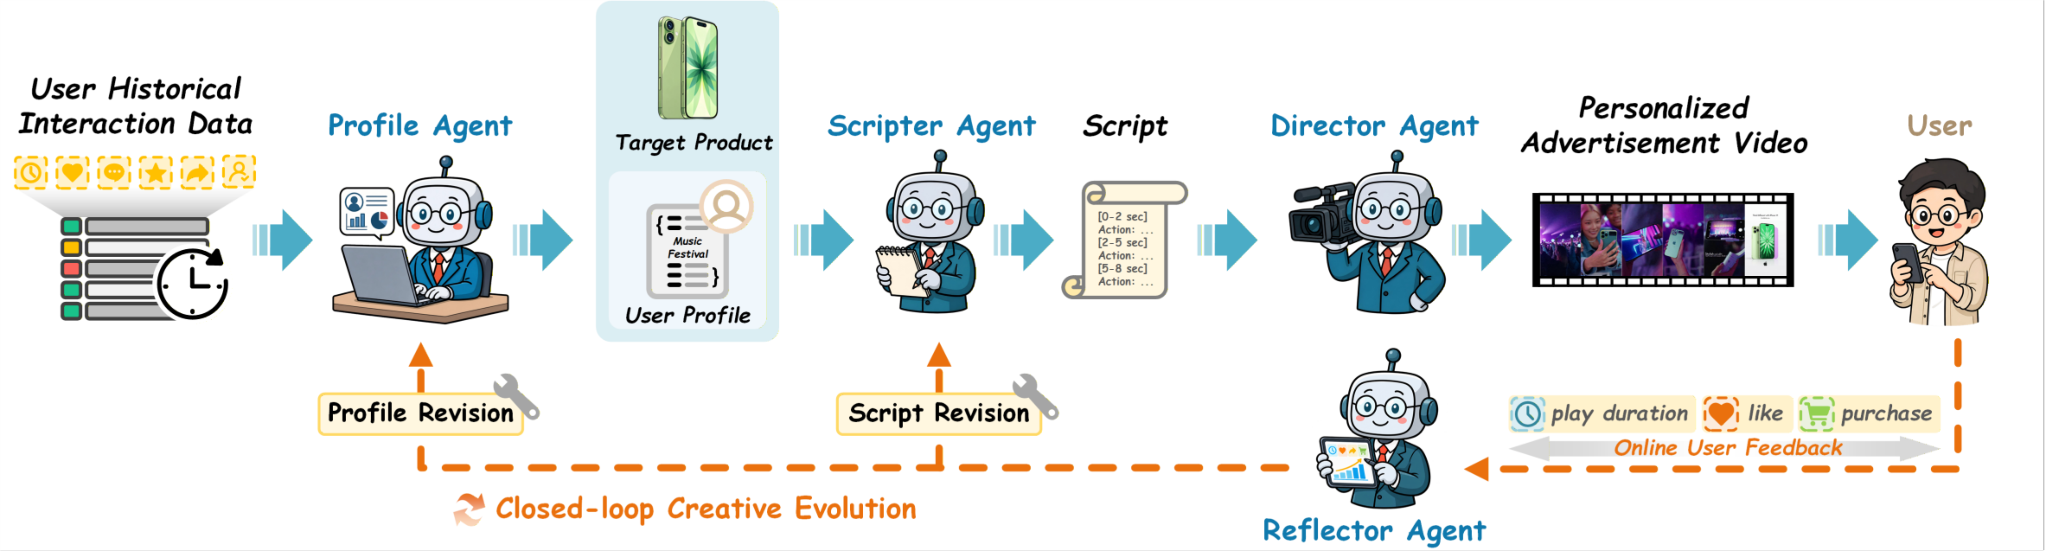
🔧 四个 Agent 串成闭环:Profile 建用户画像(兴趣主题、表达风格、隐性需求、决策倾向四个维度),Scripter 写分镜脚本,Director 合成视频,Reflector 把线上反馈归因到画像层和脚本层再回传,投放后还能继续迭代。
🧩 脚本被当成“中间接口”:它同时承载用户画像和商品卖点,比直接生成视频好控,也比检索素材粒度更细,等于把离散库换成了连续创意空间。
⚙️ Scripter 用 GRPO 训练,配多维奖励函数,一头管输出结构规范,一头管用户偏好对齐和商品信息忠实度,两个目标直接写进 reward。
📊 线上 A/B(快手某场景,对比生成式 baseline):CTR +2.87%,CVR +2.74%,ARPU +9.85%。
📈 离线在两类代表性任务上验证了画像拟合和生成创意质量,但主要是自证,别当硬指标看。
✅ ARPU 的提升幅度最大,说明收益不只来自点击率,还来自创意与商品卖点的匹配度。
总结:想真落地,先盯 Reflector 的归因链路是否可靠,反馈噪声大的场景里错误归因会把画像带偏;和纯检索方案比,它的上限取决于脚本生成质量,而不是候选池大小。做广告创意生成、多智能体编排的同学可以跟,但重点看它的奖励函数怎么防 reward hacking。
原文:AlphaXiv