小红书精读:Personalized LLM Recommendation with Semantic IDs: Autoregressive Beam Search vs. Multi-Token Prediction
MTP没赢,beam search更省
各位算法同学们,先给结论:并行解码听起来更高级,但在真实产品指标上,老老实实的约束 beam search 反而比 MTP 表现更好。这篇 Netflix 团队的工作在同一个 Qwen3-8B 级多任务模型上,做了规模相近、条件一致的产业级对比。
📄 Personalized LLM Recommendation with Semantic IDs: Autoregressive Beam Search vs. Multi-Token Prediction
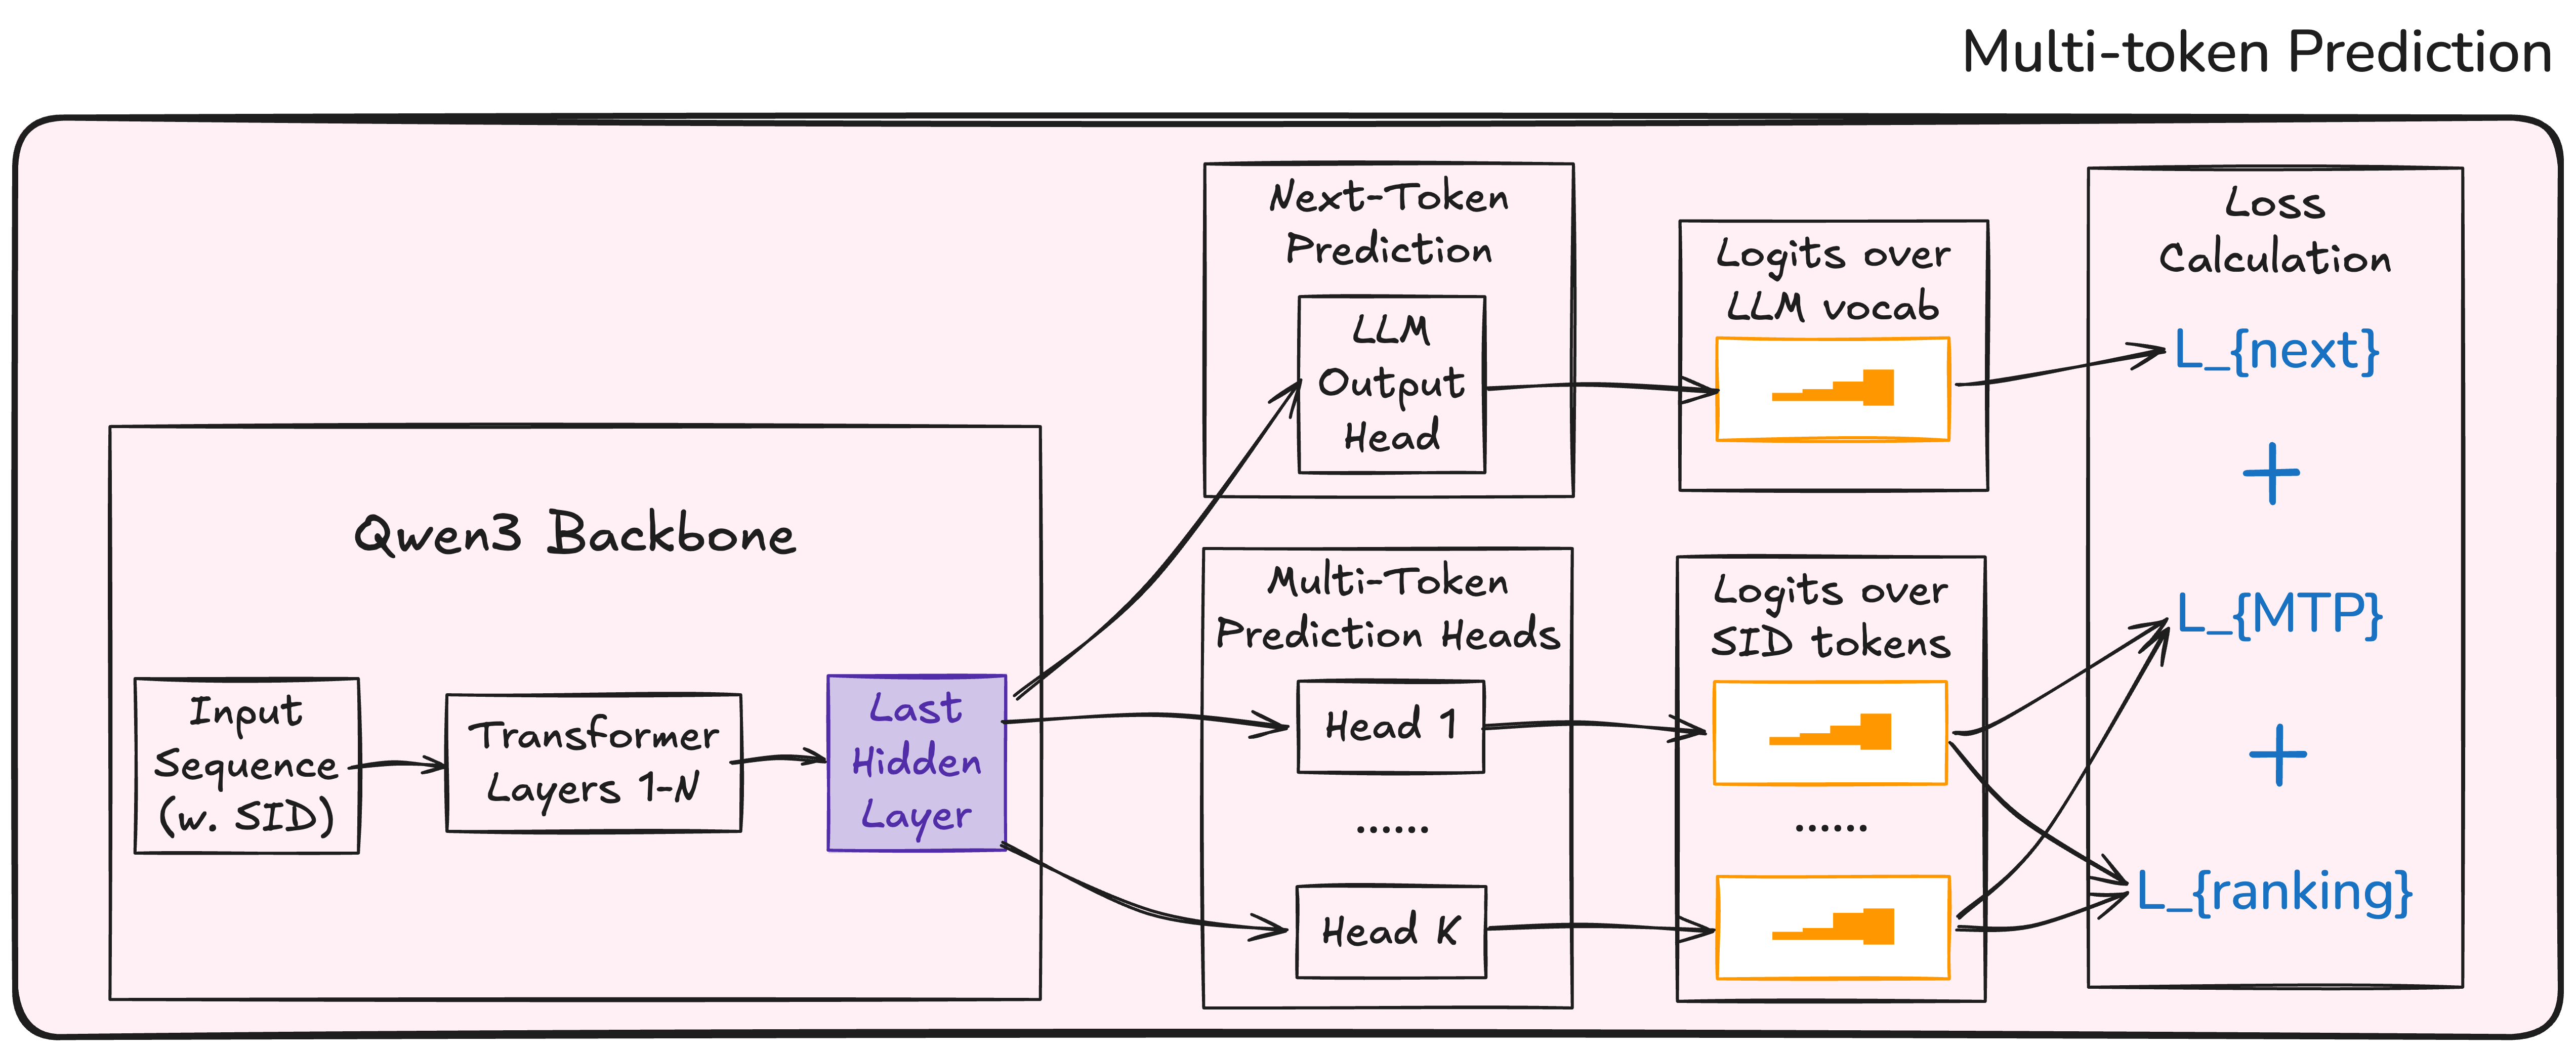
🔧 把 SID(残差量化出的分层内容码,实验用 1024×4)直接加入通用指令微调 LLM 的词表;同一个 LM 头同时完成个性化召回、内容问答和指令跟随,省掉与目录规模相当的大分类头,新品只靠内容就能拿到有意义的 SID。 🧩 点出 MTP 的核心问题:L 个并行头各自计算每个码的边缘概率,从不优化 item 级联合分,于是“每一层码单看都合理”的错误 item 能压过真目标。 ⚙️ 定义在联合 SID 分数上的辅助排序损失(sampled softmax)补上这一环,让并行头输出可比较、可排序的分数;推理侧在 vLLM 上做 trie+目录约束的 beam search,并用前缀缓存复用长历史 KV。
📊 同模型规模、同数据下,单头 beam search 在排序和内容 QA 上稳定优于 MTP,训练 dollar cost 约为其 1/2.6。 📈 MTP 只在原始推理吞吐上赢,特点是快,但排序不准。 ✅ 对比上一版带辅助排序头、不使用 SID 的基线:新品冷启动排序 +77%,内容 QA 准确率 +22%,训练快 2.8 倍。 ⚠️ 语言指标出现回退,作者定位为 SID 词表扩张导致,并用 RL 后训练补回。
总结感想:做生成式召回、正纠结要不要换 MTP 的同学,先别急着换:先拿排序和内容 QA 两个指标跟 beam search 对照测试,并把训练 dollar cost 和线上吞吐分开核算。两个潜在的坑:MTP 的并行独立假设必须靠额外排序损失补,且 SID 词表扩张会拉低语言能力,得有后训练手段作为保障。
原文:AlphaXiv