小红书精读:TransX Technical Report: Scaling Sequence Transduction for Recommendation
算力堆5倍,线上成本反降80%
各位算法同学们,先甩个反常识结论:把推荐模型每请求算力堆到基线的5倍,线上总服务成本还能降近80%。TransX这篇技术报告的重点不在结构多花哨,而在回答两个问题——算力该加在哪个组件上,以及这些计算到底该多久跑一次。
📄 TransX Technical Report: Scaling Sequence Transduction for Recommendation
🔧 模型拆成三个可独立扩容的角色:序列编码、行为记忆、候选条件融合。编码只看行为流不看候选,所以重叠前缀的算力可以复用;行为记忆是有界的全局加局部表示,让“记忆分辨率”变成一个独立旋钮,而不是靠堆长序列硬解。
🧩 训练侧多前缀 seq-to-seq:一条轨迹的所有前缀共享一次因果编码,同一前缀下的候选 fanout 共享一份 event state,历史相关计算不再随请求数和候选数重复。配套的序列-fanout 并行把这条路径真正跑满。
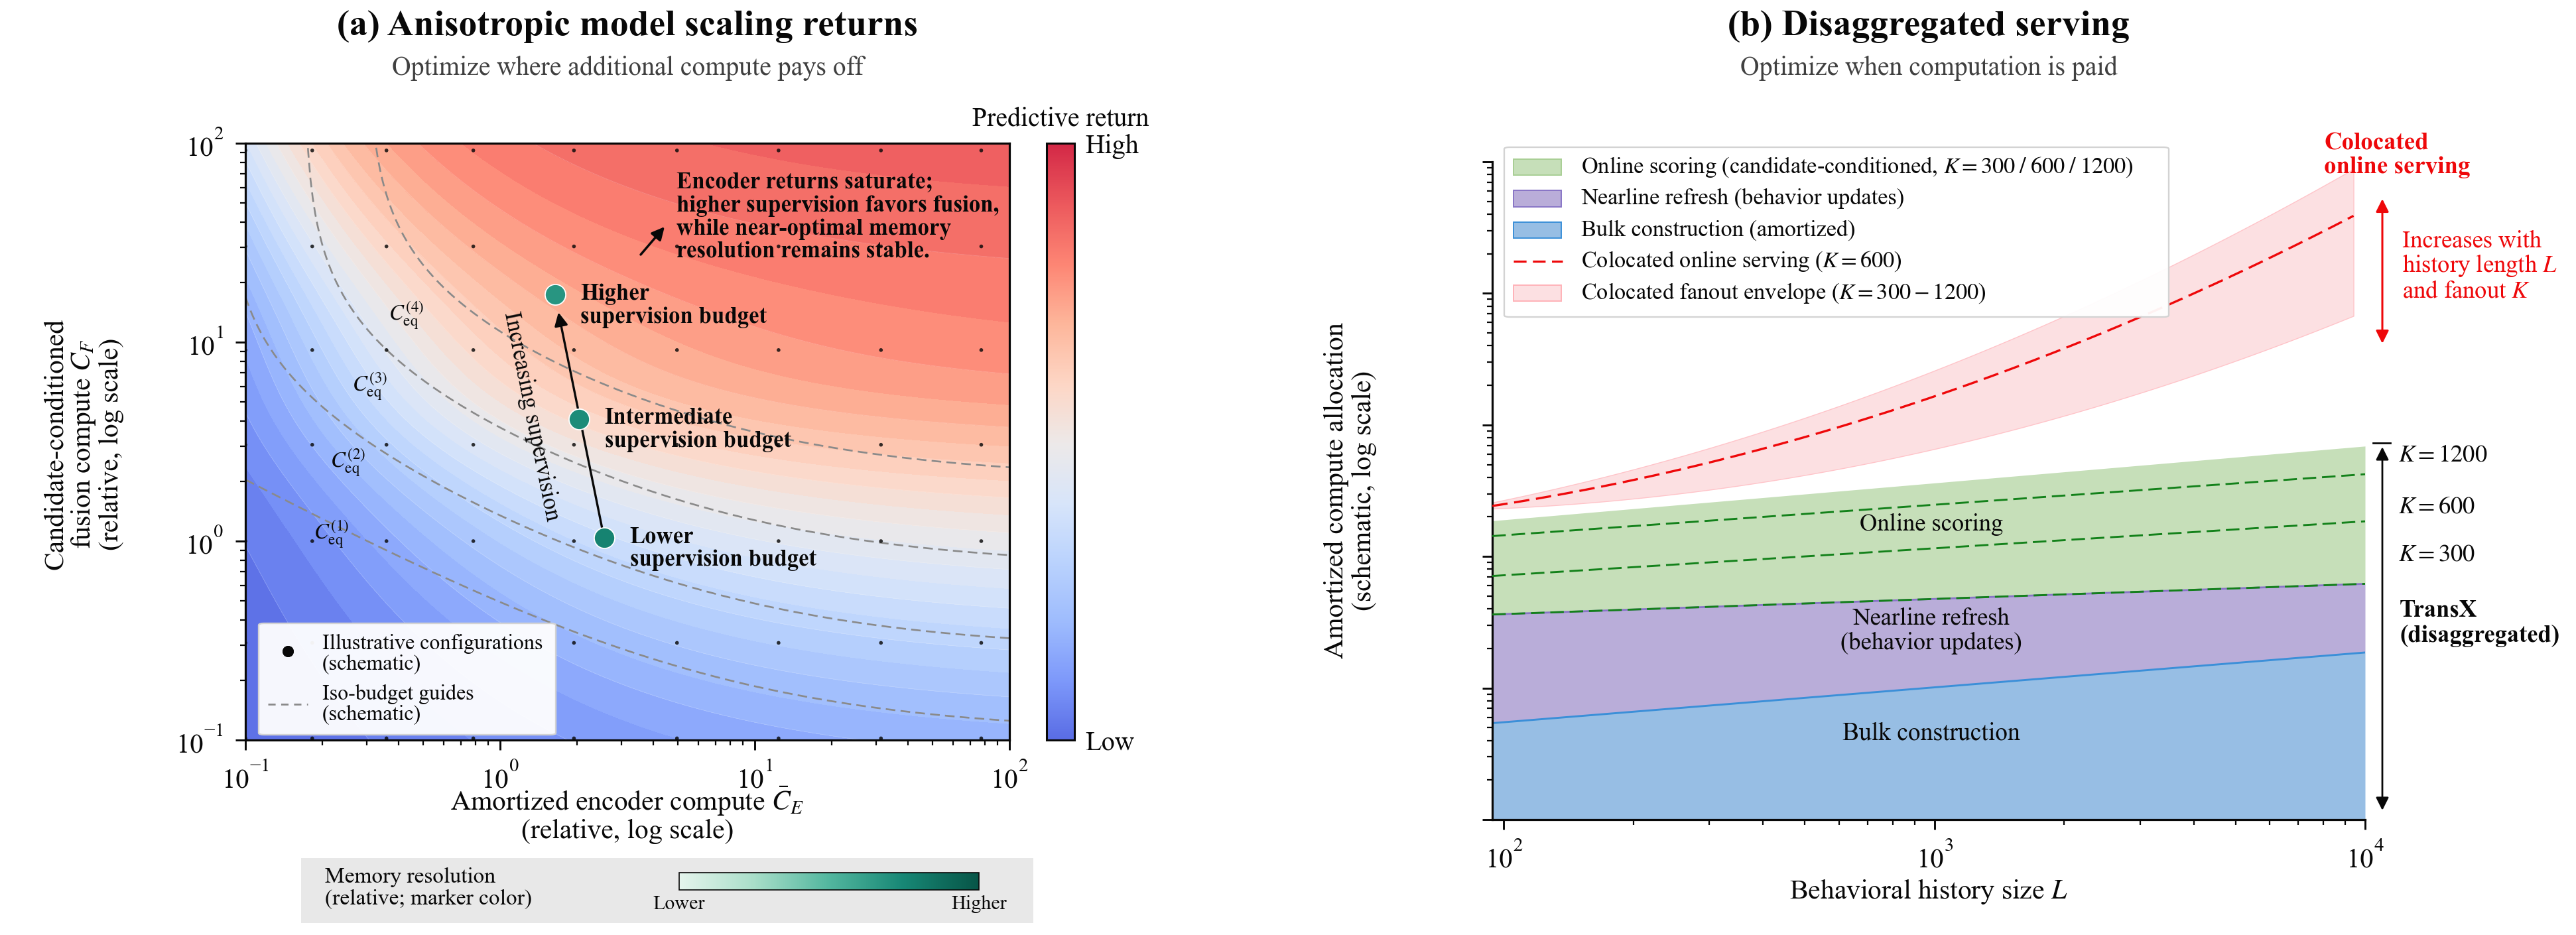
⚙️ 服务侧拆开执行:离线 bulk prefill、近线增量刷新行为状态、在线只做 KV 读取加候选条件预测,KV 再做量化和分层驻留。在线路径因此不用背长历史,成本不再和模型容量线性绑定。
✅ 线上 A/B:核心模型 CTR +6.02%、转化 +4.45%;post-train 出的召回与偏好排序变体分别比各自基线 +2.96% CTR、+1.33% 转化。
📈 同等训练条件下,监督目标吞吐 +84%。
📊 拆分式服务在同流量同 SLO 下,总服务成本比一体部署降近 80%,同等成本可撑约 5 倍每请求 FLOPs;即使对齐每请求 FLOPs,单张 H200 的请求吞吐也约 4 倍。
🔍 更有意思的是扩容收益不均:固定融合容量时编码器加到中等深度就饱和;监督信号变多后,验证集选出的预算会往候选融合那边挪;而保住质量所需的记忆分辨率几乎不随模型变大而上涨。
总结感想:能直接抄的是“扩容前先量各组件边际收益”这个动作,别默认所有层一起加。落地时要盯两个指标——每请求 FLOPs 下的单位成本吞吐,以及行为记忆 KV 的驻留命中率与刷新延迟。坑在于这套东西强依赖离线加近线管线的成熟度,状态刷新滞后会伤时效性特征,行为稀疏或冷启动场景的收益要打折看。
原文:AlphaXiv