小红书精读:HASTE: Hierarchical and Attribute-aware Supervision for Generative Recommendation
生成式推荐换个损失,收敛快2倍
各位算法同学们,同一个backbone、同一份数据,只把损失从flat cross-entropy换成带层级感知的版本,收敛速度就能快约2倍——更反直觉的是,flat CE不只是没利用SID的层级结构,它在主动破坏这个结构。这篇工作给生成式推荐的训练目标动了台小手术,换来的是长尾效果和训练效率两头受益。
📄 HASTE: Hierarchical and Attribute-aware Supervision for Generative Recommendation
🔧 Hierarchical Loss:不再把SID当成一串扁平token,而是按残差量化的层级逐层给监督。粗层给更大的基础权重(4/3/2/1),细层权重再用模型对上游code的置信度(detach过的)做门控,并且从最初的静态权重退火到条件门控,再加scheduled sampling扰动前缀,缩小训练和推理之间的曝光差距。
🧩 Attribute-Specific Losses:在最细SID那一步的隐状态上挂两个轻量MLP头,分别回归CIELAB颜色和材质成分,用Huber loss,目标从类目属性聚合而来,并按item频次加权,把监督刻意往尾部item上压。
⚙️ 两个损失都是加在现有生成式推荐框架上的微调目标,不动tokenizer和主干网络,落地成本主要落在属性标注这条数据链上。
📊 Hierarchical Loss做到约2倍收敛加速,同时推荐质量持平或更好。
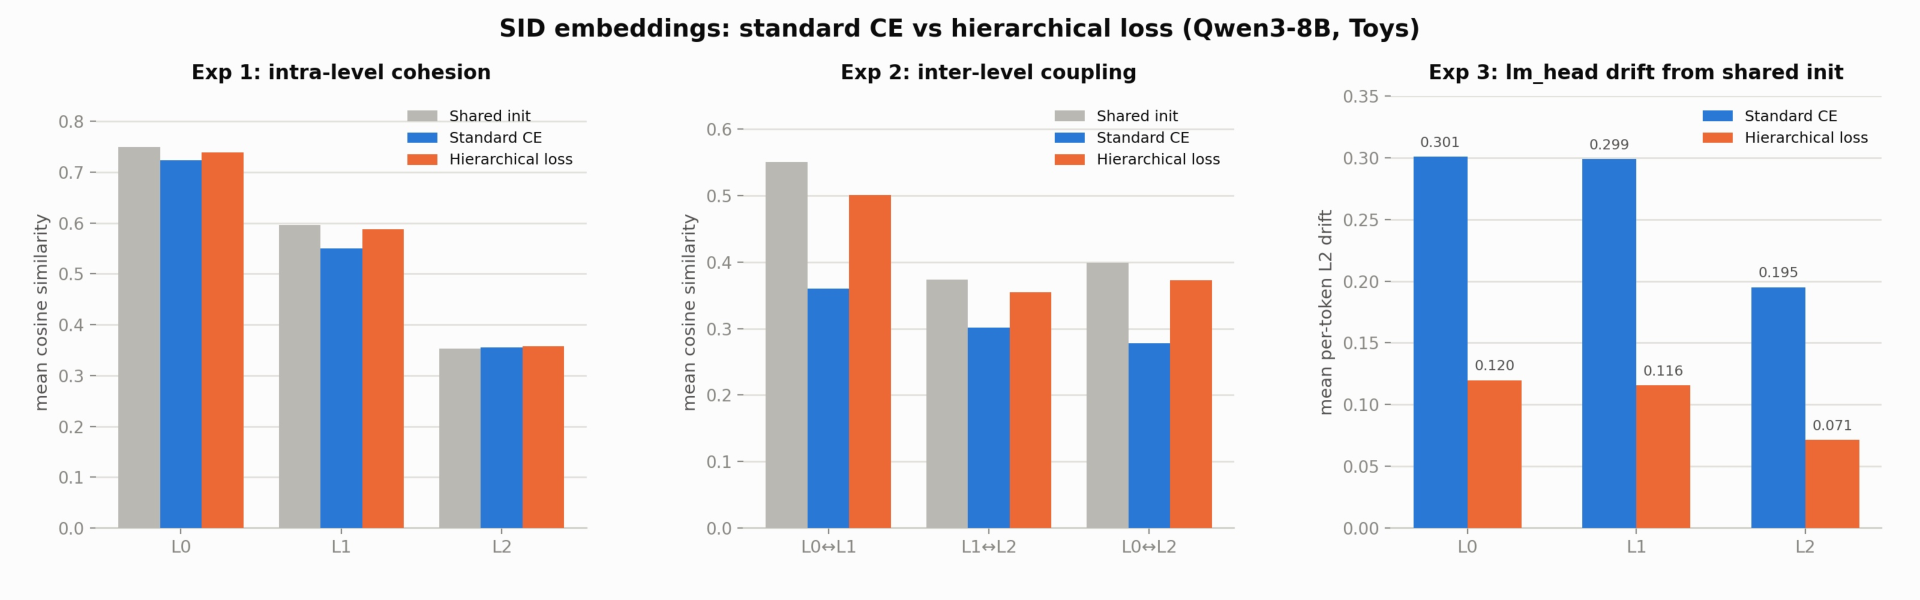
📈 flat CE微调后,相邻SID层的余弦耦合从0.55掉到0.36(-35%);层级损失只掉到0.50(-9%),embedding相对初始化的漂移也少2-4倍。
✅ 尾部颜色的top-1误差从54.5降到50.2,torso颜色从33.5降到29.0,head颜色基本不动(12.5到12.6),增益正好落在监督最弱的地方。
📉 评测覆盖Fashion-140k、Amazon三个子集(P5 5-core协议)和一个内部生产级时尚类目,跨数据集、跨item频次段都有提升。
如果你在做生成式召回、SID又恰好来自RQ-VAE或残差k-means这类层级码,这个损失可以直接在自己数据上试一版,改动小、风险可控。要盯的指标不只是整体Recall,而是分频段效果和达到同等质量所需的步数。坑在于属性监督依赖类目侧标注,属性缺失或噪声大的类目,辅助头可能把表示带偏;另外基线一定要用同backbone、同数据的flat CE,否则那2倍收敛很容易被别的东西吃掉。
原文:AlphaXiv