小红书精读:UniRec: Bridging the Expressive Gap between Generative and Discriminative Recommendation via Chain-of-Attribute
生成式推荐差在哪?这篇用属性链补上
| 各位算法同学们,生成式推荐一直被默认“表达力天生弱于判别式”,但这篇用贝叶斯定理说明:按 p(y | f,u) 排序等价于按 p(f | y,u) 排序,理论上两者上限一样,实际差距只来自特征覆盖不全。更狠的一个数字是,生产数据里 top 10% 的 (s0,s1) 组合吃掉了 87.9% 的曝光,SID 码本的流量集中比想象中严重得多。 |
📄 UniRec: Bridging the Expressive Gap between Generative and Discriminative Recommendation via Chain-of-Attribute(Shopee)
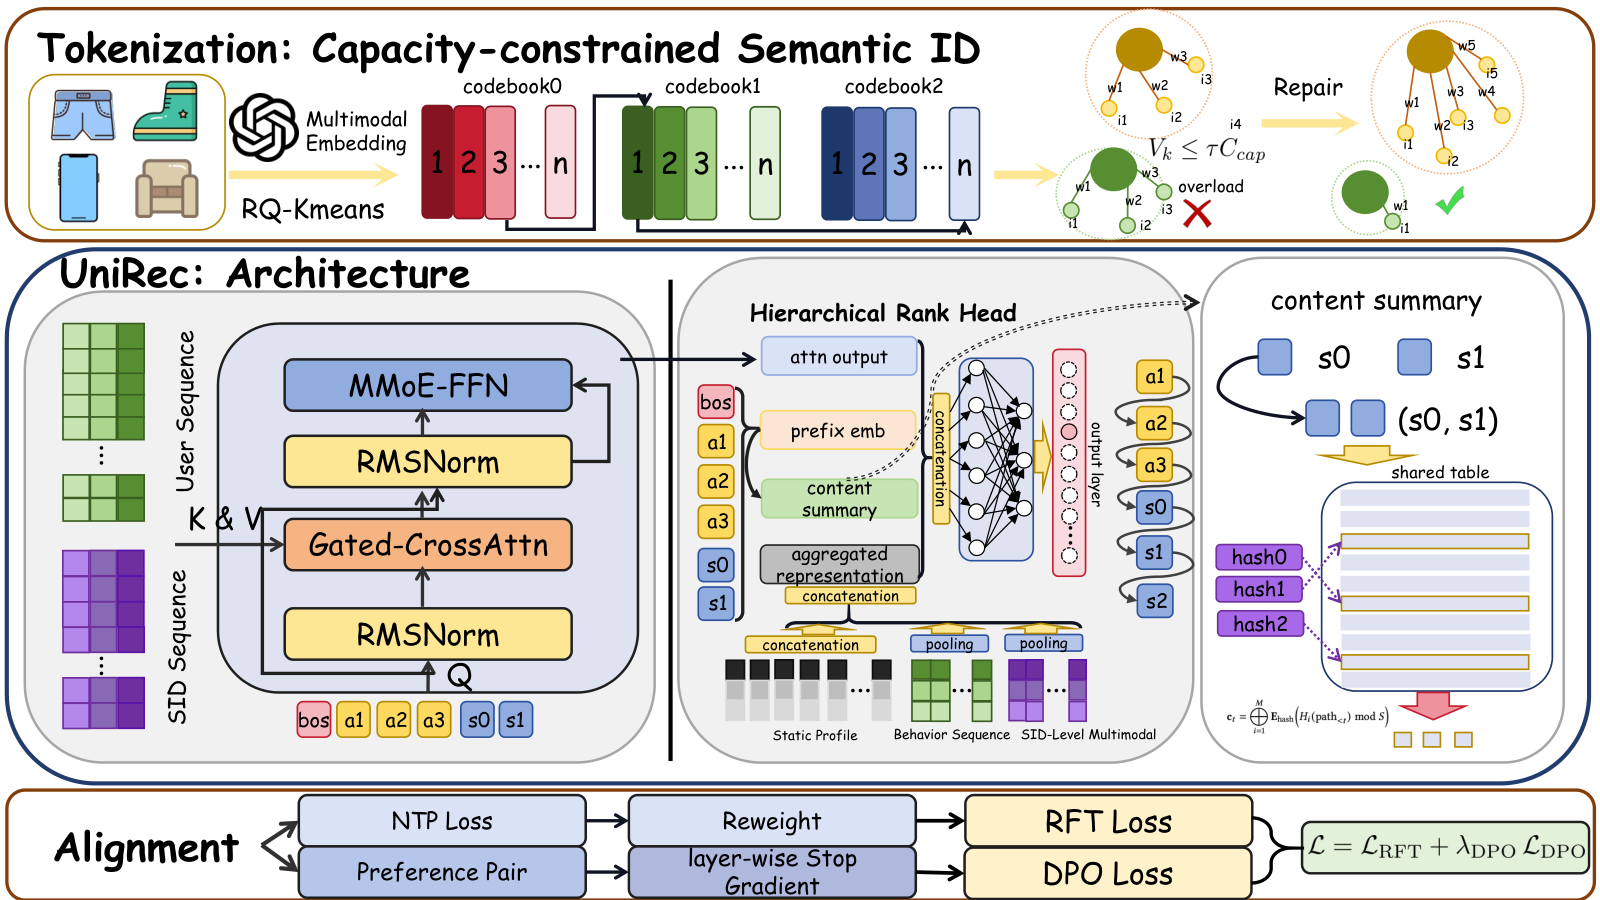
| 🔧 CoA(Chain-of-Attribute):在解码 SID 之前,先按顺序生成 category、seller、brand 这些结构化属性 token,把判别式模型靠特征交叉拿到的那部分 item 侧信号,重新塞回生成轨迹里。论文给出了每步条件熵下降 H(s_k | s<k,a) < H(s_k | s<k),搜索空间被压窄,beam search 轨迹更稳,端到端误差也被衰减。 |
🧩 Capacity-constrained SID:针对长尾流量,把曝光加权的容量惩罚加进残差量化,直接控制每个码本条目的流量负载,压住 token 塌缩和层级之间遗传的马太效应。前面那个 87.9% 就是它的动机——轻度的 item 数量不均衡,被放大成了 2.6 倍的流量集中。
⚙️ Conditional Decoding Context:Task-Conditioned BOS 负责注入场景信号,基于哈希的 Content Summary 负责注入组合特征,每个解码步都带上下文;再叠加 RFT 按连续业务价值重加权和 DPO 偏好对齐,把目标从分布拟合往业务指标上拉。
📊 离线整体 HR@50 相对最强 baseline 提升 22.6%,高价值订单样本上提升 15.5%。
📈 Shopee 线上 A/B:PVCTR +5.37%,orders +4.76%,GMV +5.60%。
✅ 论文自称是首个用信息论刻画生成式与判别式表达差距的工作,并证明 CoA 带来可度量的逐步熵下降。
🧠 做生成式推荐和 SID 的同学,方法部分建议精读,尤其 SID 码本塌缩和多场景统一模型这两个坑,它给的解法是工程可落地的。盯指标别只看 HR@50,高价值订单那一档和曝光分布的均匀度(码本条目负载熵)更能反映容量约束是否真的生效,线上则看 GMV 而不是只看 PVCTR。和 GRACE 相比,CoA 的差别在于给了理论解释而非经验设计,但代价是依赖属性字段质量:属性缺失或噪声大的类目,前缀反而会误导解码;CDC 的哈希摘要也要求场景划分相对稳定。如果你只服务单场景、item 属性又脏,这套的增益大概会打折。
原文:AlphaXiv