小红书精读:From Clicks to Intent: Cross-Platform Session Embeddings with LLM-Distilled Taxonomy for Financial Services Recommendations
把LLM意图蒸馏成64维向量
各位算法同学们,每次session都调一次LLM做意图标注,成本和延迟在金融这种高流量合规场景里根本扛不住。这篇的答案是把LLM的意图理解蒸馏进一个64维session embedding,推理时彻底不碰LLM。
📄 From Clicks to Intent: Cross-Platform Session Embeddings with LLM-Distilled Taxonomy for Financial Services Recommendations
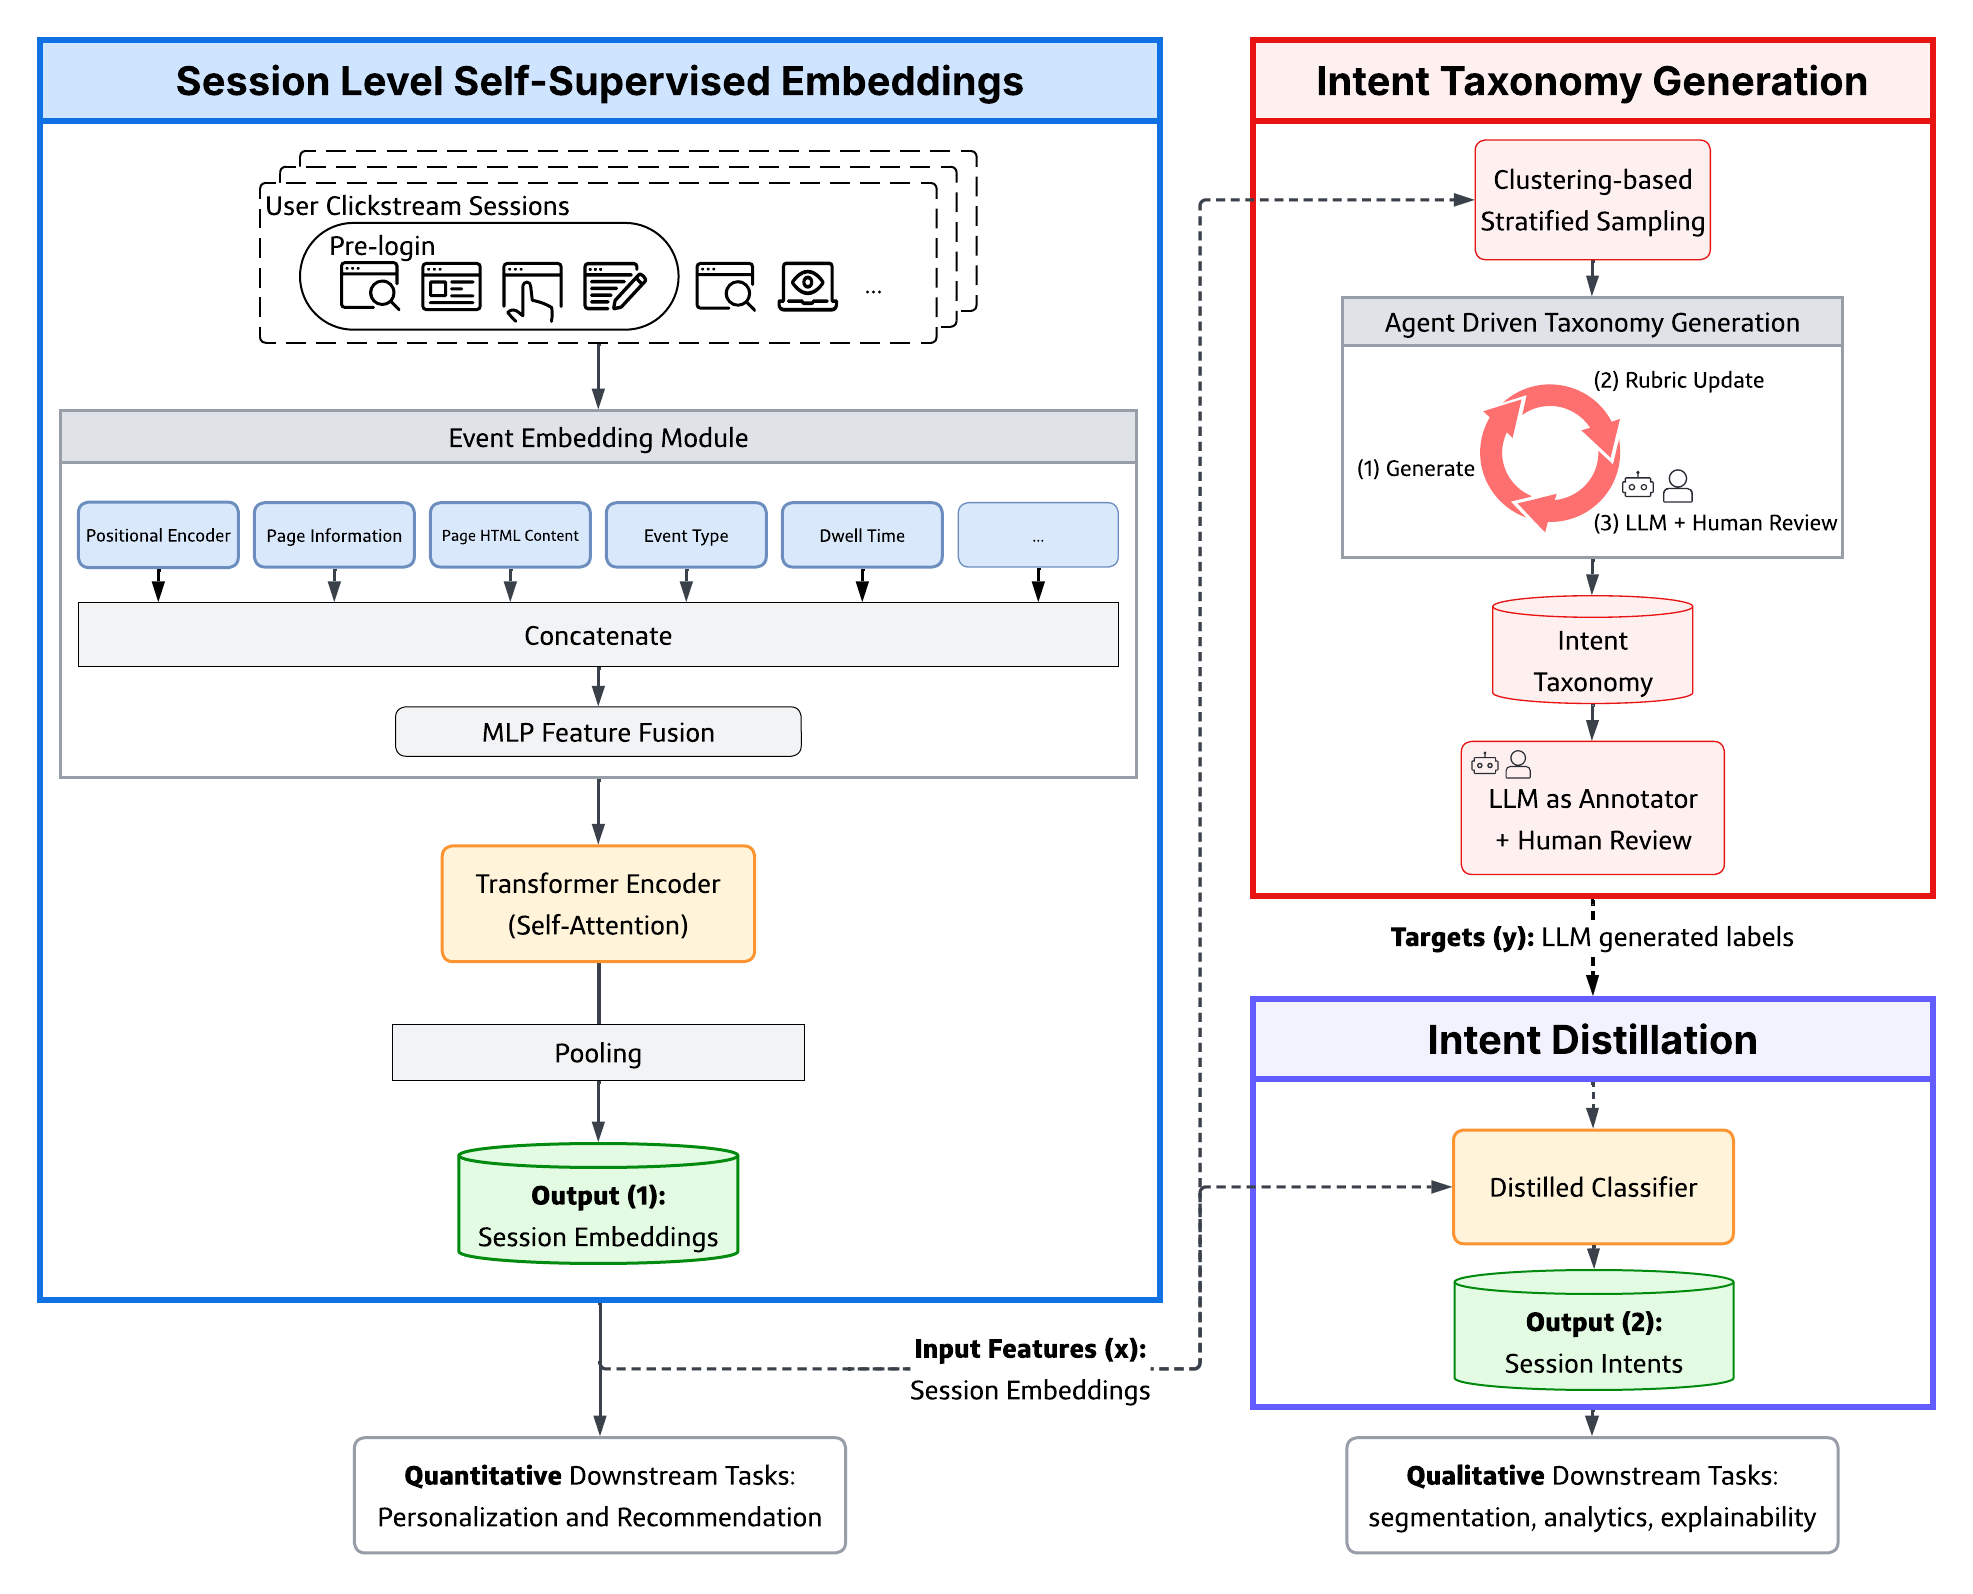
🔧 输入侧做多模态融合:离散特征走embedding表,URL不是字符串而是抓HTML正文过预训练句向量,再拼位置编码过Transformer;自监督目标就是预测下一事件的页面标题和URL,或做masked预测,全程不需要标注数据。
🧩 分类体系不是拍脑袋写的:先对session embedding做K-Means聚类,每个簇采样若干条喂给LLM,让LLM看到的是全量行为分布而不是随机子集;再用generate-update-review迭代流程把标签收敛成闭合标签集,避免自由文本标签前后不一致、没法审计。
⚙️ 蒸馏发生在embedding空间而不是文本空间:轻量分类器直接吃64维向量输出人类可读意图标签,推理阶段没有LLM调用、没有文本编码,一天能扛百万级session。
📊 移动端首页卡片排序任务:macro Recall@1 提升1.88%,Log Loss 下降13.38%,对比的是线上生产baseline。
📈 用户转化预测任务:session embedding 比直接用LLM标签高出4.3% micro F1。
✅ 蒸馏层只掉7%的标注质量,换来数量级更快的推理速度和可解释标签。
总结感想:做金融、合规这类既要效果又要可解释的场景,尤其是想从登录前web流量里挖意图的同学,这套双输出架构可以照着抄。盯指标要盯下游排序的Recall@1和Log Loss,别只看标注一致率。坑有两个:跨渠道实体对齐依赖一方cookie和登录凭证,对不准web意图会反过来污染登录后的个性化;URL正文向量是预计算的,页面改版后得定期重刷,否则语义特征会悄悄过期。
原文:AlphaXiv