小红书精读:SPARQL-LLM in the TEXT2SPARQL 2026 Challenge
实时生成SPARQL,3美元拿下冠军🏆
各位算法同学们,Text2SPARQL 2026 的第一名,全程没有 agent 循环,每次提问调用 LLM 的次数是固定的,整场比赛所有 LLM 调用加起来花了不到 3 美元。
📄 SPARQL-LLM in the TEXT2SPARQL 2026 Challenge
🔧 不做 agent 探索,走检索式上下文:查询前就把示例问答对(LC-QuAD、QALD-9+、2025 年测试集)和 endpoint 的 schema 拼进 prompt,每问的 LLM 交互次数固定,不存在收敛失败,也没有几十次工具调用堆出来的 token 账单。
🧩 面对完全未知的 Corporate KG,没有现成语料,就用 DeepSeek-V3 按 13 个类、30 个属性生成问答对,再把生成的 SPARQL 拿到 endpoint 实跑,零结果的直接丢掉。
⚙️ 支持英语、德语、西班牙语,代码开源,并且已经部署在去中心化的生物信息 KG 上对外提供服务。
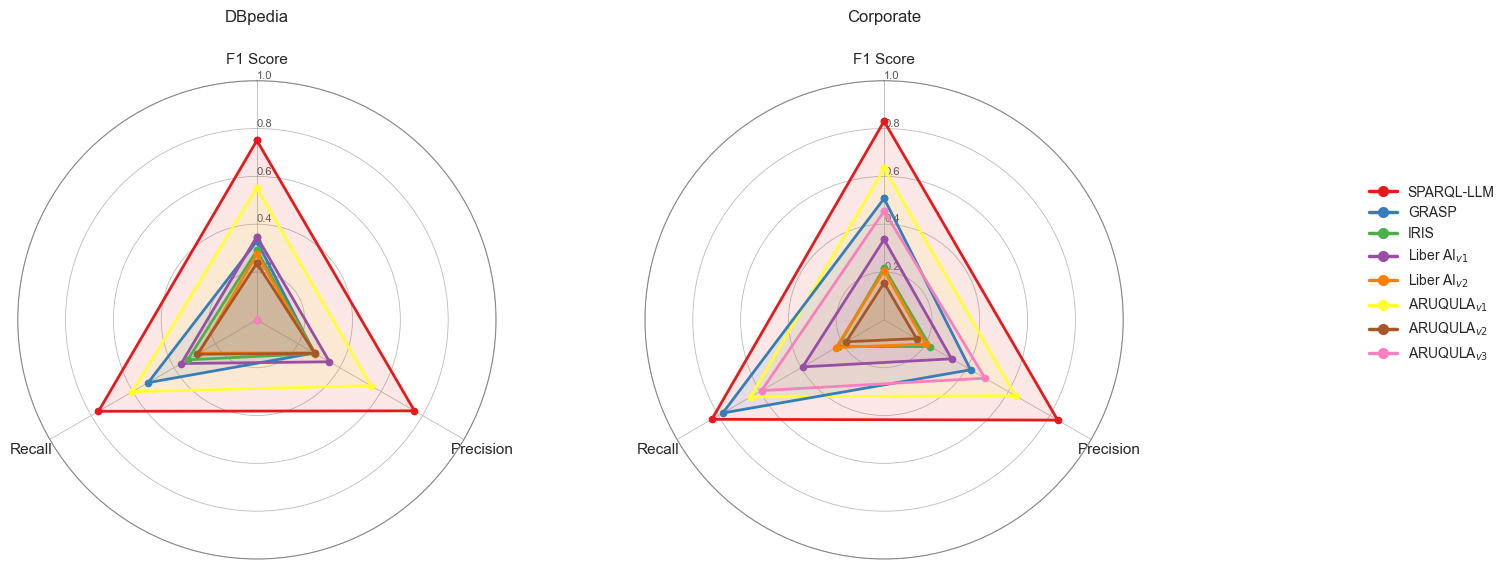
📊 DBpedia 英语 F1 0.7192,比第二名 ARUQULA 高 17%
📈 DBpedia 西班牙语 F1 0.7810,比第二名高 59%
✅ Corporate 英语 F1 0.8539(高 33%)、德语 0.8141(高 30%),NDCG 都是 1.0
💰 八支队伍参赛,它在所有数据集和语言上都是第一,全部 LLM 调用总花费不到 3 美元
要盯的就两点。一是它的收益来自示例覆盖度,换一个全新 KG,这套“生成示例再回灌 endpoint 验证”的流程得重走一遍,成本和质量都压在示例集上。二是它和 agent 式方案是明确的取舍,放弃了对任意复杂查询的自适应,换来固定延迟。如果你要做低延迟、低成本的 text2SPARQL 落地,这套架构比单看 F1 更有移植价值;如果查询模式五花八门、明显超出示例分布,先做自己的覆盖度测试再上。顺带一提,ARUQULA 的 v3 变体在某些语言上直接掉到 0.0000,看多系统对比时别只盯最好的那个变体。
原文:AlphaXiv