小红书精读:UniSGR-V2: Stepwise Target-Side Feature Anticipation and Crossing for Generative Recommendation
生成式推荐的目标特征盲区,有解了🔍
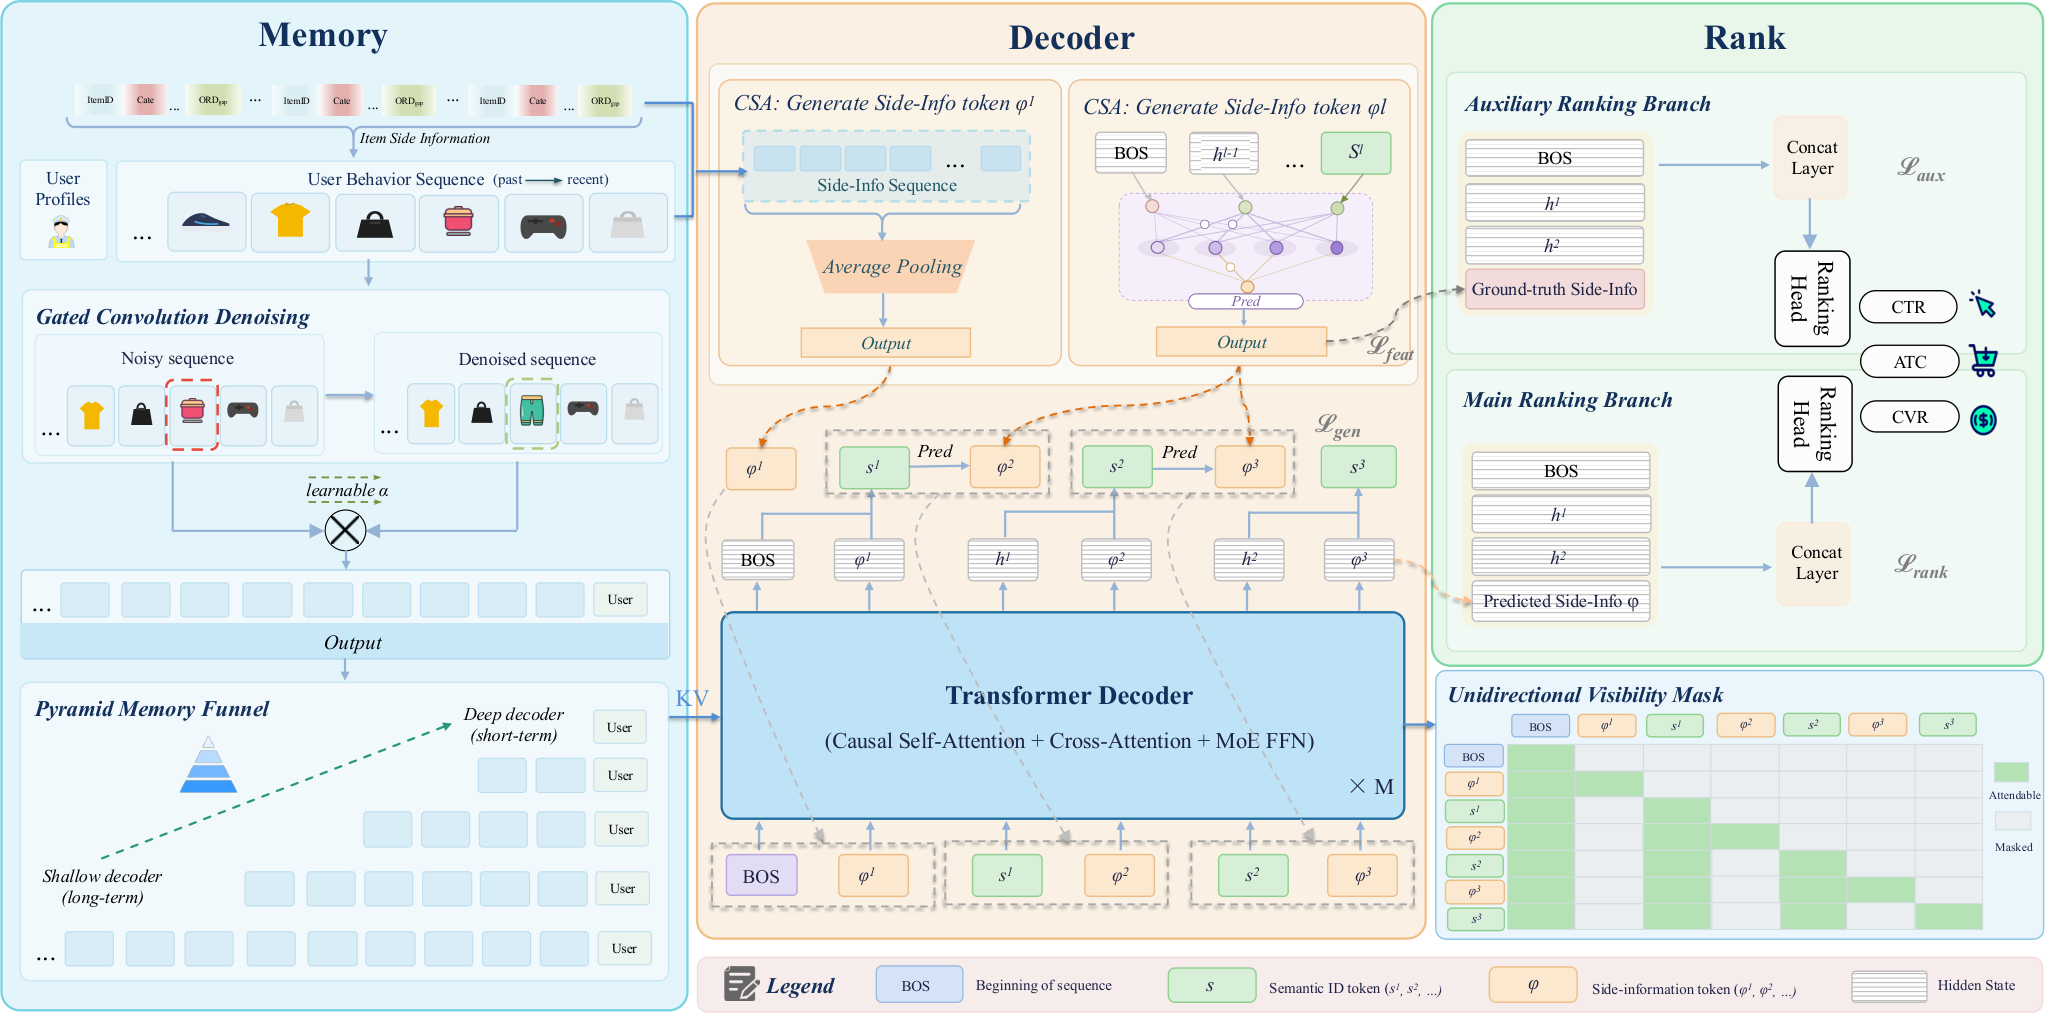
各位算法同学们,生成式推荐有个反常识的结构性缺口:模型逐层解码 semantic ID 时,全程看不到目标商品的类目、店铺、品牌,因为目标还没生成出来,特征根本没地方查。这篇就是冲这个「目标侧特征真空」去的。
📄 UniSGR-V2: Stepwise Target-Side Feature Anticipation and Crossing for Generative Recommendation
🔧 核心做法是在解码路径内部预测一个连续的目标侧特征向量,再和语义前缀、用户行为序列在 decoder 里交叉,同一份表示既给当前层生成当条件,又直接拿去排序,不用再挂事后查特征的补救管线。
🧩 回归连续向量有两个新麻烦:可学习的回归目标可能和预测一起塌缩成平凡解,预测噪声还会顺着 attention 污染生成。前者用语义锚定辅助塔加任务对齐约束,后者用单向可见性 mask 切断——语义 token 不能看预测 token,预测 token 之间也互不可见。
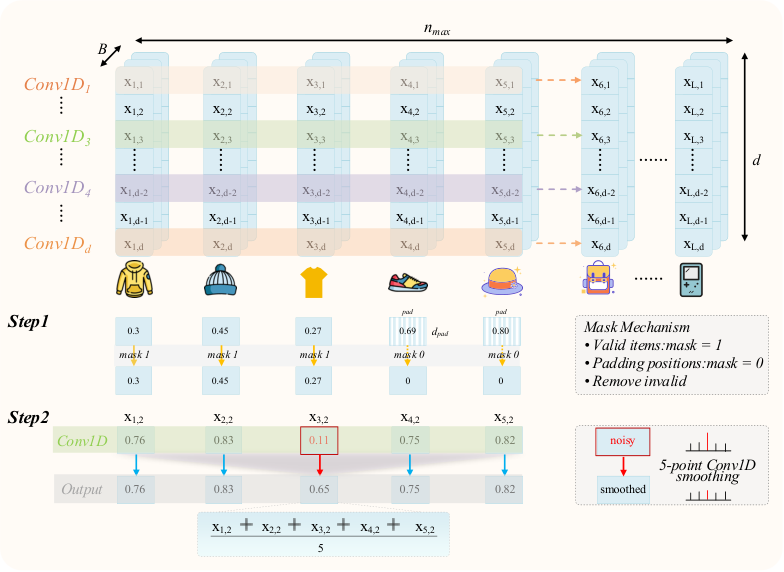
⚙️ 工业长行为序列上,门控卷积去噪压掉脏交互,再改造金字塔记忆漏斗的收缩维度降推理开销。
📊 离线在 Lazada 大规模数据集上,四个召回指标和四个排序指标全部超过 UniSGR,也优于 OneRec、UniRec。
📈 线上 A/B:IPV +0.79%,Order +5.55%,GMV +3.09%。
✅ 对比 UniRec 的 Chain-of-Attribute:那条路先自回归生成离散属性 token,错一步不能回退,属性维度一多解码步数线性增长,带宽还被词表卡住;换成连续向量回归就没这个粒度限制。
做端到端生成式推荐、排序头直接挂在 decoder 上的同学可以跟一下这条路线。要盯的坑是连续回归目标有没有真学出判别性,别退化成和预测互相塌缩的自证循环,论文自己承认这点,语义锚定塔属于缓解不是根治。另外 GMV 涨 3.09% 而 IPV 只涨 0.79%,收益主要吃在高价值转化,冷启和低频品类能不能复现得单独验。
原文:AlphaXiv