小红书精读:OneTrans-V2: Unifying Retrieval, Pre-rank, and Fine-rank with One Transformer in Industrial Recommender
级联推荐三合一,GMV涨9.74% 🚀
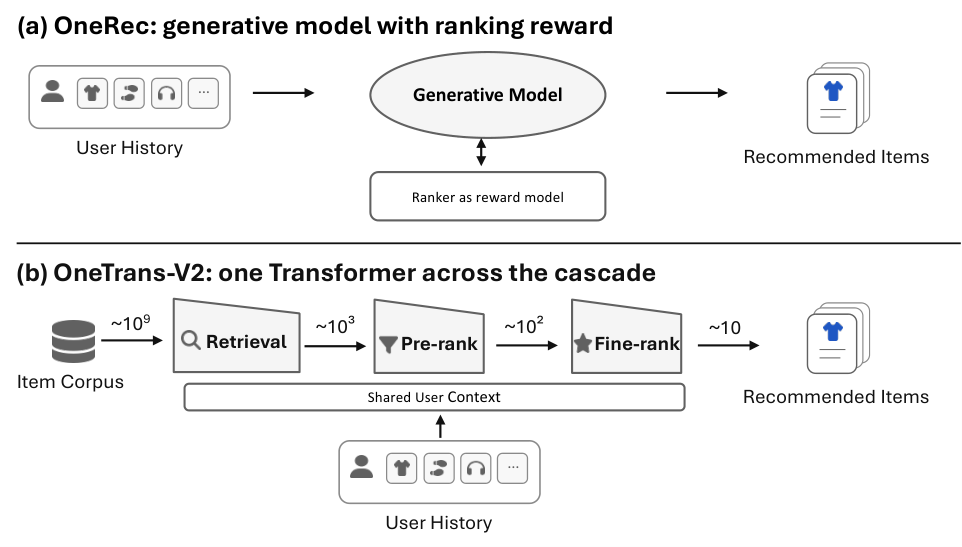
各位算法同学们:一个Transformer同时干召回、粗排、精排,GMV提升9.74%,同硬件下QPS是原级联的3.2倍。看点不是涨点,是它没走OneRec“干掉级联”那条路——候选特征全保留,只把候选无关的用户上下文共享出来。
📄 OneTrans-V2: Unifying Retrieval, Pre-rank, and Fine-rank with One Transformer in Industrial Recommender
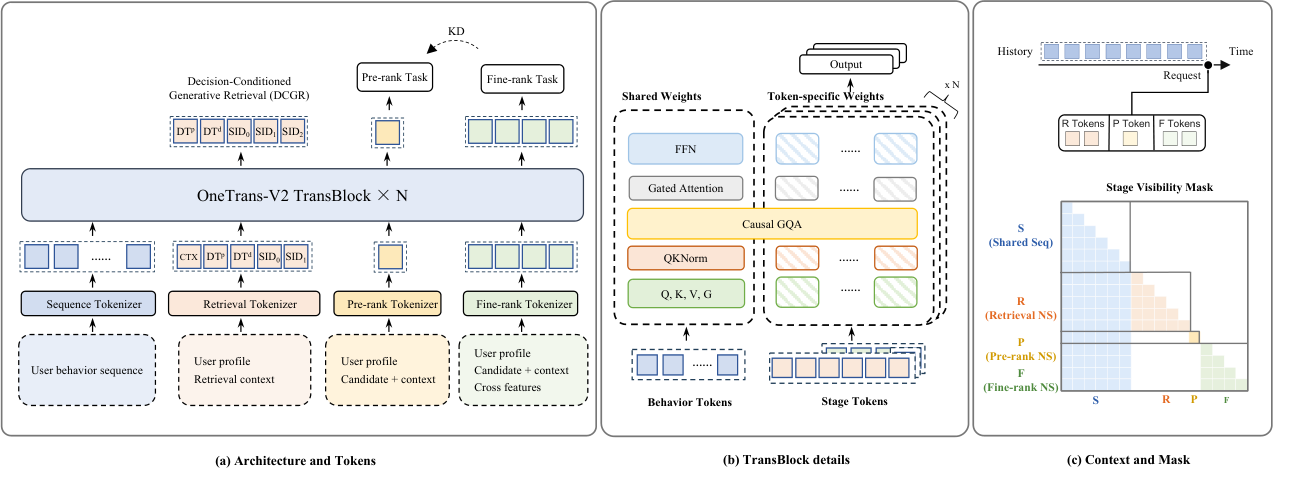
🔧 用户行为序列只编码一次成共享user context,三层各自追加自己的token;stage visibility mask让各阶段读得到上下文但互相看不见,于是粗排能只用1个token保持轻量,精排用多token建模cross feature。
🧩 DCGR治召回的多目标分裂:先预测“决策前缀”(是否转化、金额档位、类目对用户有多新),再条件生成item的SID;业务目标靠business offset去偏决策分布,一套生成模型覆盖多个目标,线上当参数调,不用另训通道。
⚙️ 稀疏MoE撑容量、激活计算有上界,μP式参数化稳住优化;SNT按用户终身行为序列组织训练,把一次序列编码摊到多次曝光上。
📊 GMV提升9.74%,三阶段全量上线 📈 同硬件预算下端到端QPS是原级联的3.2×(依赖协同设计的serving) ✅ SNT带来4.4×训练加速 ✅ 联合训练下召回、粗排、精排都优于各自单独训练的版本
总结:做级联推荐、尤其被“用户序列重复编码”和“召回多通道”磨过的团队,这套共享上下文加DCGR值得对着自己链路比一遍。两个坑要先想清楚:stage visibility mask的token预算得和延迟对齐;3.2×QPS依赖配套serving改造,换模型本身拿不到。对照对象是UniR2、OneRec这类工作,分歧点在于“保留候选特征”还是“去级联”,盯住GMV和QPS/延迟比值这两个指标就够了。
原文:AlphaXiv