小红书精读:X-Rec Technical Report
TikTok上线:3.46倍吞吐的生成式召回
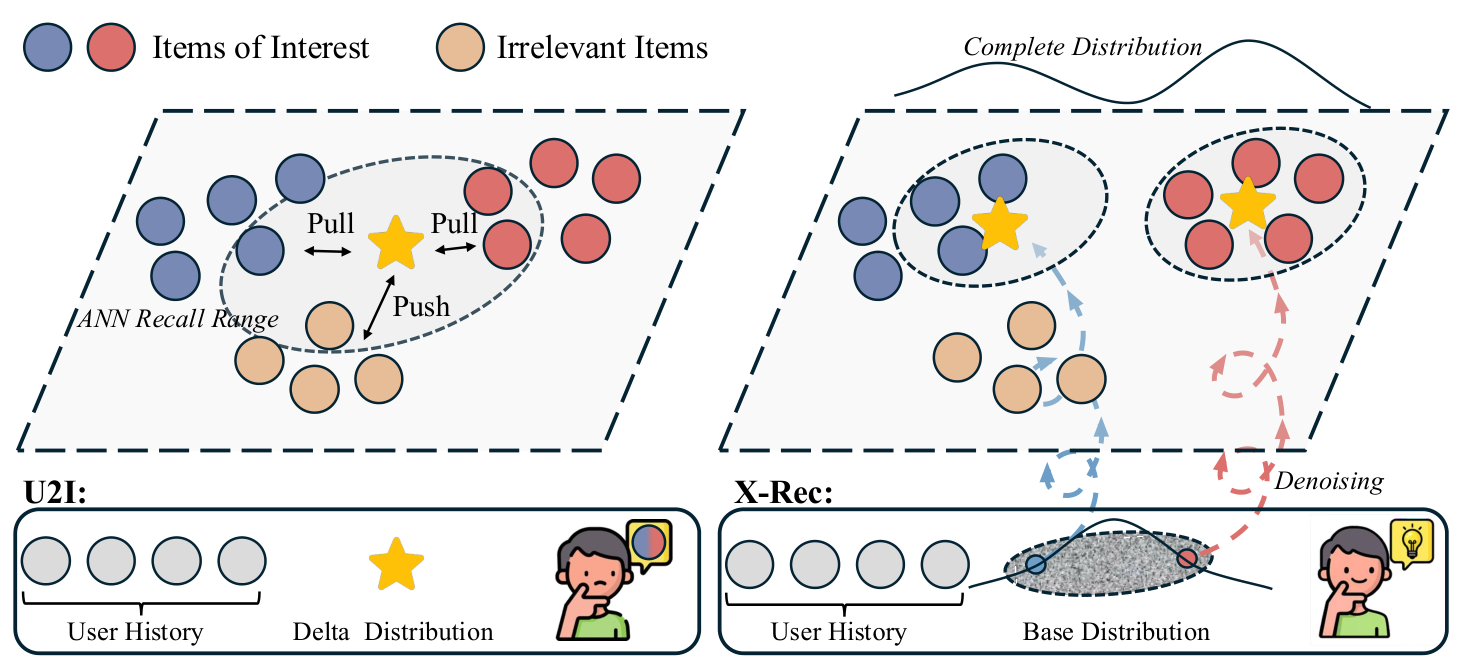
各位算法同学们,双塔U2I把用户兴趣压成一个点,SID-AR又要逐token解码,吞吐被卡死——有没有一条路,既保留多峰分布又不用离散化?TikTok这篇X-Rec给了一个挺工程化的答案。
📄 X-Rec Technical Report
🔧 锚点条件生成:先预测目标embedding所属的簇(锚点),再以锚点为条件做细粒度生成,把从零生成item向量拆成“选大致语义区域+局部精修”,官方说这一项让Recall@20涨了2.05个百分点,还能通过调整锚点分布主动控制召回多样性。
🧩 黎曼流匹配:item embedding大多在余弦对比学习下训出来,本身就躺在球面上,所以生成轨迹直接沿球面测地线走,而不是在欧氏空间里强行把向量拽回球面,比rectified FM的Recall@20高1.78个绝对百分点。
⚙️ late-interaction DiT:速度场估计只在最后一层Transformer做,前面几层不做重复去噪。代价是Recall@20只掉1.05个百分点,生成吞吐却涨了约8.28倍,这个交换比在召回场景里算很划算。
📊 流式benchmark上明显超过U2I基线,召回质量和SID-AR打平,推理吞吐是SID-AR的3.46倍。
📈 已作为TikTok某垂直内容的新召回源上线,连续两次launch带来垂直互动+4.1484%。
✅ 大盘互动也有+0.0111%,别小看这个数,召回侧能撬动全站指标通常很难。
📉 消融里三项设计各自都有正收益,不是靠堆参数堆出来的。
总结:如果你在做大规模召回、又被SID-AR的解码延迟折磨,这篇值得细看,重点盯吞吐-Recall的权衡曲线,以及锚点数量和聚类更新频率怎么设。坑在于连续空间生成对ANN索引和线上一致性要求更高,离线Recall涨了不代表线上一定涨,最好先小流量验证锚点分布的可控性。
原文:AlphaXiv