小红书精读:DeGRe: Dense-supervised Generative Reranking for Recommendation
重排还在推点击置顶?该换了🔁
各位算法同学们:淘宝闪购线上 GMV +3.75%,靠的不是更大的生成模型,而是把排列空间的探索整个挪到了线下。DeGRe 要治的是生成式重排的两个老毛病——标签靠规则拍、回报信号太粗。
📄 DeGRe: Dense-supervised Generative Reranking for Recommendation
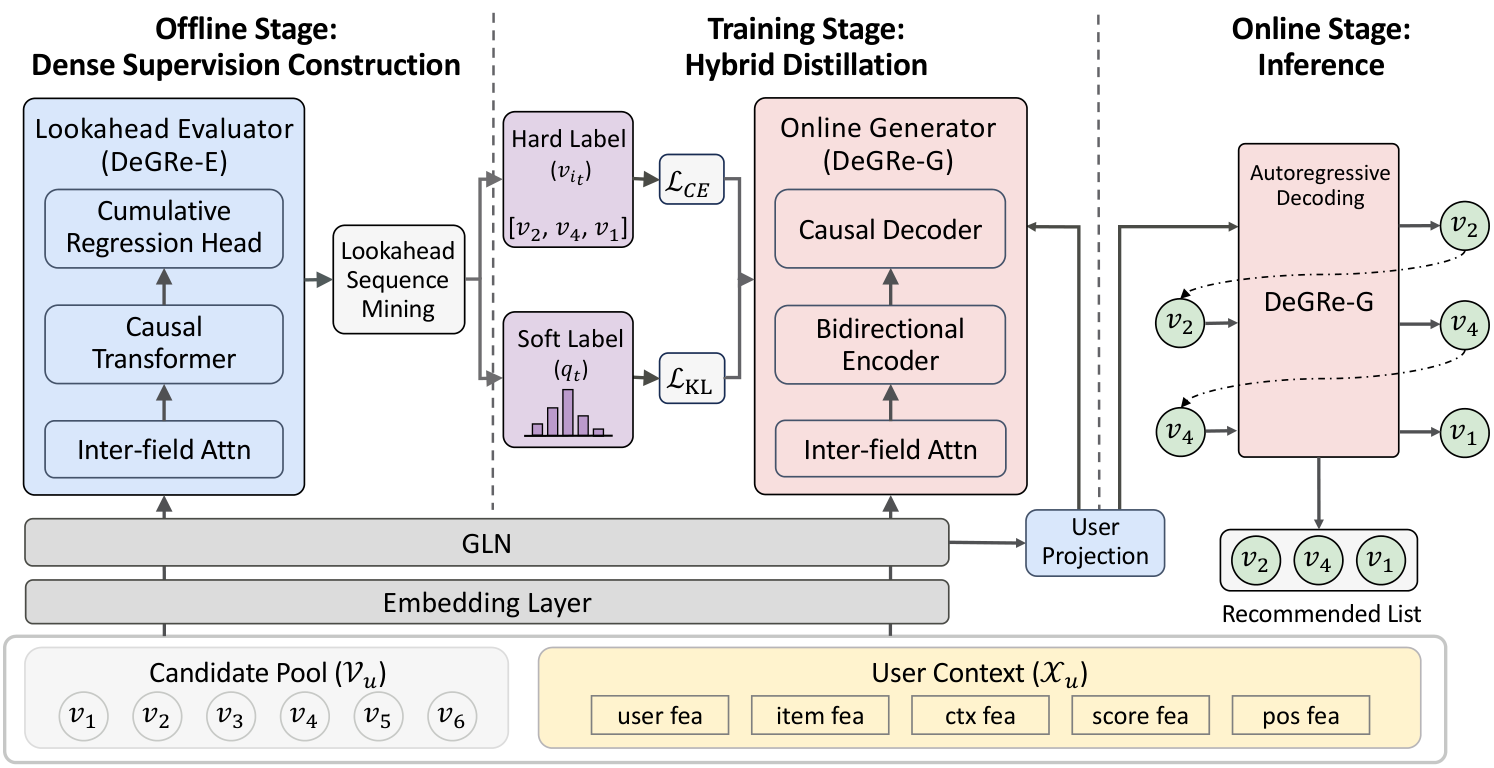
🔧 老做法把“点击的 item 提到前面”当训练标签,等于默认点击一定更值钱、跟位置无关。DeGRe 改成离线用 Lookahead Evaluator 去未曝光空间里挖高价值序列:它建在 cumulative regression 上,把“当前累计价值”拆成一组序数二分类再求和,因此能给任意长度的子序列打分。
🧩 奖励式方法的痛点是 credit assignment——整条 list 只有一个 CTR/GMV 后验分数,分不到每一步。DeGRe 把 evaluator 的逐步价值估计当作 dense supervision,蒸馏进轻量的 Online Generator,让生成器内部把前瞻规划学会。
⚙️ 于是离线在线解耦:在线不采样、不重排,一次 greedy decoding 逼近全局最优,也不用同时部署 generator 和 evaluator,延迟可控。
📊 论文称在公开 benchmark 和工业数据集上都超过现有 baseline,同时保持推理效率;摘要里没给具体数值,我就不编了。
✅ 线上 A/B 测试:GMV +3.75%,目前已部署在淘宝闪购。
总结:如果你们线上还停在“单点评分+贪心排序”,或者拿 reward model 训生成式重排但回报太稀疏,这条路线可以复现看看。要盯的是 list 级 utility 和线上 GMV/CTR,别只看单点 AUC。坑有两个:离线 beam search 挖掘加累计回归训练本身不便宜;dense 信号的质量全看 evaluator 校准,它偏了,生成器只会学得更自信。
原文:AlphaXiv