小红书精读:Beyond a Scalar: Distributional Serving Interfaces for Watch-Time Prediction
📉推荐模型别只输出一个标量
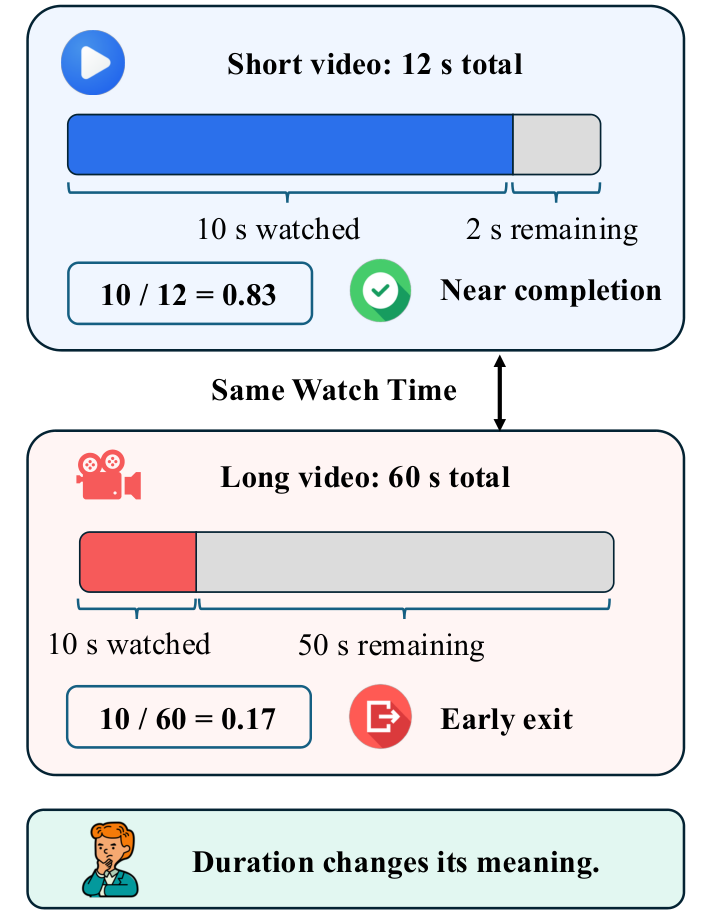
各位算法同学们,同一条“看了10秒”,放在12秒视频里是快看完,放在60秒视频里只是刚开头,但很多推荐系统下游拿到的仍然只是一个标量。这篇把观看时长预测从“给个点估计”改成可复用的分布接口,正好戳中多任务场景的痛点。
📄 Beyond a Scalar: Distributional Serving Interfaces for Watch-Time Prediction
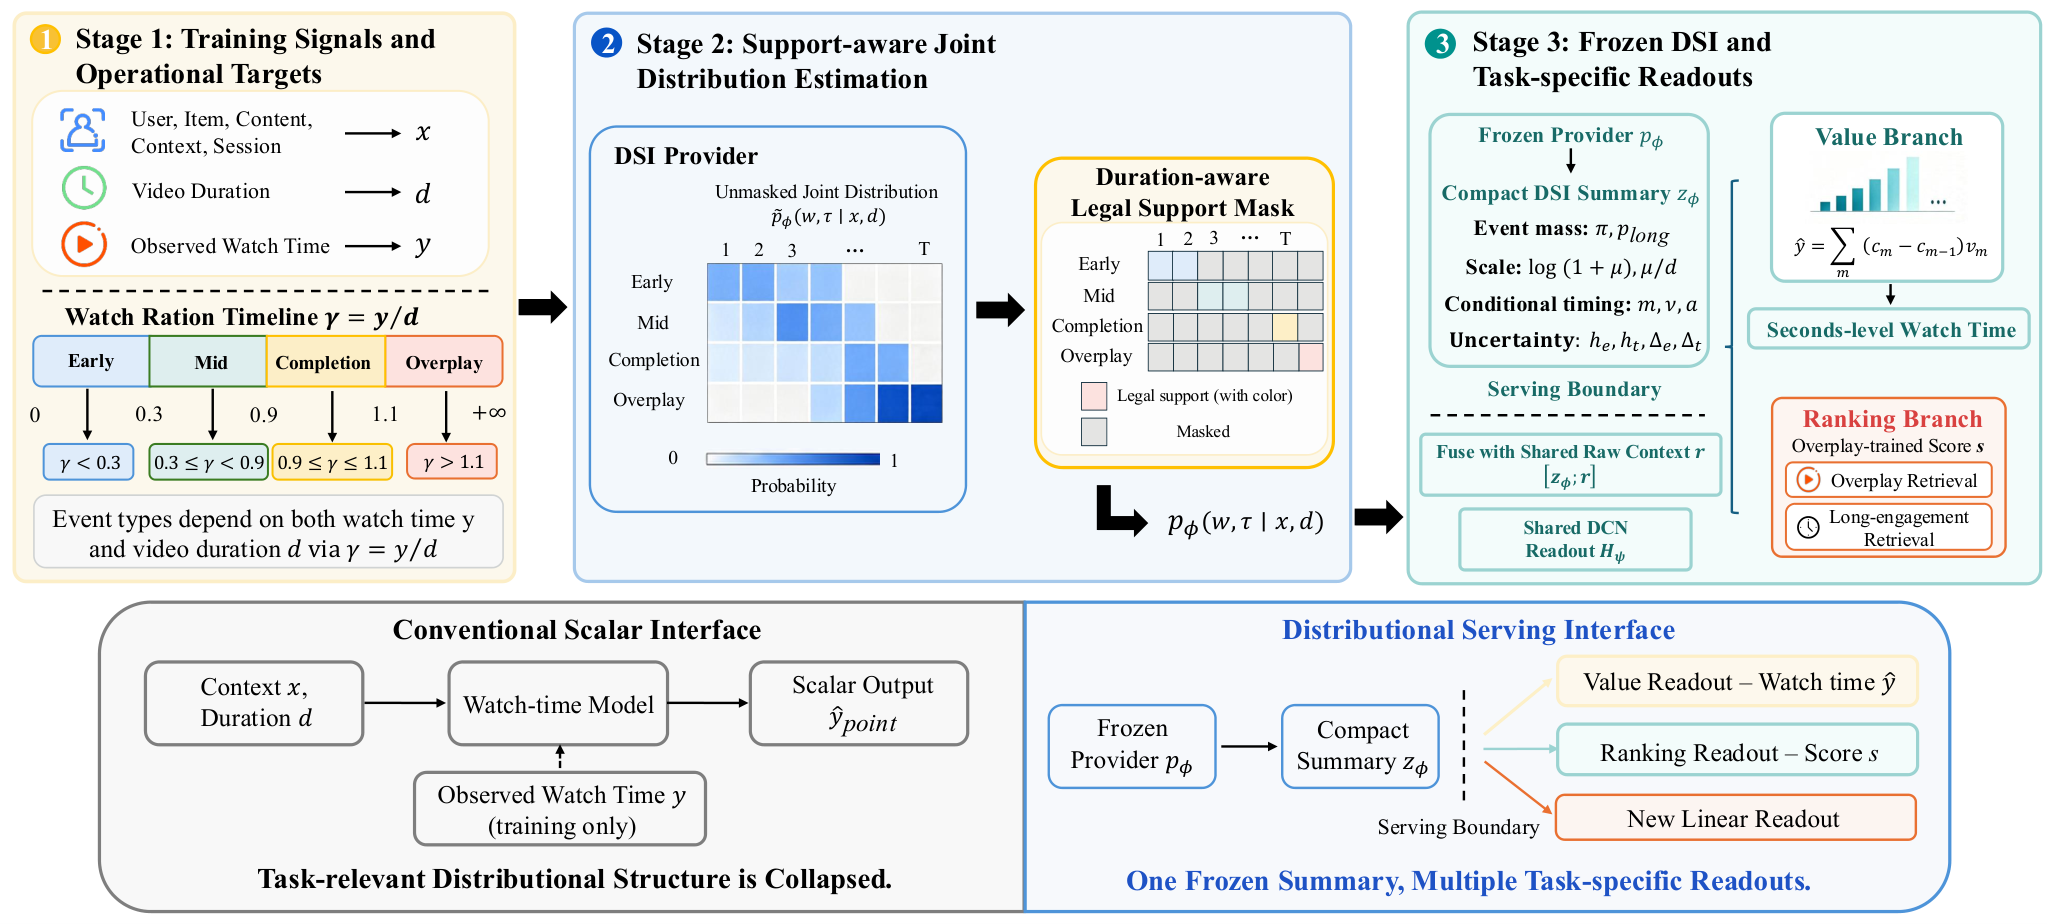
🔧 把观看行为拆成 early、mid、completion、overplay 四类事件,用观看比例 γ=y/d 生成监督,不需要额外收集新标签。
🧩 训练 provider 估计“事件类型 × 事件时间”的联合分布,用视频时长构造支持约束,过滤不合法组合,再加秒级 restoration loss,保证预测回到秒数仍然准。
⚙️ 推理时冻结 provider,只往下游暴露低维 summary,包含事件概率、相对时长和不确定性;新任务接轻量 readout 就行,不用重训 provider。
📊 在 KuaiRec、KuaiRand-1K、WeChat21 三个数据集上,完整 DSI 的 MAE 都最低,比九个基线里最强结果好 1.9% 到 8.5%。
📈 XAUC 在两个数据集上取得最好结果;比较完整系统时,考虑视频时长的 retrieval 指标也领先。
✅ 固定 readout 做对比,summary 仍保留超出“预测均值 + 视频时长”的任务信息;同一套线性头换到两个新观看时长目标上表现最好,并提升了一个单独记录的 engagement 目标。
🧪 随机初始化 provider 复现不出这个增益,说明收益主要来自学到的分布结构,而不是接口本身。
各位算法同学们要是做短视频排序、多目标或时长预估,这篇可以拿来对照自己的 serving 输出。落地时先看 provider 的分箱和 support mask 是否贴合业务时长分布,再盯 MAE、XAUC 和 duration-aware retrieval;如果基线只是 duration-aware 标量,记得用固定 readout 做同条件比较,不然容易把接口增益和模型容量混在一起。
原文:AlphaXiv