小红书精读:UniRec: Cross-stage Multi-Task Fusion with Preference Alignment for Cascaded Recommender Systems
粗排把精排喜欢的筛掉了😅
各位算法同学们,精排喜欢的内容,粗排可能早就把它扔了——这就是级联推荐里典型的跨阶段不一致。UniRec 的切入点不是只调粗排打分模型,而是把粗排和精排的多任务融合模块放进同一张计算图里联合优化。
📄 UniRec: Cross-stage Multi-Task Fusion with Preference Alignment for Cascaded Recommender Systems
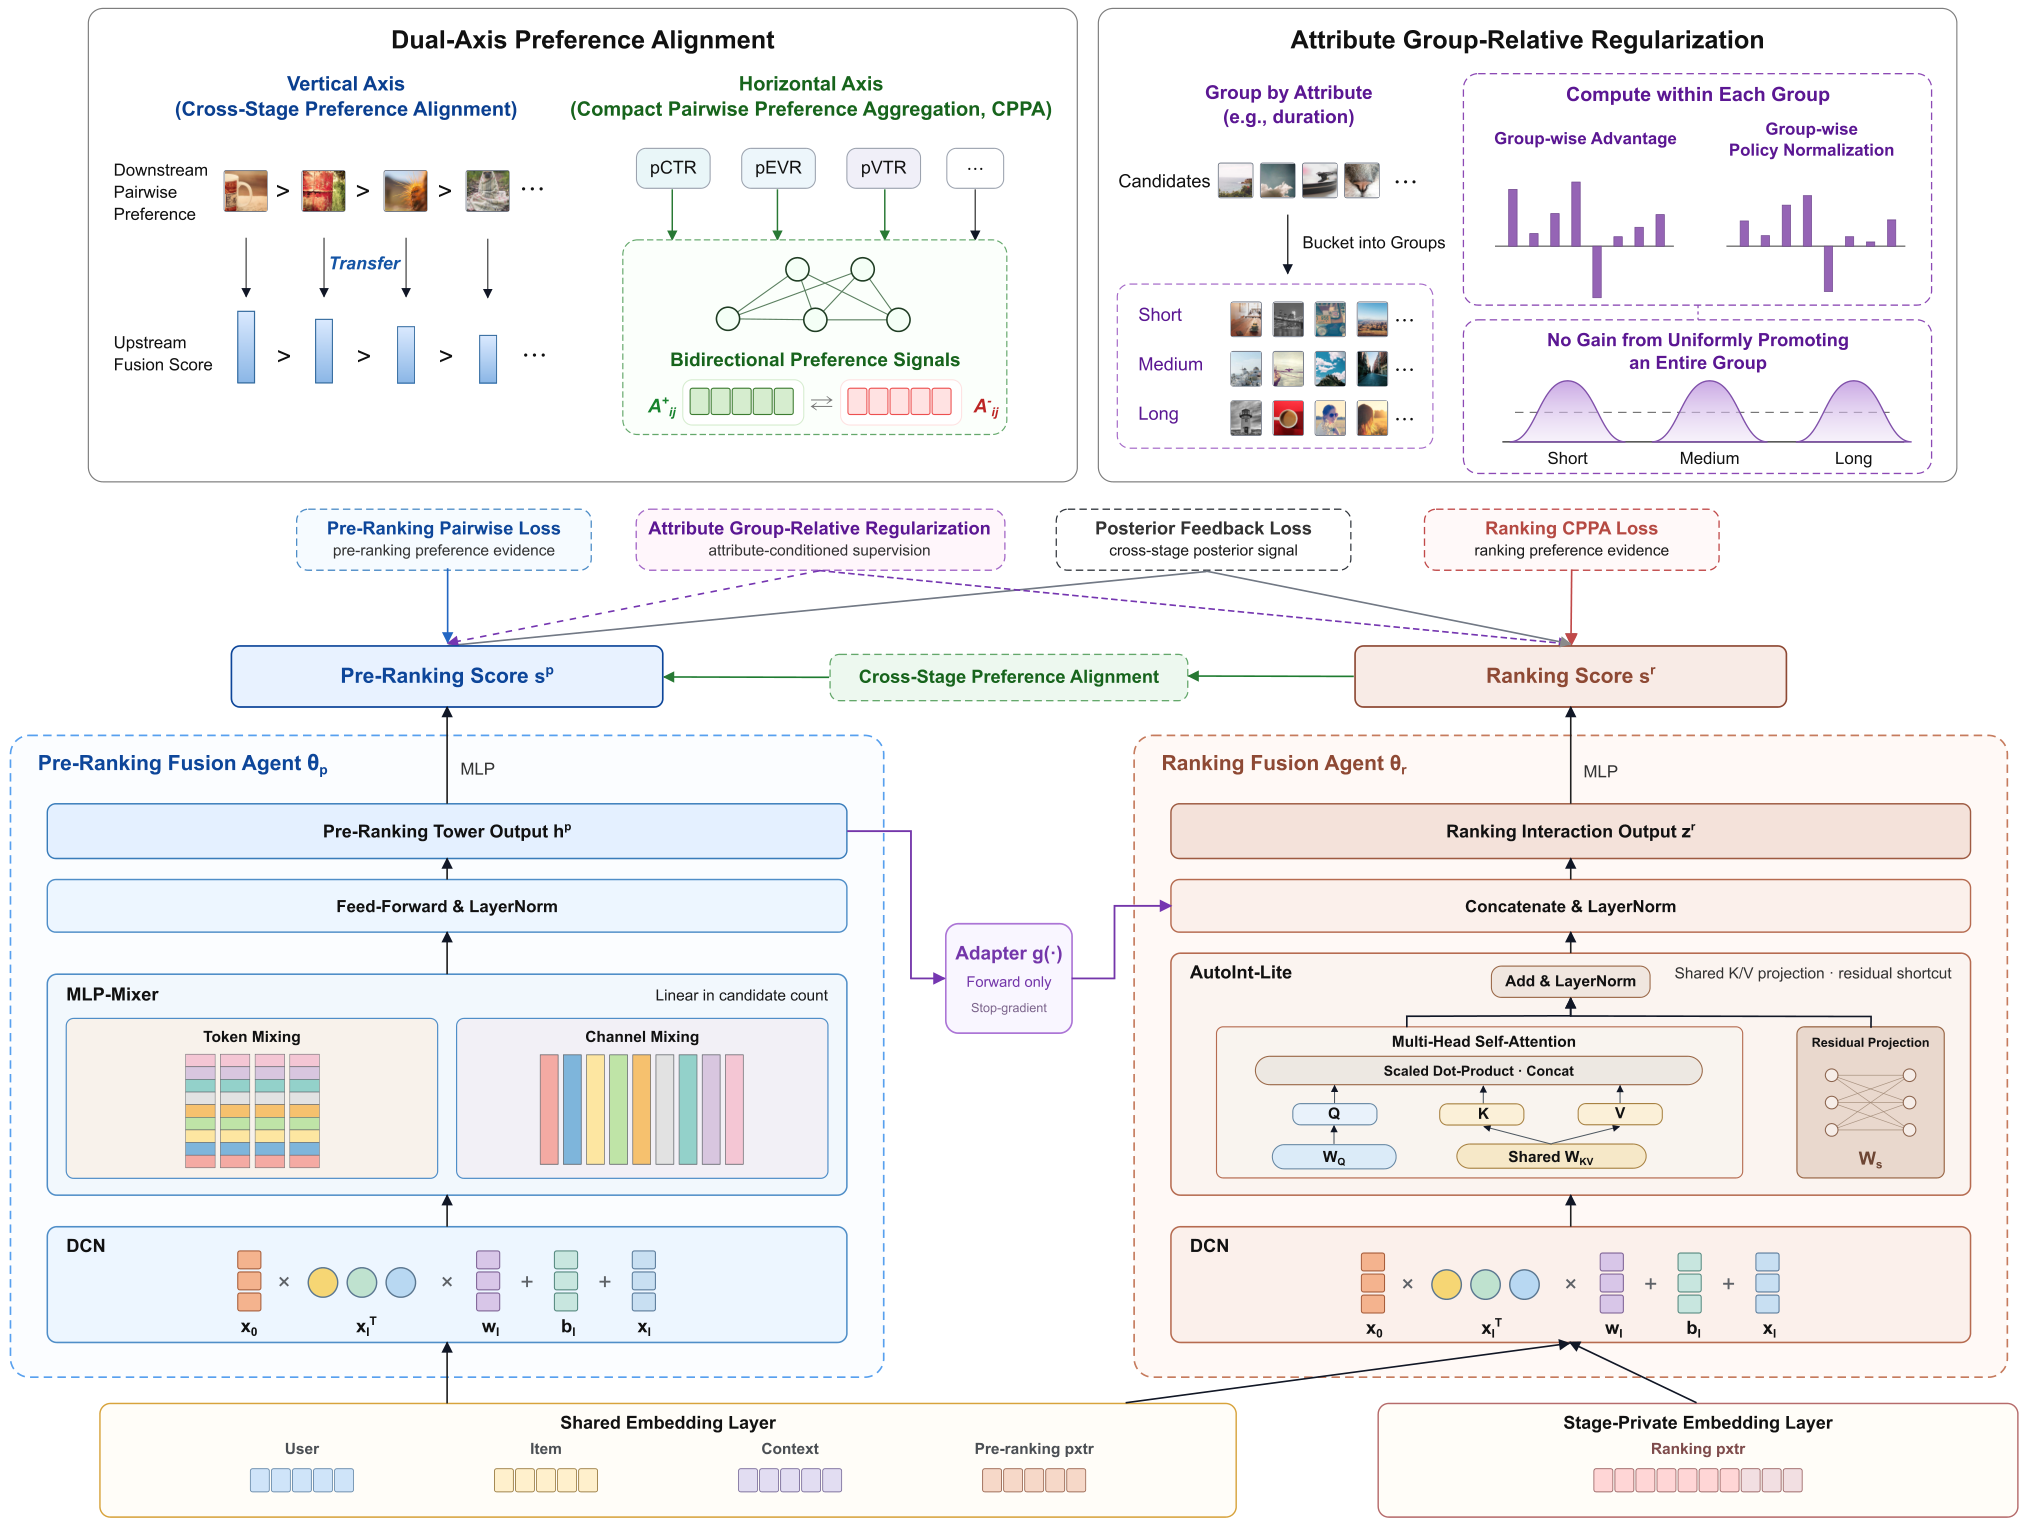
🔧 两个融合 agent 部分共享输入 embedding,在单个计算图里训练,梯度能从任一阶段流回去影响另一端;adapter 还把粗排表示显式喂给精排融合模块。不是单向蒸馏,是双向适配。
🧩 双轴偏好对齐:纵轴把精排的 pairwise preference 传到粗排融合分,横轴把几十个异构先验信号上的 pairwise 目标压成双向偏好证据,降低多目标融合的扩展成本。
⚙️ AGRR 属性组相对正则:借鉴 GRPO 的分组思路,优势计算和策略归一化都放在同属性组内做。整组高奖励属性被统一抬高不会带来优化增益,避免端到端优化只偏向高回报属性区域。
📊 离线评估里,UniRec 稳定超过单阶段融合和跨阶段协调 baseline,论文没给具体点数,别把这个当绝对提升。
📈 线上 A/B 显示 app 使用时长 +0.616%。这个数字在生产系统里不算大,但方向一致且已全量部署。
✅ 已在快手平台全量部署,说明延迟和工程约束这关过了。
如果你在做级联推荐、粗排精排融合或多任务权重优化,这篇的抓手是“别只对齐打分,要对齐融合模块”。要盯的坑是 AGRR 属性分组怎么划,划太粗可能没约束,划太细又回到单目标;线上也别只看使用时长,最好同时看生态和多样性指标是否被牺牲。和 COPR、HCCP 这类跨阶段协调比,它多动的是融合层,不是上游打分。
原文:AlphaXiv