小红书精读:VARG: Value-Aware and Ranking-Aligned Generative Retrieval for Dynamic E-commerce Search
天猫搜索跳过粗排,生成式召回涨GMV
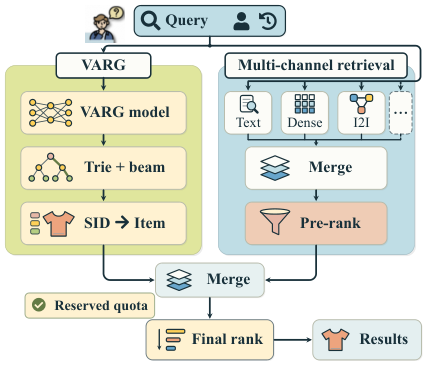
各位算法同学们,生成式召回不一定只能待在召回层——VARG 把生成的 item 直接塞进天猫现有精排,跳过 item 级粗排,14 天线上 A/B 把 GMV 拉高了 1.45%。粗排漏掉的商品精排是救不回来的,所以这篇真正动的是「候选配额」这件事。
📄 VARG: Value-Aware and Ranking-Aligned Generative Retrieval for Dynamic E-commerce Search
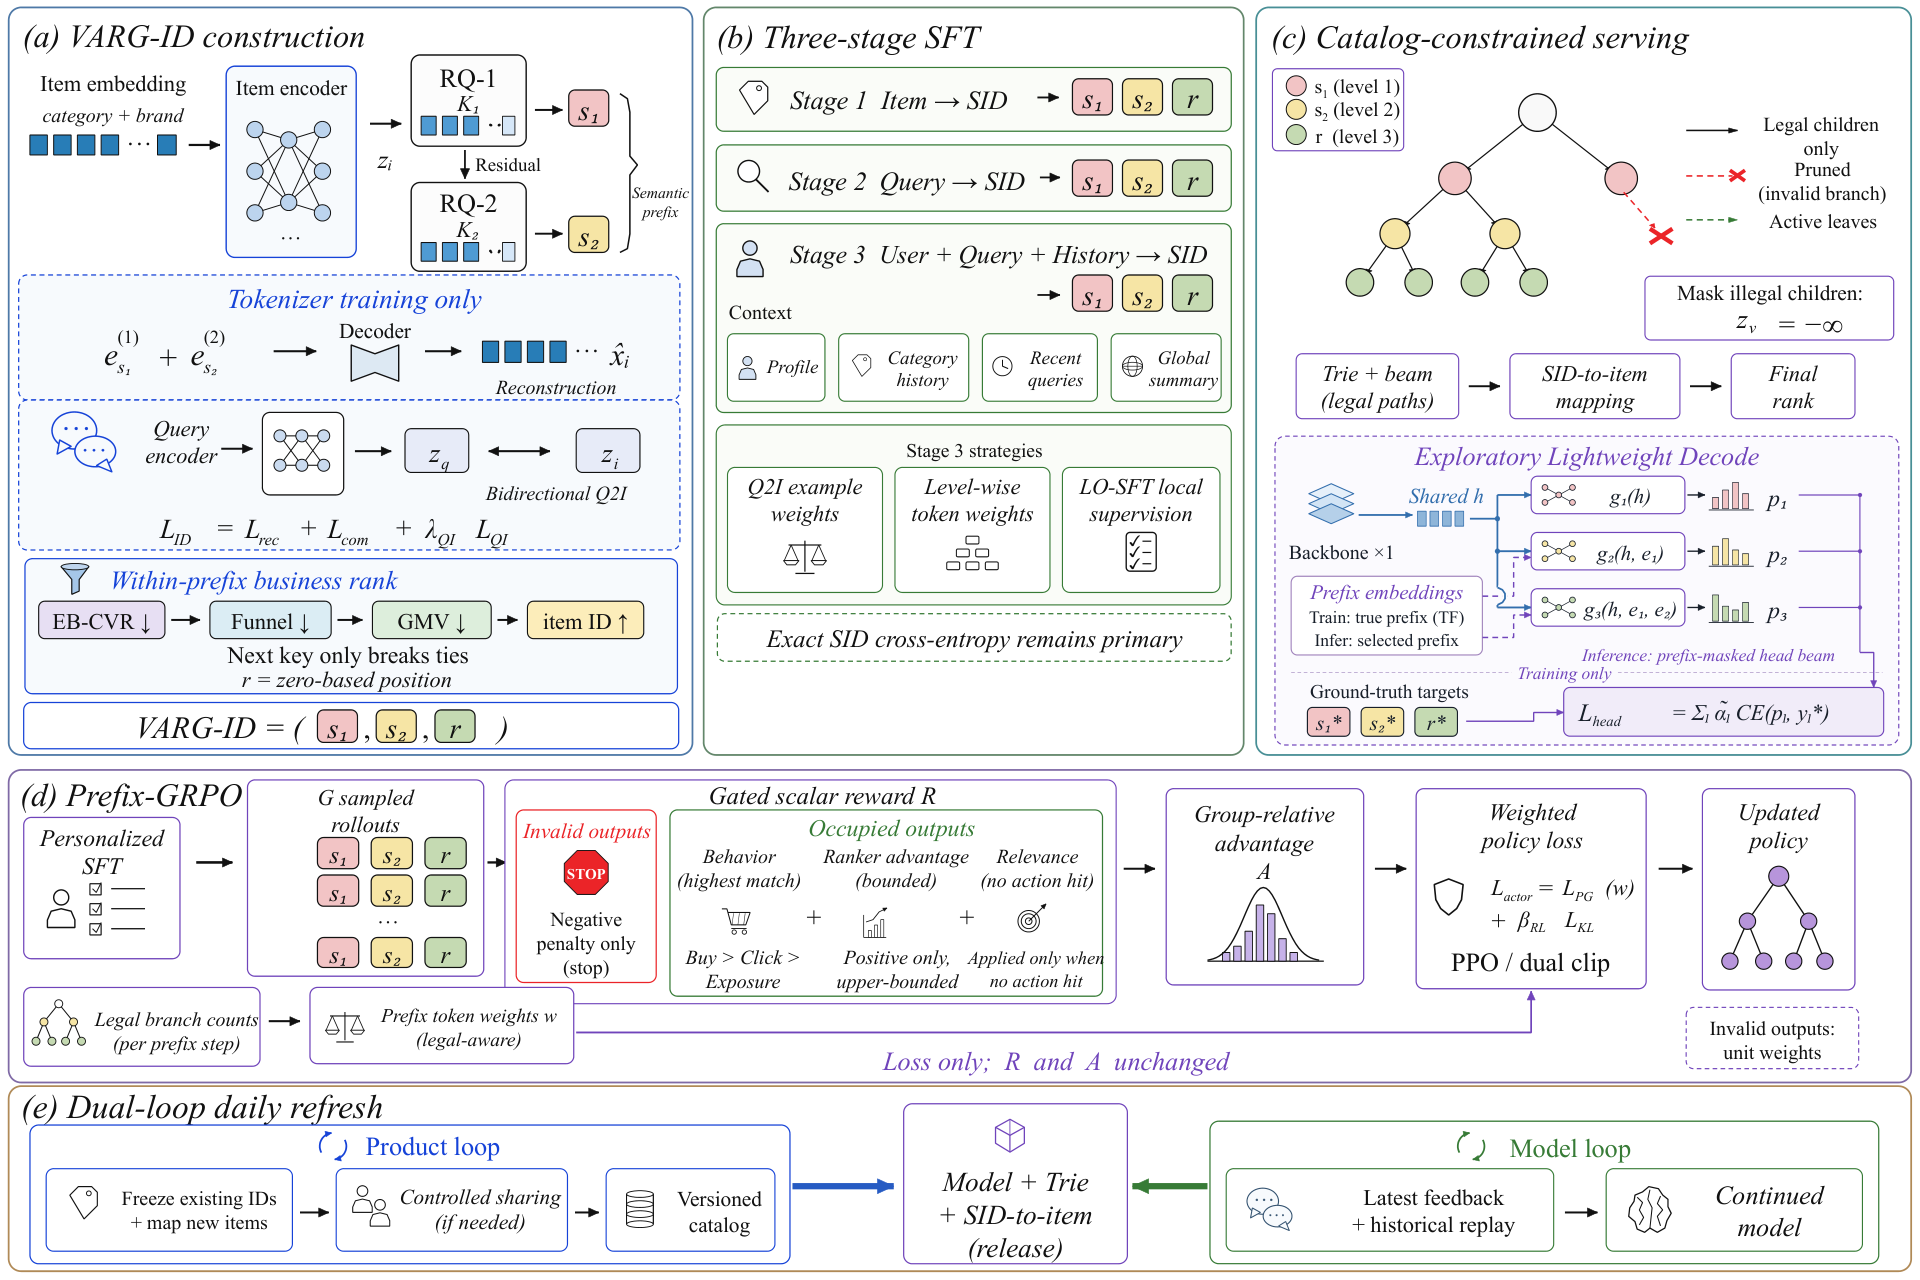
🔧 VARG-ID 用 RQ-VAE 造语义前缀,再用双向 query-item 对比学习把搜索相关性灌进前缀;第三个 token 用经验贝叶斯 CVR 做价值排序,但只用来打破同簇平局,item 地址不会随每天的统计波动漂移。
🧩 三阶段 SFT 从 item→SID、query→SID 一路走到个性化,叠加 Q2I value 加权、SID level-wise 监督和扩展用户上下文,再用 LO-SFT 显式学第三个 token 编码的簇内序。
⚙️ Prefix-GRPO 把 SID 合法性、用户行为、ranker advantage、搜索相关性做成门控奖励,非法输出只吃负分,再配 prefix-aware token 权重;工程上商品侧冻结旧 ID、只映射新商品,模型侧做行为回放,日更不打断已学到的地址关系。
📊 离线在千万级商品上验证了标识稳定性,SFT 和 Prefix-GRPO 相对各自 baseline 在召回质量、头部价值召回上均有提升。
📈 线上 14 天、覆盖 20% 搜索流量的 A/B:GMV +1.45%,人均 IPV +0.22%,PCTR +0.31%。
✅ 导购类 query 上,用更小的候选配额也保持了有竞争力的相关性。
我的判断:适合已经跑通 SID 召回、精排够强、还敢给生成通道留固定配额的团队;如果精排本身对长尾价值不敏感,收益会打折。要盯的是头部价值召回和非法 SID 输出率,不是生成准确率——配额被低价值 item 占满,GMV 立刻掉。跟 CQ-SID、CRID 这类工作比,差异点在第三 token 的稳定性设计,以及把 ranker advantage 直接写进奖励。
原文:AlphaXiv