小红书精读:Do All Nodes Benefit Equally from Knowledge Graphs? Adaptive Node-Aware KG Fusion for Recommendation
所有节点都该吃知识图谱吗🤔
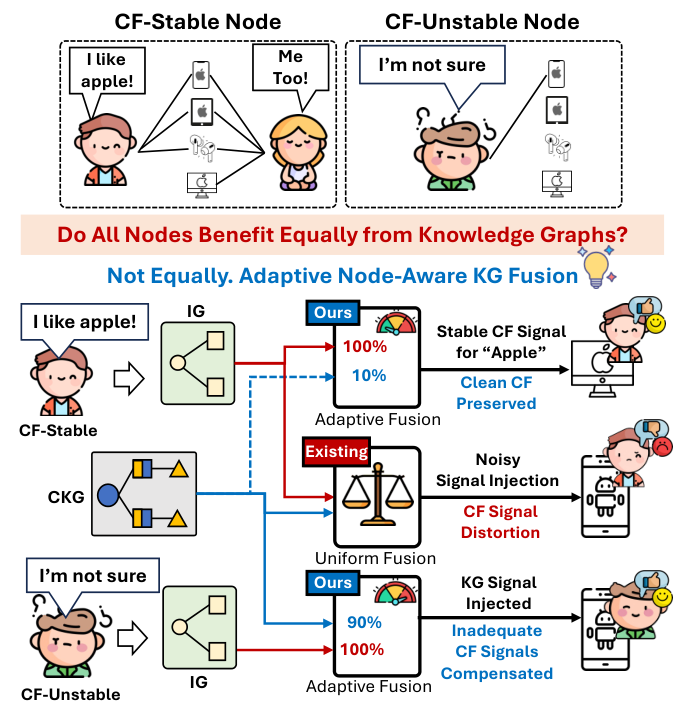
各位算法同学们,知识图谱不是加得越多越好:对CF信号本来就靠谱的节点,硬塞KG反而是在给它添乱。这篇来自Soongsil University、挂在CIKM ‘26的工作,把“每个节点到底该吃多少知识”变成了一个可量化的问题,思路比常见的“用注意力挑邻居”更靠上一层。
📄 Do All Nodes Benefit Equally from Knowledge Graphs? Adaptive Node-Aware KG Fusion for Recommendation
🔧 双视图分开编码:IG和KG各用一套编码器,不让KG在传播过程中顺手动到协同过滤信号,这是它和KGAT一类在CKG上统一传消息的做法最本质的差别。
🧩 用“稳定性”决定KG权重:对每个节点的CF表示做小幅对抗扰动,看它稳不稳;越不稳说明CF证据越不足,就分配越大的KG贡献,而不是简单按交互度数或长尾与否来切。
⚙️ 先对齐再融合:把IG和KG嵌入投到共享空间做自适应对齐,再按节点级依赖度加权融合,融合强度是逐节点的,不是全局一个超参。
📊 论文在四个真实数据集上和主流KG-aware方法做了对比,结论是整体表现更优。
📈 消融单独验证了“节点级自适应融合”这一策略本身有效,而不是靠编码器或对齐模块蹭出来的增益。
✅ 代码和数据集已开源在GitHub(ssu-dmlab/AdaKG),复现路径比较清楚。
⚠️ 摘要只给了定性强结论,没放具体提升数字。想看它比KGAT、KGIN、KGCL这些强多少,得直接翻正文表格,重点看按度数分层之后的结果。
总结:这篇适合正在做KG推荐、又隐约觉得“uniform fusion”不太对的同学,冷启动和长尾场景优先看。判断它管不管用,别只盯整体Recall/NDCG,要看尾部节点涨了多少,同时确认CF本来就稳的那批节点指标有没有掉——掉了就说明扰动估计出来的稳定性打分没分对。落地前还要算笔账:对抗扰动估计是额外开销,扰动率和节点权重的校准方式,是这套方法最容易翻车的地方。
原文:AlphaXiv