推荐算法日报 · 2026-10-22
总览
今天这四篇读下来,整体感觉是「不拼模型容量,拼证据怎么组织」——四篇没有一篇是靠把 backbone 堆大取胜的,全在改结构:有的改表征粒度,有的改级联预算,有的改解码每一步吃什么证据,还有一篇干脆只动了打分公式里的一个加减项,这个共性比单篇结论更有意思。主线大致两条:一条是长行为序列怎么在工业成本下真正用起来,快手的级联蒸馏和那篇把用户表征下沉到 item 级做缓存的思路,本质都是在跟「十万级序列 × 十亿用户」这个乘法项死磕;另一条是召回和排序的精细化,SID 自回归那篇盯住了「每步候选集不同」这个被忽略的点,Instagram 那篇则反过来主张别把基线减干净、把增量单独拎出来给权重。最值得细读的是 item 级缓存那篇和 SID 逐步个性化那篇:前者把缓存规模从跟用户数走改成跟物料库存走,这个视角转换我觉得是今天最有迁移价值的,虽然它的线上增益混了更长窗口和更新鲜度两个因素、不能照单全收;后者是四篇里唯一拿出七天线上 A/B 且离线机制指标(beam 前缀保留率、分支不均衡度)都对得上的,证据链最完整,而且它顺手证明了 1.7B 往上加参数没用、瓶颈在证据组织,这个结论值得记一笔。Instagram 那篇方法论上很干净、四臂消融也算克制,但六个 term 是 case series 不是样本,「both 更好」和「总权重更大」还没完全摘开,读的时候留个心眼。今天优先看 item 级缓存那篇和 SID 逐步个性化那篇,做序列建模的同学再补一下快手的级联蒸馏。
论文列表
1. SPAR: Stepwise Personalized Autoregressive Recommendation with Prefix-Balanced Semantic IDs
- 论文链接:AlphaXiv
- 更新时间:2026-10-20 09:17 UTC
- 机构:University of Electronic Science and Technology of China,University of Science and Technology of China,HUJING Digital Media & Entertainment Group,Southwest Jiaotong University
- 工业优先级:强
SID树解码,错一步就救不回来🔍
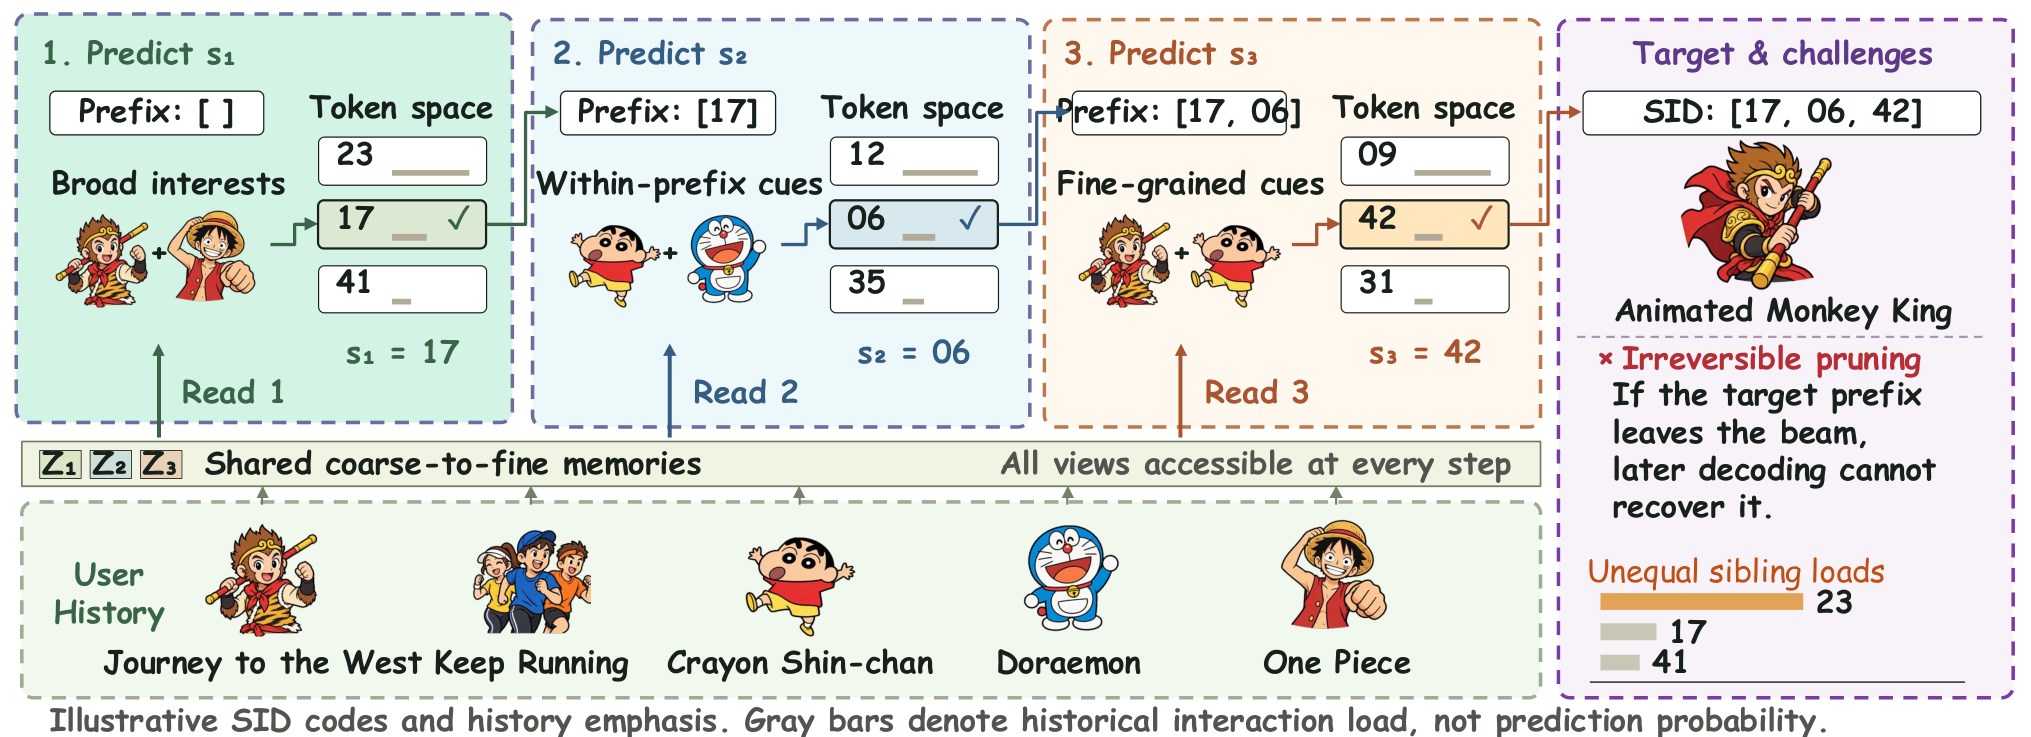
各位算法同学们,生成式推荐里最难受的一点是:SID树只要有一层选错父节点,后面beam开再宽也救不回来,因为目标前缀已经被剪掉了。这篇工作就在处理这个不可逆的剪枝问题,并顺带把候选分支负载不均的老毛病拉了进来一起修。
📄 SPAR: Stepwise Personalized Autoregressive Recommendation with Prefix-Balanced Semantic IDs
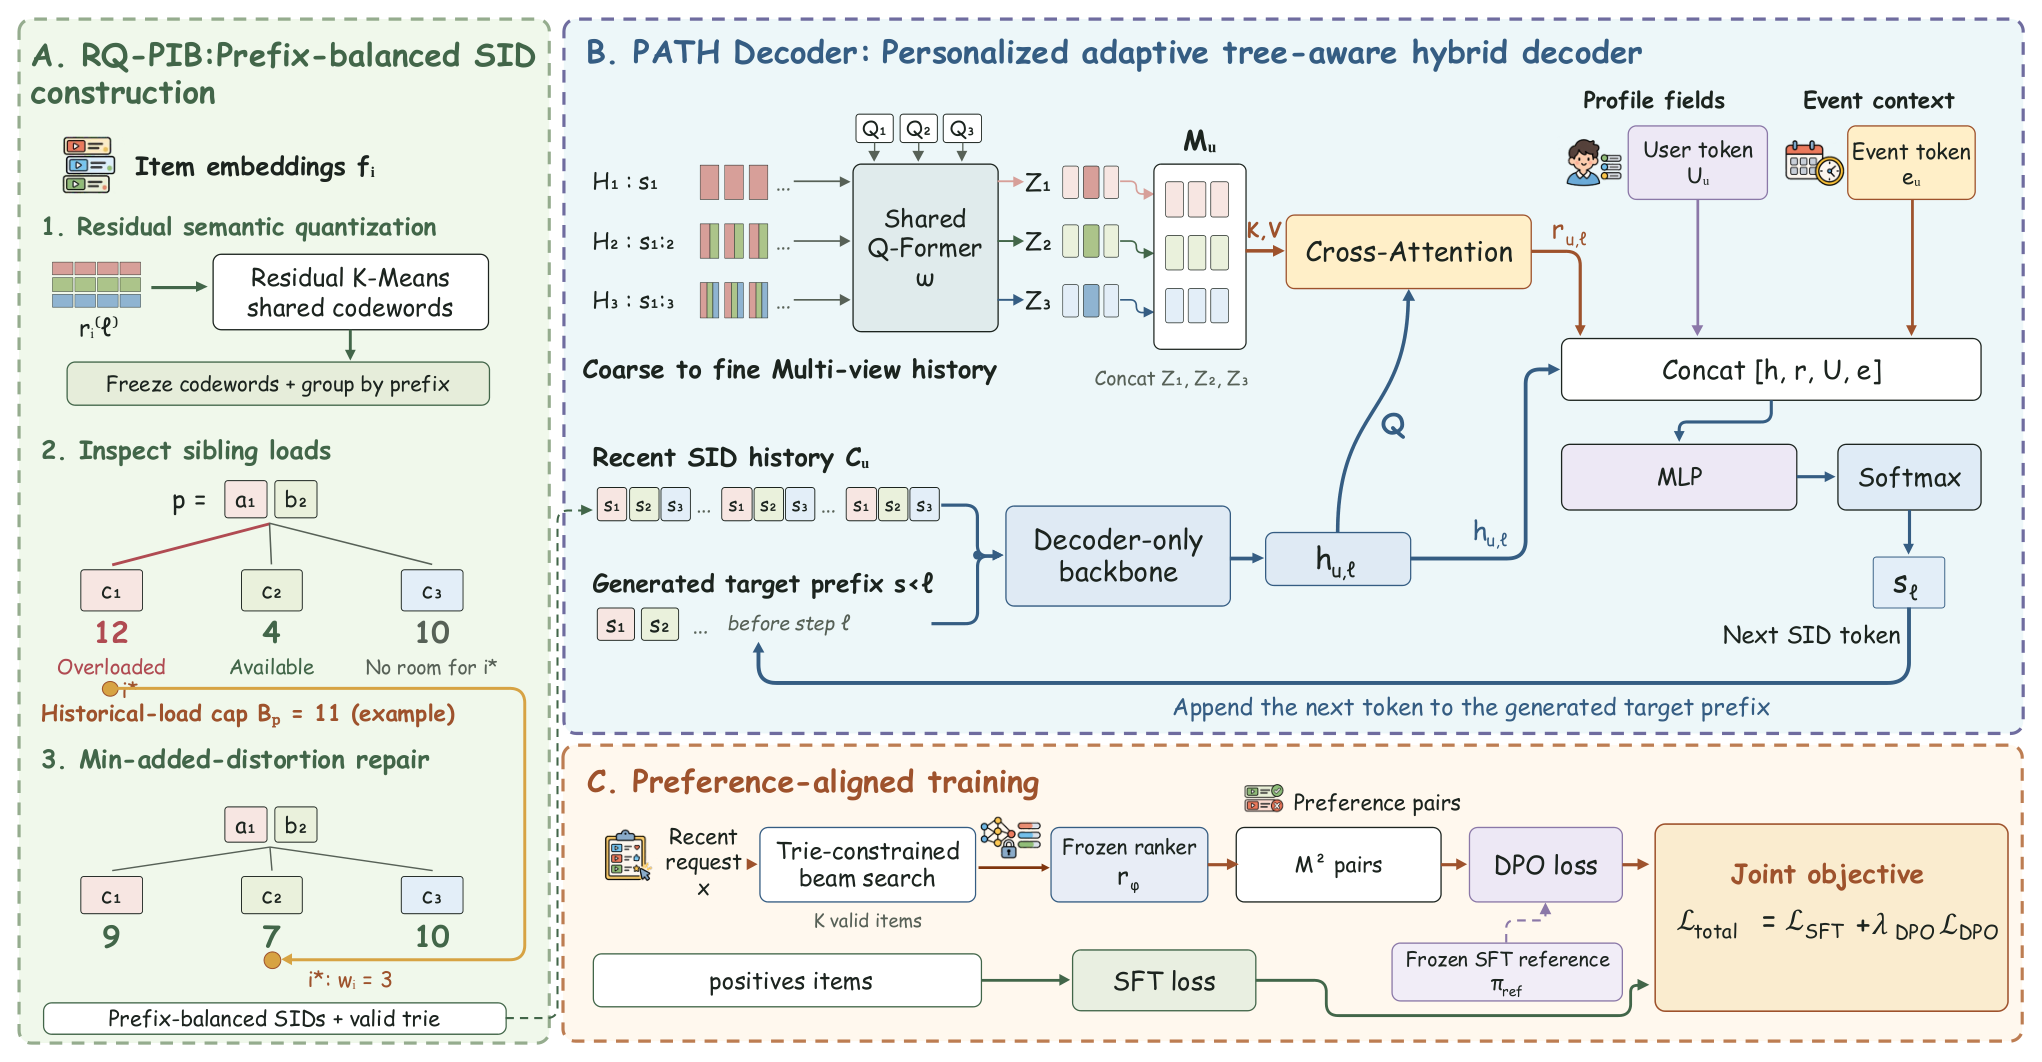
🔧 PATH Decoder:把长期行为按SID树深度压成由粗到细的memory bank,每一步解码用prefix-conditioned cross-attention按当前已生成前缀去捞证据,再与近期行为、用户画像、请求时event context拼接,并非给出一个固定user向量,让每步看到不同证据。
🧩 RQ-PIB:作者指出全局码本均衡是假象,同一个codeword挂在不同的父前缀下,条件分布可能极其偏斜。该方法在RQ基础上只在同父兄弟分支间重排交互负载,用最小语义重构误差换局部均衡。
⚙️ 两件事是耦合的:SID构造决定每层有哪些候选分支,解码器决定怎么给分支打分,只优化一头会出现候选空间与个性化证据错位。
📊 优酷大规模离线数据上,HR@10/20/50/100平均相对提升2.66%(对比最强基线)。
📈 目标前缀保留率平均涨5.79个百分点,说明不可逆剪枝确实少了。
✅ 流量加权后的最大子分支占比在各SID层平均降32.84%,热门路径的压制被削弱。
🎬 线上7天A/B,10%生产流量,人均观看时长+3.95%,播放转化率+3.38%。
总结感想:做生成式召回、尤其已经在跑SID+TIGER/OneRec这条线的人可以跟。要盯两个指标:target-prefix retention,以及各层兄弟分支的负载分布,只看整体HR容易被平均掉。坑在于RQ-PIB会改动物品码,SID一变就得重训或重对齐,语义重构误差也得现场验;另外prefix检索是逐步做的,线上延迟要单独压测。
2. Baseline and Incremental: User, Item, and Request Debiasing in Instagram Feed Ranking
- 论文链接:AlphaXiv
- 更新时间:2026-10-20 00:20 UTC
- 机构:Meta
- 工业优先级:强
去偏不是删baseline,IG给了双权重
各位算法同学们,去偏的默认动作是把baseline从打分里减掉,但这篇Meta的线上四臂实验结论相反:raw项和incremental项都不冗余,两个都留、各给一个权重,比只留任一个都好。对一个每天要跑海量请求的排序系统来说,这种只改配置、不动模型的改法,成本低到可以在线上反复试。
📄 Baseline and Incremental: User, Item, and Request Debiasing in Instagram Feed Ranking
🔧 核心主张是把一次预测拆成baseline和增量:s(c)=Σ[w_r·p + w_i·Δ],原始预测保留,增量单独加权。一个系数没法同时权衡“这个用户本来就爱点赞”和“这条内容确实更好”,两个权重才行。它是VM里的一个配置项,不是新模型,上线按小时算,回滚也一样快。
🧩 viewer、item、request三类去偏被统一成一个参数化算子,四个设计选择:baseline取谁、比较尺度d(概率用logit差,回归用原单位差)、幅度m、以及k和shift。文中还点出一个常见错误:把promotion项改写成demotion时沿用m=p,但候选掉到下限时惩罚才该生效,得换常数幅度并把比较方向反过来。
⚙️ media-type这类格式偏置不走打分时门控,而是走同一个流程选出的去偏label,作者给了判断标准:什么时候label的代价比打分时gate更值。
📊 like预测与用户历史点赞率的秩相关有0.69,这个信号很大一部分在复读用户习惯,而不是在区分候选。
📈 6个已上线term上的四臂消融(都不加、只加raw、只加incremental、都加),双项版在生产权重下13个(term, metric)对里有11个点估计更优。
✅ 26个直接对比里17个显著支持双项、只有1个显著反对,且出现在impressions上。这套term在Instagram Feed生产上跑了将近一年。
总结:如果你的场景是多信号加权求和、各信号基数差异又大,这套raw加增量双权重是低成本可试的方向,顺序是先拿离线诊断筛信号(别用它给信号排名),再上四臂实验。两个坑:权重是联合调的,加一项会扰动其它项的运行点;launch期效应被“选择上线”本身抬高,别只盯上线那几天的数字。
3. ECHO: Efficient Cascade with Homogeneous Operators for Distillation-Guided 100K-Sequence Modeling
- 论文链接:AlphaXiv
- 更新时间:2026-10-20 17:28 UTC
- 机构:Kuaishou Technology
- 工业优先级:强
- 备注:12 pages, 8 figures
10万序列建模,算力砍约160倍
各位算法同学们:用户序列拉到10万条,target-aware 排序的算力反而能降约160倍——代价是GAUC只提升0.113%~1.520%,这个性价比值得算一算。快手这篇 ECHO 讲的是在“检索”和“压缩”之间如何找第三条路。
📄 ECHO: Efficient Cascade with Homogeneous Operators for Distillation-Guided 100K-Sequence Modeling
🔧 核心是把被压缩的对象换成“记录”,而不是“向量”:DS 在用户维度留下 K=10000 条原始行为记录,item id、时间戳、side feature 全都保留,下游还能逐条匹配,而不是对着拼好的兴趣向量猜。
🧩 DS 的监督信号来自候选感知的全历史 teacher,做 per-target 蒸馏,所以留下来的记录天然偏 target 相关;但线上不用为每个候选扫全量历史。
⚙️ TFR 只在这 1 万条里检索,每个候选最多取 M=100 条,并且 retriever 和 target attention 的 scorer 复用 teacher 的 relevance 参数,延续 TWIN 的 scoring consistency,保证“选的”和“用的”打分口径一致。
📊 L=100K 时,线上序列分支 FLOPs 比代表性端到端模型低约160倍。
📈 KuaiRand-1K 加某工业短视频平台上,多任务相对 GAUC 提升 0.113%~1.520%。
✅ 线上 A/B:app 使用时长 +0.613%。
📉 三条部署优化(公共用户输入、紧凑记录编码、key 侧投影吸收)压的是内存、存储和数据搬运,不是 FLOPs,做落地时不要只盯着算力那一栏。
总结感想:适合已经在跑 SIM/TWIN 这类检索式长序列、并且卡在 GSU 成本随长度线性增长的同学,特别是长尾 target 容易被压缩表示覆盖掉的场景。要盯的不只是 GAUC 和时长,还有 K/M 的命中率、蒸馏 student 与 teacher 的相关性一致性,以及 1 万条记录的存储和读放大开销。坑在于 DS 依赖全历史 teacher,teacher 的容量和训练成本是前置支出。
4. KuaFu: Compressing Long User Behavior into Understanding at Billion Scale
- 论文链接:AlphaXiv
- 更新时间:2026-10-20 12:09 UTC
- 机构:未披露机构
- 工业优先级:强
- 备注:12 pages, 6 figures, 3 tables
用户行为只编码一次,省下190张GPU
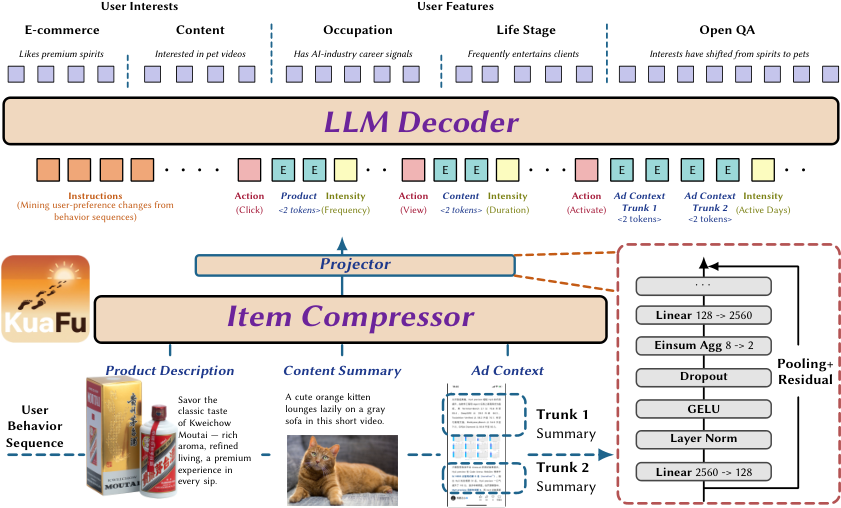
各位算法同学们,同一个用户的历史行为,广告、推荐、画像几个任务各自从头编码一遍,十亿用户规模下这就是纯纯的重复劳动。KuaFu 的做法是把编码单位从「用户」挪到「行为 item」:一条内容只编码一次,谁要用,谁就去缓存里取。
📄 KuaFu: Compressing Long User Behavior into Understanding at Billion Scale
🔧 表示的基本单位从 user-level 换成 item-level:每个行为 item 独立编码成可复用的压缩表示,按时间顺序拼起来就是用户历史;新行为来了只增量追加,不用重算整条序列。
🧩 两轴 projector 是省钱的关键:token 轴把行为序列缩短最多 15 倍,单个 item 从 150KB 压到 10KB;width 轴再把缓存表示压到 0.5KB。
⚙️ 四阶段训练:重建预训练、偏好理解后训练、压缩-生成联合训练、幻觉感知强化学习,专门针对压缩里常见的编造、遗漏、时序错位、推理断裂四类失效做惩罚。
📊 六个 MRQA 加五个 RecBench 基准,在同等压缩比下稳定超过已有压缩方法,最高提升 17.7 EM 和 1.90 AUC。
📈 在腾讯广告推荐平台线上跑了十个月:单 GPU 吞吐最高提升 350%,省下 190 张 GPU,整体 GMV 涨 1.37%。
✅ 另一个细节是省卡和涨 GMV 同时发生,说明偏好信号没被压丢。
总结感想:这套思路对「多个下游任务重复编码同一份长序列」的工业团队最直接有用。评估时得盯压缩比和 EM/AUC 的联合曲线,别只看压缩率。坑在于四阶段加幻觉 RL 的训练成本不低,item 级缓存的时效一致性论文没细讲,接入前先小流量验证缓存刷新延迟和对新 item 的冷启动表现。