推荐算法日报 · 2026-10-23
总览
今天这四篇整体质量在线,共同的味道是「别再给所有东西一样的算力和通道」——生成式推荐里的长尾 item 在 beam 阶段就被剪掉、序列推荐里每条历史 item 却被默认吃满所有层、LLM 推荐把 item 表示和用户绑死导致没法跨用户复用,三篇都在动同一个开关。第一篇是今天最值得细读的,它不只是甩了个 inference-time 插件,而是用两个命题加上反事实实验,把「检索修好了排序还会把尾部踢出去」这个耦合失效讲透了;消融里把 item id 打乱增益就消失、训练好的图模型反而不如裸共现,这两个结果比方法本身更有信息量。第三篇的 oracle 探针同样漂亮,先证明固定深度只在极少数序列里是最优解、再给方案,48 组对比全正,但强 backbone 上只有一两个点的提升、有个 baseline 的大涨主要是自己太弱撑出来的,读的时候别被相对数字带走。第二篇和第四篇更像工程侧的两条路:一个把多模态离散成 Semantic ID 硬接进现有 ID 栈,一个把 item 压成向量塞进 ranker 换吞吐;第四篇那套 MIS 加树状 mask 保证打分数学等价的 runtime 细节是全文最值钱的部分,但两篇都只有离线结果,第二篇主打的那条主线在消融里也没被真正证明。所以我的建议很明确:今天优先看第一篇和第三篇,做 LLM 推荐系统落地的再补第四篇的 runtime 部分。
论文列表
1. Generative Recommenders Forget the Long Tail: Restoring Memorization in Retrieval and Ranking
- 论文链接:AlphaXiv
- 更新时间:2026-10-21 06:49 UTC
- 机构:University of Science and Technology of China,Independent Researcher
- 工业优先级:强
生成式推荐忘了长尾?CAPE来补记忆
各位算法同学们,把 beam 加宽 50% 能把长尾救回来吗?这篇论文的答案是:几乎不能,命中数甚至会 −1。它把“生成式推荐为什么记不住长尾”拆成检索和排序两次遗忘,还给出一个不改模型、不重训的补丁,逻辑挺干净。
📄 Generative Recommenders Forget the Long Tail: Restoring Memorization in Retrieval and Ranking
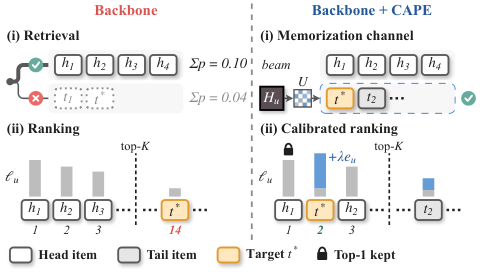
🔧 先定位病根:beam search 是按子树概率质量保留前缀的,长尾 item 的前缀质量小,还没轮到打分就被剪掉;而且 99.97% 的长尾 item 首个 SID token 和某个 head item 共享,所以调 token 分数只会整片前缀被抬高,救不到具体 item。
🧩 记忆通道:在 beam 之外按共现支持度再捞 B′ 个长尾候选,用冻结的生成器做 teacher forcing 打分,保证每个候选都有模型 likelihood,不靠前缀说话。
⚙️ 记忆校准排序:把生成器 log-likelihood 和共现证据各自 min-max 归一化后加权融合,只多一个超参 λ,外加 top-1 锚定保住生成器的首位,主 slot 不变,工程上好接。
📊 50 宽 beam 里只有 5.2–11.9% 的长尾目标进得来,beam 加宽 50% 在 I&S 和 Office 只多进 66 和 63 个,命中的长尾目标变化是 −1 和 +1。
📈 补 25 个共现长尾候选进池后,新进 98–159 个长尾目标,但纯 likelihood 只把 0、9、6、0 个排进 top-10——排序这一步确实在二次遗忘。
✅ CAPE 在四个设置里长尾 HR@10 比 backbone 高 2.5–13.3 个点,比用同一候选集的最强 re-ranker 高 1.6–7.3 个点;整体 HR@10 在 I&S 持平、另外三个更高,额外延迟 11–16%。
要跟的话,跟它“检索和排序必须一起修”的诊断框架,单修一边在两个设置里长尾准确率原地不动。落地前先看两件事:共现统计来自训练交互,冷启 item 的共现证据天然稀薄,长尾里最尾那段可能拿不到收益;λ 按验证集选,别拿线上直接试。评估时把长尾 recall 和整体 HR@10 放在一起看,别只报一个。
2. Progressive Learning from Content to Relevance to Personalization for CTR Prediction
- 论文链接:AlphaXiv
- 更新时间:2026-10-21 03:19 UTC
- 机构:未披露机构
- 工业优先级:强
别把图片塞成向量了,切成30个token更管用
各位算法同学们,多模态CTR最反直觉的一点:把图片编码成一个768维稠密向量加入ID网络,效果常常还不如不加。FineSID的做法是别塞向量,把图切成30个离散token当ID用。
📄 Progressive Learning from Content to Relevance to Personalization for CTR Prediction
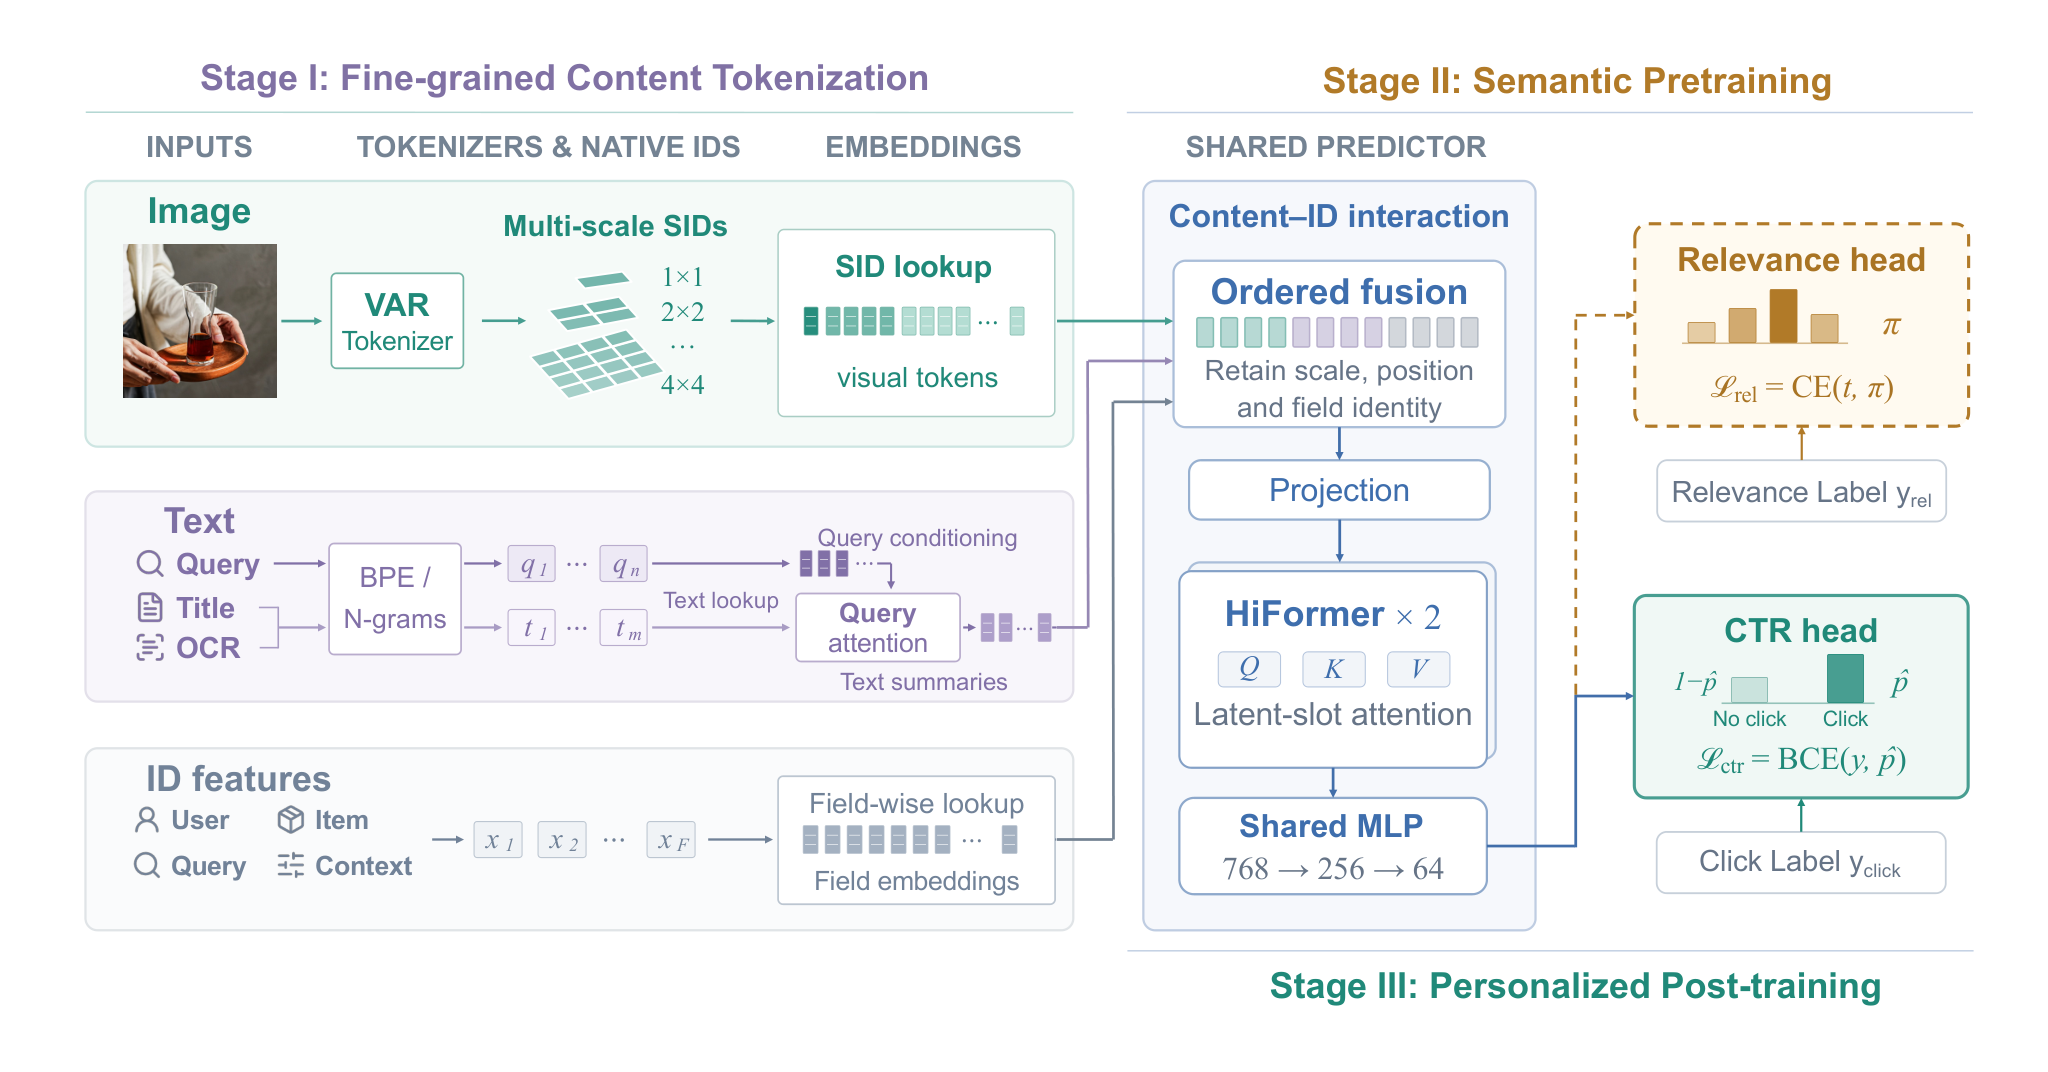
🔧 内容做离散化而不是压缩:用预训练VAR多尺度视觉tokenizer,在1×1、2×2、3×3、4×4四个尺度上取码,共30个带空间位置的SID,和类目ID共用同一套lookup接口,直接进特征交互;码在离线抽好,线上不用跑自回归生成,也就没有额外延迟。
🧩 文本也保留字段身份:query、标题、OCR各自独立tokenize(BPE/ngram),不压成一条摘要向量;再以query为Q做cross-attention拿到query-conditioned表示,按固定顺序和ID特征拼接,尺度和字段位置都不丢。
⚙️ 训练拆三段而不是端到端硬拼:先在query-item相关性监督下全参数预训练共享predictor(HiFormer潜槽注意力+768→256→64 MLP),再用点击label微调同一套参数,相关性先验不用重学。
📊 淘宝工业数据加公开MMCTR,AUC和GAUC相对baseline一致提升,冷启item上提升更明显。
📈 NSCTR指标看同商品不同创意的区分度(item ID完全一样,只变内容),说明模型真的学到了内容差异,不只是背ID。
✅ 线上A/B:点击和GMV均为正向。具体百分点摘要没写,得翻正文表格。
总结感想:这套方法真正的门槛在tokenizer的离线供给和SID与ID特征的embedding对齐,不在模型结构。评估要盯SID覆盖率、冷启占比和NSCTR这类同质样本指标,别只看大盘AUC。ID稀疏、创意更新快的场景值得跟;ID特征本来就稠密、内容同质的场景,收益大概率被稀释。
3. Think Harder Where It Matters: Item-Level Adaptive Recursion for Sequential Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-10-21 17:58 UTC
- 机构:Gaoling School of Artificial Intelligence, Renmin University of China
- 工业优先级:中
序列推荐每层都跑满?76%没必要
各位算法同学们,一条用户行为序列里,76% 的 item 过一层就收敛了,剩下 6.7% 得跑满三层才稳——可现在的序列推荐还是给每个 item 分配一样的计算深度。这篇就是把“固定深度”这个默认设定拆开看的工作。
📄 Think Harder Where It Matters: Item-Level Adaptive Recursion for Sequential Recommendation
🔧 诊断一:把某个 item 在第 ℓ 层之后的表示冻结,看 Top-30 推荐集变不变,定义出“饱和深度”。在训练好的三层 SASRec 上,76.14% 的 item 第 1 层就饱和,93.28% 在 2 层内饱和,只有 6.72% 要跑到第 3 层,而且同一序列里浅饱和和深饱和的 item 经常同时存在。
🧩 诊断二:只放开最近 5 个位置的深度(1/2/3 任选),用 ground truth 当 oracle 选最优分配,固定深度只在 4.6% 的序列里是最优解,剩下 95.4% 都能靠非均匀分配把目标 item 排得更前。
⚙️ LoopRec 的做法是递归复用同一个权重共享 block,在每个递归边界放一个轻量二值 gate,逐 item 判断退出还是继续。因为所有深度共用一套参数,早退和晚退的表示天然落在同一特征空间,也不需要额外的深度标签。
📊 限制在尾部 5 个位置的 oracle 相比固定深度:NDCG@20 +7.1%,MRR@20 +6.5%,HR@20 +8.8%。
📈 具体 case 上排名提升明显,比如 24→13、7→4,同时尾部计算量只有固定深度的 40%~67%。
✅ 三个公开数据集 × 四类 backbone,LoopRec 都稳定优于同深度预算的固定深度版本。
✅ 学出来的分配和 oracle 偏好对得上:低频 item 和更近的交互自然被分到更深的递归。
总结感想:这篇的重点在于“计算预算按 item 分配”这个视角,适合在序列推荐里卡在固定层数、又想省推理成本的同学。落地要盯两个数:平均实际递归深度(决定延迟和到底省没省算力),以及低频 item 上的收益是否稳定。坑主要在 gate 阈值和最大递归层数,上限设太高早退机制基本白忙;另外务必和同参数量、同平均深度的固定版本比,不然增益说不清是来自自适应还是来自更多计算。
4. DuoLM: Fast and Effective Personalized Recommendation with Language Models
- 论文链接:AlphaXiv
- 更新时间:2026-10-20 19:33 UTC
- 机构:未披露机构
- 工业优先级:中
- 备注:19 pages. Jiang Wu and Yutong Song contributed equally. v2: Added references, corrected an author name, and standardized figure fonts
一个向量替掉全文,吞吐涨60倍🔥
各位算法同学们,LLM做推荐时,瓶颈通常不是模型不够大,而是每个候选都要输入全文,线上无法承受计算量。DuoLM的做法有点反直觉:离线把商品文本压成一个向量,线上只运行排序模型,单卡H100跑到教师模型的60倍吞吐,质量还没掉多少。
📄 DuoLM: Fast and Effective Personalized Recommendation with Language Models
🔧 编码器LLM把每条商品文本压成最后一个token的隐状态向量,再经RMS归一化和可学习增益组成的连续接口喂给排序LLM;商品表示与用户无关,可以离线预先算好,并在不同用户的请求间复用。
🧩 排序端把历史物品向量、反馈文本和候选向量拼进同一条因果序列,一次前向直接输出分数,不走自回归解码,所以候选之间互不干扰。
⚙️ 服务端做了三件事:虚拟token ID直接查GPU常驻的向量表,请求体缩小90%以上;多候选打分共享历史前缀KV,用树状attention mask隔离候选分支;分段prefill的CUDA Graph回放减少CPU调度和kernel launch开销。
📊 Amazon Books上NDCG@10是0.5586,超过全文教师模型的0.5440;Video Games是0.5298对0.5313,基本打平。
📈 单张H100上约每秒26,400个候选打分,是vLLM+自动前缀缓存服务的教师模型的60.1倍,对SGLang是109.9倍。
✅ 训练用交叉熵加教师分布KL蒸馏,温度τ和权重β都写明了,把教师在同一候选组内的相对偏好迁移到小模型。
总结感想:对做LLM排序又要扛高QPS的团队比较对口,尤其是候选多、历史长的场景。要盯的是NDCG@10和单卡候选吞吐,顺带看请求体大小与KV复用率;潜在问题在商品向量的离线存储和更新一致性,以及蒸馏要预先缓存教师在固定历史下的分数,历史分布一变就得重跑。