推荐算法日报 · 2026-10-21
总览
今天这三篇连起来看,主线很清楚:生成式推荐正在从“换个模型结构”走向“把整条链路重新拆一遍”。最值得优先看的是 Netflix 那篇首页整页生成,200M 的 decoder 直接在线上把整页 row 和 entity 当序列吐出来,核心互动涨了 0.24%、端到端延迟还降了两成,在一个已经榨过多轮的生产系统上这个量级很有说服力,而且它把 tokenizer 设计讲得很实,业务规则能直接映射成 mask 做约束解码;但要看清它的边界——候选集那层并没有拆掉,还不算真正的端到端,线上新老片、剧集电影的曝光漂移也得盯。第二篇是结构对齐的历史建模,用子空间残差量化加码字负载 cap 造出 token、subspace、item 三级结构,再按这个结构做 mask 重建,离线四个类目比 RPG 高 18.6% 到 30.0%,控制实验也做得规矩,不过整套东西对课程学习的调度极其敏感,消融里纯熵引导还不如直接推理,属于“设计对了才涨、调错了就掉”的类型。第三篇是我觉得最该读的方法论样本:它把“只给 Semantic ID 能不能推理重排”做成受控实验,结论是 base 模型压根不会这个接口,1.7B 有 42% 原样吐回输入顺序、8B 有 37% 卡在推理循环里,得靠 SFT 加 RLVR 才救回来;更有意思的是 rationale 审计显示它排得对却基本没“看见”item 是什么,纯靠行为信号在摸,这个发现比指标本身值钱,当然它只有 400 用户、单域离线,证据强度有限。总的来说,今天这批货质量在线,第一篇看工程落地和 tokenizer 设计,第二篇看结构化 ID 的训练目标怎么跟表示对齐,第三篇看评测设计和那个“排序对了但没理解”的诊断。建议今天优先看 Netflix 那篇和 Semantic ID 推理重排那篇,前者告诉你工业界走到哪了,后者告诉你这条路线上还有哪些坑没填。
论文列表
1. GenPage: Towards End-to-End Generative Homepage Construction at Netflix
- 论文链接:AlphaXiv
- 更新时间:2026-10-16 18:46 UTC
- 机构:未披露机构
- 工业优先级:强
- 备注:Another version of the paper with a different author list was accepted at ACM RecSys 2026 available at https://dl.acm.org/doi/10.1145/3773078.3831915
Netflix首页被一个模型端到端生成
各位算法同学们,Netflix 把整个首页推荐栈换成一个 Transformer 之后,线上核心互动指标只涨了 0.24%——但这已是他们近几年最大的算法涨幅,而且端到端延迟还降了 20%。这个反差本身就说明了成熟推荐系统里「端到端生成」的真实水位。
📄 GenPage: Towards End-to-End Generative Homepage Construction at Netflix
🔧 把首页当成一段序列来生成:用户历史、画像、请求上下文拼成 prompt,模型自回归直接吐出整页的多行结构(行 ID 加行内实体 ID),召回、排序、重排这套多阶段流水线一次性拿掉。
🧩 自建 tokenizer 而不是套通用分词:一条「用户 30 天前看了 50 分钟某剧」用通用分词要 16 个 token,他们的方案压到 4 个(实体、行为、时间桶、时长桶),同时让 token 和行、实体这些业务概念一一对应,后面才好做规则约束解码。
⚙️ 训练照搬 LLM 那套:先在真实曝光页面上预训练学「首页长什么样」,再用两种 post-training——WBC 在 token 级估价值但解码仍整页自回归,RL 则用页面级 reward model、拿真实互动而不是人类偏好对来优化。工程侧配套冷启动的语义 embedding 融合、多节奏增量训练保新鲜度、约束解码保业务规则、混合行解码压延迟。
📊 线上 A/B 是对着一套已经很成熟的生产推荐栈打的:核心互动指标 +0.24%,p<0.001,端到端 serving 延迟 -20%。
📈 离线最反直觉的一条:现阶段把 prompt 做富,收益比扩模型容量更大,说明瓶颈在输入信息量而不是参数量。
✅ RL post-training 让首页多样性自己涨了,而多样性并不在优化目标里,侧面印证页面级优化能吃到跨行、跨实体的交互。
总结感想:做首页、货架这类结构化多模块推荐的团队可以细看,尤其是想砍多阶段栈的。但要盯两件事:reward model 和长期指标是否同向,以及自家核心指标的敏感度——0.24% 在成熟系统里能不能复现,跟指标底噪关系很大。RL 版本还没上线,另外长历史这类数据仍是人工摘要塞进 prompt,这块是留给后续的坑。
2. Structure-Aligned History Learning with Subspace-Structured Semantic IDs for Generative Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-10-18 07:58 UTC
- 机构:College of Computer Science, Chongqing University,China Telecom Artificial Intelligence Technology (Beijing) Co. Ltd,MAIS, Institute of Automation, Chinese Academy of Sciences,University of Science and Technology Beijing 等 10 家机构
- 工业优先级:中
- 备注:34 pages, 10 figures, including references and appendices
生成式推荐:量化和重建终于对齐了
各位算法同学们,同一套模型、同一批数据,历史重建的“切法”换成量化器自己分好的组,NDCG@10 就能明显往上走——差别不在模型结构,而在“按什么粒度重建历史”。这篇就是把量化和历史学习这两段本来各练各的流程接了回去。
📄 Structure-Aligned History Learning with Subspace-Structured Semantic IDs for Generative Recommendation
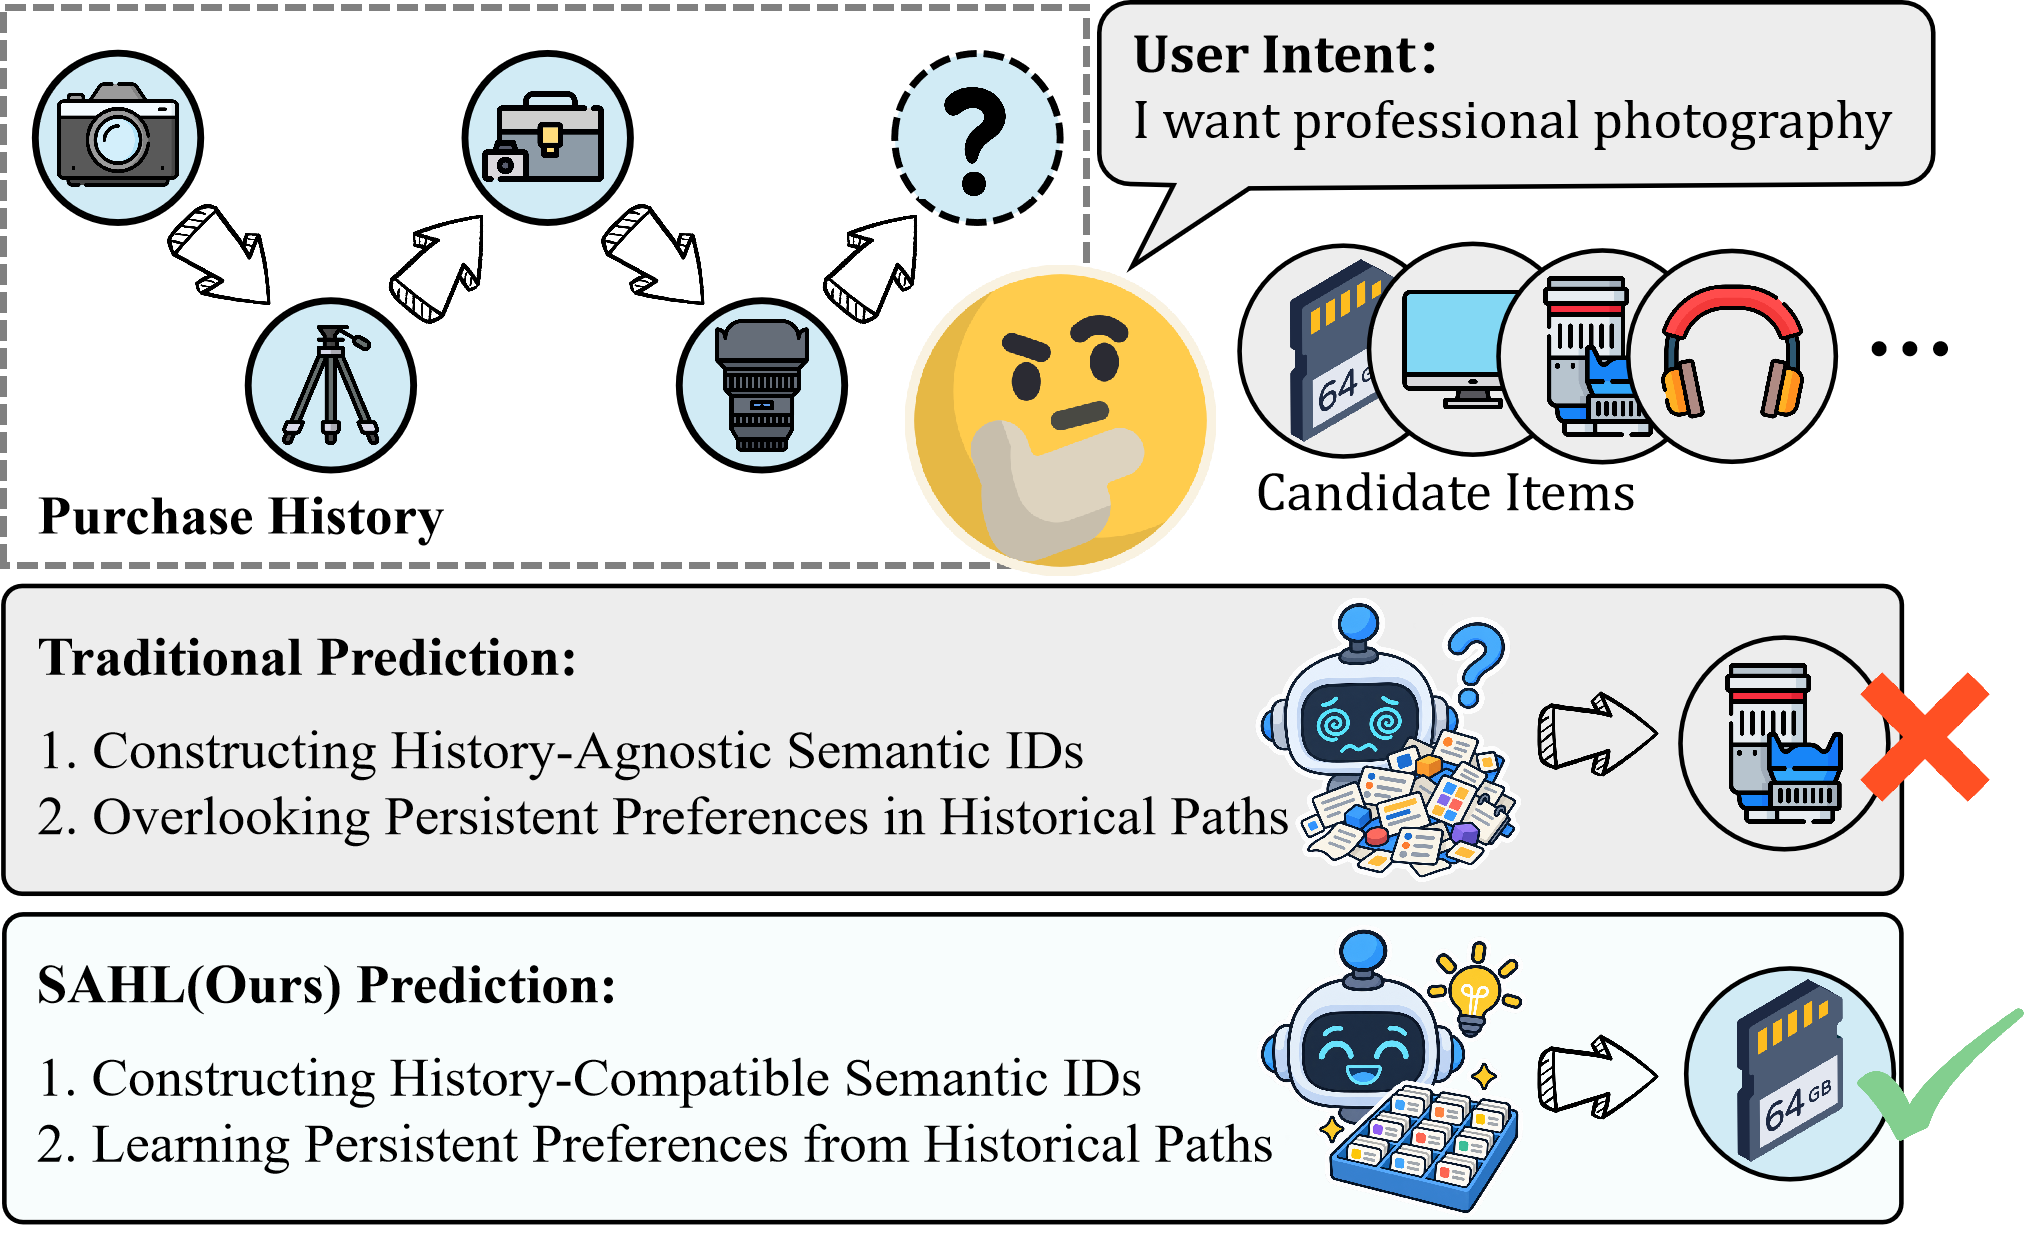
🔧 SRBQ 先把去相关后的维度切成子空间,在每个子空间内做残差量化,再对码字占用加约束,直接产出 token ⊂ subspace ⊂ item 的平衡层级,而不是只给单 token 和整条 ID。
🧩 历史重建用的正是这套层级:token 级、子空间级、item 级三种掩码目标,跟量化阶段的结构一一对应,不用再人为拼 token 块。
⚙️ 用预测熵挑出不确定的转换优先重建,配课程学习:随机掩码 → 熵引导重建 → 无掩码的下一个物品预测,把历史重建能力带到推理阶段。
📊 四个 Amazon Reviews 2014 类目上,NDCG@10 比同架构 RPG 高 18.6%–30.0%,比 MHL 高 2.7%–6.0%。
📈 SRBQ 把码字平均峰值负载降 28.8%–32.4%,最差峰值负载降 37.3%–41.3%。
✅ 控制实验里,重建时用真实 SRBQ 分组优于同等大小的人造分组;打乱用户历史后收益下降,说明模型确实依赖用户自己的路径。
你们在做 semantic ID 生成式推荐、正卡在码本利用率和长距离偏好这两件事上,这篇的 SRBQ 和“重建粒度跟着量化结构走”可以直接参考。要注意的是训练被拆成三阶段课程,掩码比例和熵筛选阈值得重调,工程成本不低;而且验证只在 Amazon 2014 四类目,换成工业长序列前,建议先在自己的数据上对齐 RPG、MHL 两个 baseline,重点盯码字占用分布和 NDCG@10 的增益是否还在。
3. Reasoning Reranking with Semantic IDs as the Sole Item Representation
- 论文链接:AlphaXiv
- 更新时间:2026-10-16 01:21 UTC
- 机构:未披露机构
- 工业优先级:中
- 备注:30 pages, 3 figures. Code: https://github.com/lilv98/ReRankID ; data: https://huggingface.co/datasets/lilvjosephtang/ReRankID
不给物品文本,8B模型照样能重排
各位算法同学们,把候选物品的标题、类目、caption 全删掉,只留三个语义 ID token,8B 模型的重排结果能和读两万 token 文本的强 LLM 打平。这篇把“纯 SID 到底能不能支撑 listwise 重排”当成一个可控实验来做,没有只是顺手用一下 ID。
📄 Reasoning Reranking with Semantic IDs as the Sole Item Representation
🔧 造了个 ReRankID testbed:同一批用户和候选集可以分别渲染成纯 SID、纯 caption、两者混合,历史长度(0 到 256)和候选数量(10 到 100)每次只变一个维度,排序质量和不合格输出(照抄输入顺序、推理死循环、格式坏掉)分开统计;这一点比多数重排论文做得更清楚。
🧩 先诊断再训练:未经后训练的 SID 模型几乎不做重排,直接把输入顺序原样返回,即使给上可读 caption 也没修好,只是把失败形式换了个样子;SID prompt 比文本短约 20 倍(最长历史下约 28 倍),但更长历史并没有带来持续收益。
⚙️ 同一协议下比较了 SFT、拒绝采样自训练(RFT)、on-policy 蒸馏(OPD)和带排序 verifier 的 RLVR;SFT 就能消掉照抄和死循环,在 8B 上 RLVR 又在 SFT 之上再涨一截,并用分级排序奖励优于二值 top-1 奖励。
📊 8B RLVR 版是最强的纯 SID 重排模型,和读文本的 LLM 相比,prompt 短约 20 倍。 📈 完全不给历史时它仍高于随机,caption 参考模型做不到这一点。 ✅ 历史拉长到文本 prompt 超过 50k token 时,它保持收益,caption 参考模型已经不再提升。 🔍 配对 rationale 审计:它比文本参考更会讲权衡,但描述它没见过文本的物品时更不准。
总结:如果你们线上已经是 SID 索引的生成式推荐,想在最后一级加 reasoning 重排又不想承担几万 token 的 prompt 成本,这个方向可以直接试;重点看 rank 指标、照抄输入顺序的比例和输出格式失败率。需要注意的地方在于,它的 rationale 只能当排序解释看,不能当物品描述用;另外它比的是 caption 参考模型,不是最强文本重排器,在 1.7B 上 RLVR 相对 SFT 基本没赚,别指望小模型白捡。