推荐算法日报 · 2026-10-20
总览
今天这批论文有个共同的气质:没人急着造新模型,更多是在给已经跑到线上的生成式推荐/广告链路补漏洞、加约束、做归因。最值得细读的是两篇 SID 相关的活:一篇用实证把”动态电商场景里 SID 映射到底能不能动”这件事拆干净了,beam 越大越会把漂移伤害藏起来这个发现相当扎心,用大 beam 做离线评估的人看完大概率会心里一紧;另一篇把”别重写 SID 映射”的结论往前推了一步,直接指出模型已经把 SID 空间的隐式拓扑记进权重里,短预算续训修不回来,属于那种读完会改变你实验设计习惯的工作。第二条主线是怎么让异构特征和协同信号在生成式召回里真正发挥作用——工具增强的生成式召回把”何时注入特征”交给模型自己决定,图感知的 LLM 序列推荐则用 attention bias 把协同信号从文本洪流里捞出来,思路都算克制,但一个线上增益薄、一个连线上都没有,属于方向对、离落地还有距离。还有两篇是”把 loss 看清楚”的基础功:一篇给 self-KD/self-ensemble 类损失做了极限分析,告诉你它本质上只是在正则 mask 或 seed 之间的一致性,”超出 dropout 的部分”是 κ−1 而不是 κ,这种数学澄清比再堆一个 trick 有价值;另一篇把训练监督和推理时真正用于排序的融合分布对齐起来,思路漂亮但实验全是离线小数据集,消融还暴露出对超参敏感。综合看,今天没有那种一眼惊艳的大成果,但有几篇”实验设计本身值得学”的文章。建议优先看淘宝天猫那篇 SID 拓扑实证和工具增强召回的 AGR,前者改你的评估方式,后者改你的架构直觉;做 LLM 推荐的同学再加一篇图感知序列推荐。
论文列表
1. MAPS: A Multi-Agent Personalized Script-Driven Video Advertising System Enhanced by Reinforcement Learning
- 论文链接:AlphaXiv
- 更新时间:2026-10-19 04:00 UTC
- 机构:未披露机构
- 工业优先级:强
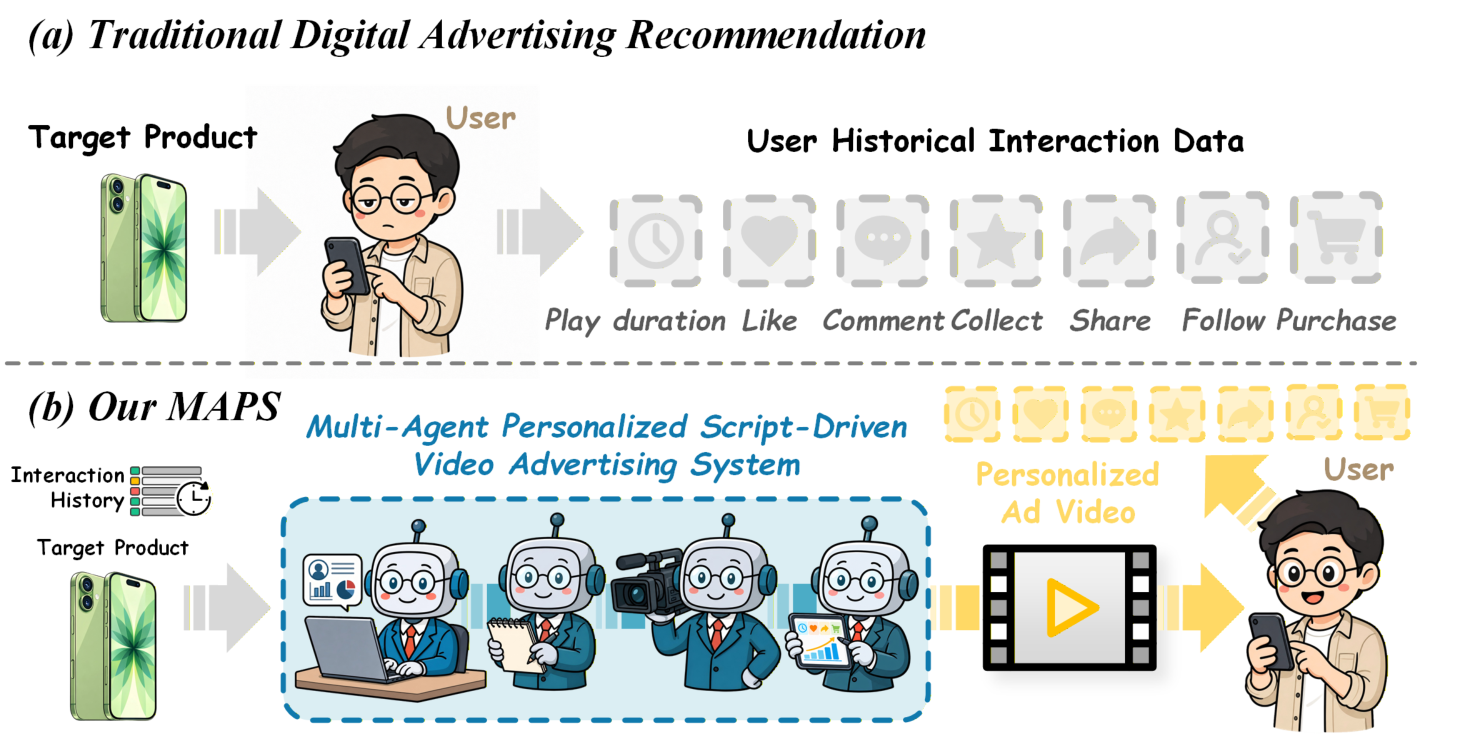
视频广告不检索了,改成让模型现写脚本
各位算法同学们,视频广告一直被“创意库存”卡着脖子:投放端只有预先拍好的一批素材,用户偏好天天变,也只能等下一轮生产。这篇工作干脆把检索换成生成,脚本由模型写、视频由脚本合成,快手线上 ARPU 提了 9.85%。
📄 MAPS: A Multi-Agent Personalized Script-Driven Video Advertising System Enhanced by Reinforcement Learning
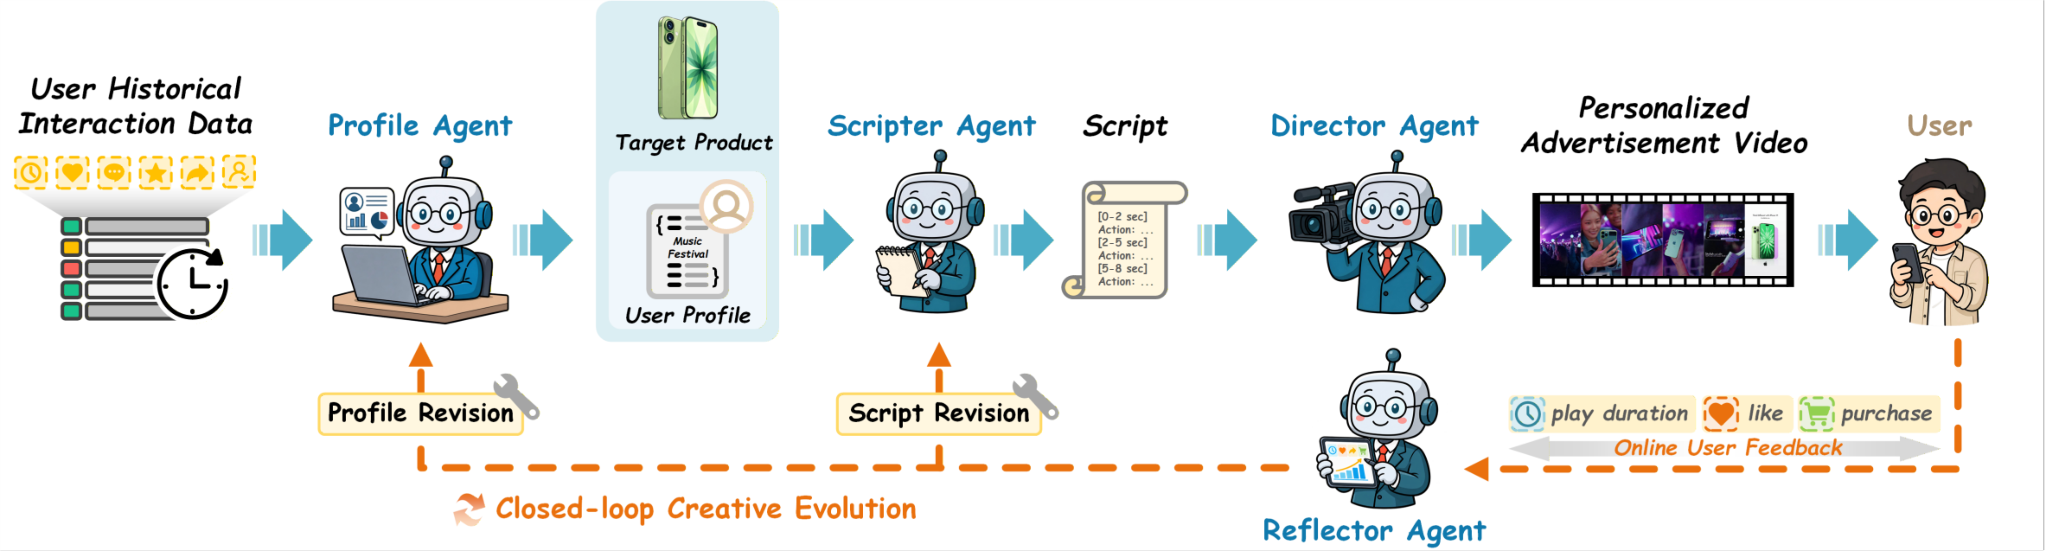
🔧 四个 Agent 串成闭环:Profile 建用户画像(兴趣主题、表达风格、隐性需求、决策倾向四个维度),Scripter 写分镜脚本,Director 合成视频,Reflector 把线上反馈归因到画像层和脚本层再回传,投放后还能继续迭代。
🧩 脚本被当成“中间接口”:它同时承载用户画像和商品卖点,比直接生成视频好控,也比检索素材粒度更细,等于把离散库换成了连续创意空间。
⚙️ Scripter 用 GRPO 训练,配多维奖励函数,一头管输出结构规范,一头管用户偏好对齐和商品信息忠实度,两个目标直接写进 reward。
📊 线上 A/B(快手某场景,对比生成式 baseline):CTR +2.87%,CVR +2.74%,ARPU +9.85%。
📈 离线在两类代表性任务上验证了画像拟合和生成创意质量,但主要是自证,别当硬指标看。
✅ ARPU 的提升幅度最大,说明收益不只来自点击率,还来自创意与商品卖点的匹配度。
总结:想真落地,先盯 Reflector 的归因链路是否可靠,反馈噪声大的场景里错误归因会把画像带偏;和纯检索方案比,它的上限取决于脚本生成质量,而不是候选池大小。做广告创意生成、多智能体编排的同学可以跟,但重点看它的奖励函数怎么防 reward hacking。
2. AGR: Agentic Generative Retrieval with Tool-Augmented Search
- 论文链接:AlphaXiv
- 更新时间:2026-10-19 17:56 UTC
- 机构:未披露机构
- 工业优先级:强
特征别全塞,让模型自己按需调🔧
各位算法同学们,特征不是塞得越多越好——把意图、位置、时效这三类特征全量静态注入,冲突样本上的困惑度反而涨了0.075,serving GPU 却翻着倍往上走。
📄 AGR: Agentic Generative Retrieval with Tool-Augmented Search
🔧 把每类异构特征封装成一个工具 token,模型在解码的每一步自己决定要不要发工具调用、调哪一个;返回的结果以 observation token 的形式插回上下文,直接改变后续 SID token 的分布,不需要的特征就不调,beam 里的无关分支也顺手剪掉。
🧩 论文先把静态注入的两个问题量化了:一是不随请求自适应,Intent 特征在对齐集上 ΔPPL 是 -0.187,到了冲突集变成 +0.075;二是不随层级自适应,golden token 概率比在理论最优深度并不更高。所以 AGR 把「何时用」和「在哪层用」塞进同一个自回归过程里解决。
⚙️ 监督信号靠构造工具增强轨迹:按特征适用性和 SID 层级上的信息增益挑调用点,先做 SID 预训练,再做工具增强微调,推理时每个候选都要走一遍工具交互。
📊 快手搜索的工业数据集上,recall 比 baseline 最高 +14.04%。
📈 三个公开 benchmark 上一致领先,线上 A/B 也是正向收益。
✅ 成本模型变了:serving 开销跟工具调用次数走,而不是跟特征总数走。
总结:偏落地的一篇,适合已经在跑生成式召回、被特征膨胀卡住 serving 的同学。要盯的是工具触发率和平均调用深度这两个指标;和静态注入对比时先把延迟预算固定住,否则召回涨了、QPS 掉下来,这笔账算不平。
3. Don’t Rewrite the SID Map: Topology Preservation for Generative Retrieval in Dynamic E-Commerce Search
- 论文链接:AlphaXiv
- 更新时间:2026-10-19 10:01 UTC
- 机构:Taobao & Tmall Group of Alibaba,Nankai University,University of Science and Technology of China
- 工业优先级:强
SID别乱重写,beam开大反而藏坑 🔍
各位算法同学们,你以为线上用 beam size 1000 评估就稳了?同一批映射更新,beam 1 下 HitRate 掉 41.78%~62.05%,beam 1000 下只掉 8.33%~10.85%——宽 beam 靠多生成候选把漂移的严重性盖住了,很多系统其实是在一种虚假的安全感里运行。这篇来自淘天、南开和中科大的工作,用 67 天真实电商搜索日志把「SID 映射该怎么更新」当成受控变量拆开做实验,结论是别修,别让它坏。
📄 Don’t Rewrite the SID Map: Topology Preservation for Generative Retrieval in Dynamic E-Commerce Search
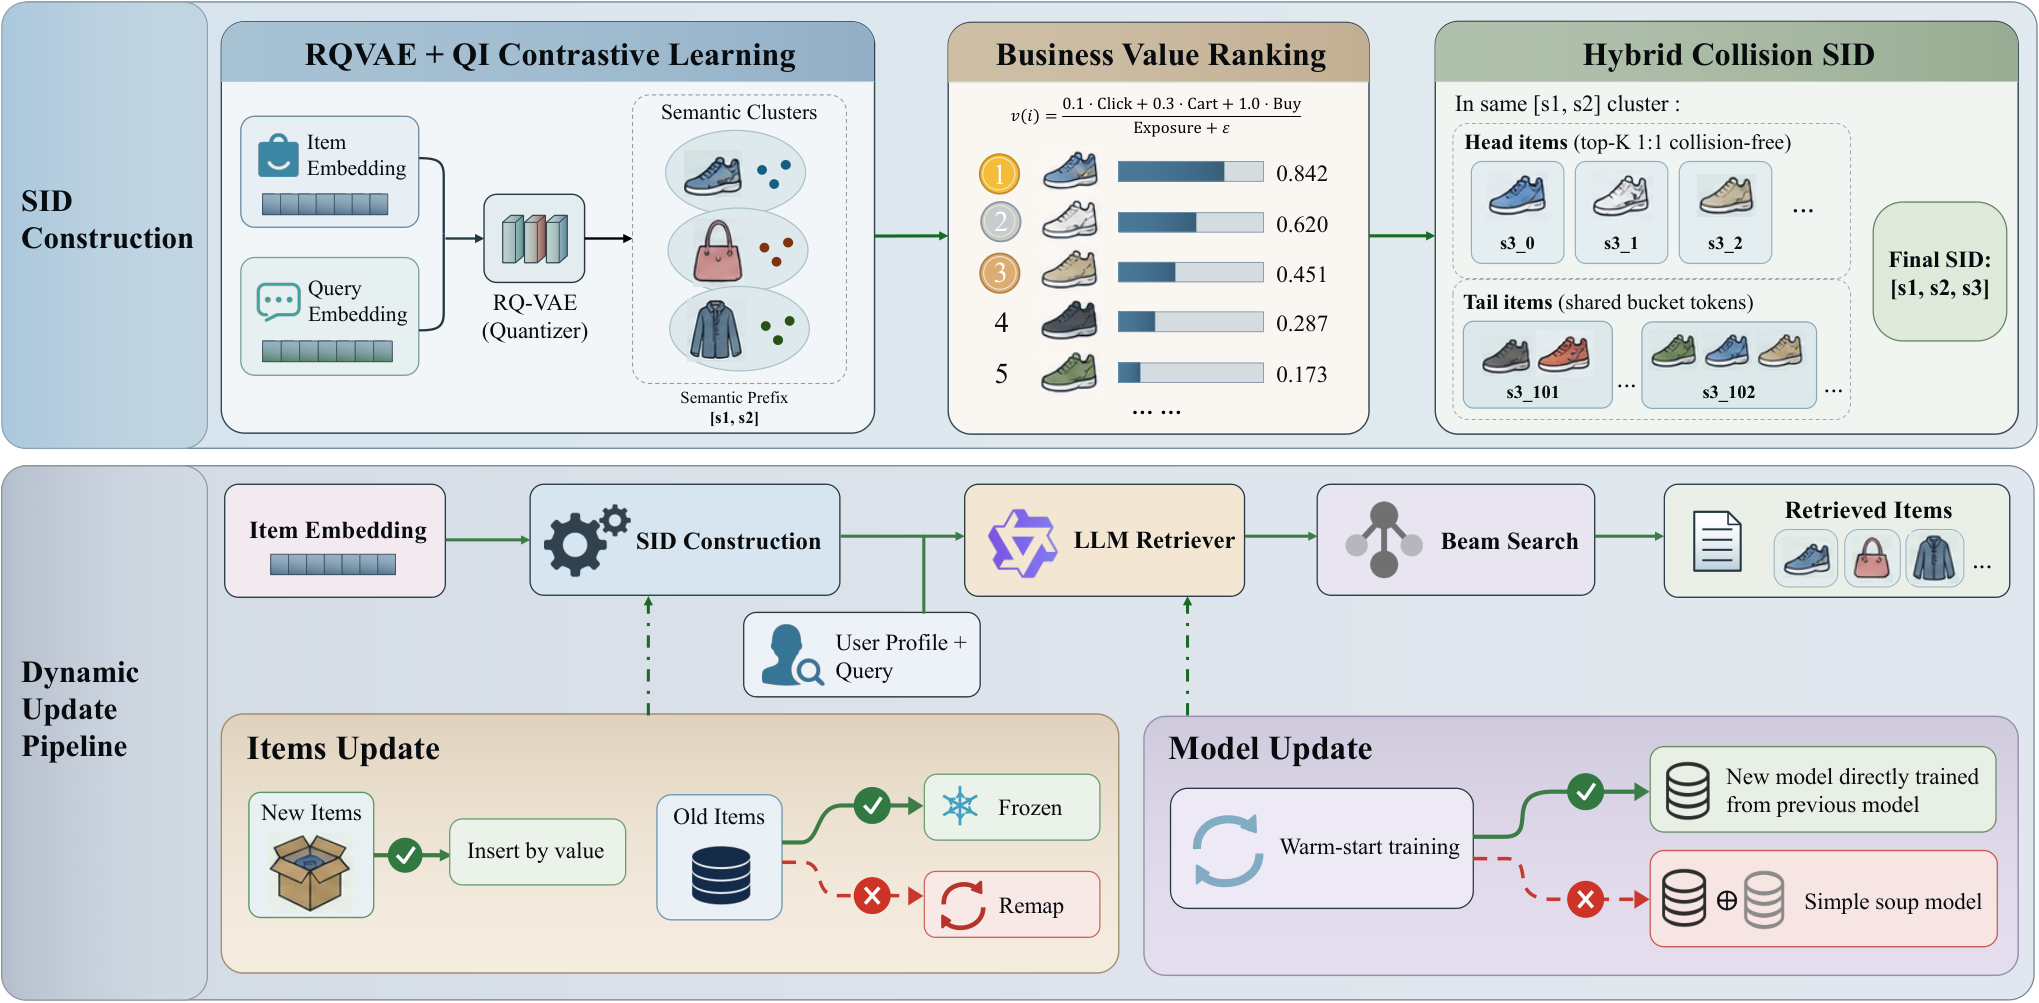
🔧 把映射策略本身当作实验因子:从全量重映射到完全冻结整条谱系都跑一遍,再单独控制训练策略,这样才把「映射改动造成的损伤」和「继续训练带来的修复」分开量化,而不是又提一个修复算法跟基线比。
🧩 量化出漂移的单调性与不可修复性:旧物品 SID 被改的比例从 0% 升到 72.75%,HitRate 单调下降,beam 1 下最多掉 42.66%;同样预算的 warm-start 之后,全量重映射依然明显差于保留拓扑的策略,说明模型已经把 SID 空间的隐式拓扑学进去了,短预算继续训练补不回来。
⚙️ 凝练成一条部署原则:新物品插入、旧物品冻结、能从上一版 checkpoint 热启动就热启动,否则直接冻结;绝不动模型已经学过的 SID。而且从旧模型微调出来的新模型,比新旧模型 souping 更管用。
📊 67 天日志受控实验,重映射比例 0%→72.75% 时 HitRate 严格单调下降,beam 1 下最大跌幅 42.66%。
📈 冻结旧物品加插入新物品,旧物品 HitRate 提升约 10%,新物品 HitRate 提升约 109%,并在两个不重叠的更新周期上复现。
✅ TmallAPP 三周线上 A/B:UCTCVR +0.29%,GMV +1.16%。
总结感想:如果你在做生成式检索,且物品库每天在长,这套「只插不改」的策略可以直接抄,落地成本比加对齐模块、加 adapter 低得多。要盯的指标是小 beam 下的 HitRate 和 MRR,别拿 beam 1000 的离线数字下结论。该比较的对手是全量重映射加热启动,不是冻结基线。坑在于:SID 空间会随新物品持续膨胀,碰撞只是被推迟;三 token 的固定长度 SID 能撑多久,论文没给答案,新物品占比升到一定量级后冻结策略的天花板值得先在小流量上压一压。
4. Making Collaborative Signals Count: Graph-Aware Large Language Models for Sequential Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-10-19 12:51 UTC
- 机构:未披露机构
- 工业优先级:中
- 备注:10 pages, 5 figures, 4 tables, includes appendices
🔍LLM推荐里塞的CF向量,模型真没在看
各位算法同学们:先看一组归因分数——LLaRA 里文本 token 是 8.77,CF token 只有 0.05,差了两个数量级。也就是说,我们费劲从外部推荐模型里抽出来、再注入 LLM 的协同 embedding,模型在生成目标 item 时几乎没参考它。这篇工作就是正面处理这个 mismatch。
📄 Making Collaborative Signals Count: Graph-Aware Large Language Models for Sequential Recommendation
🔧 思路换了:不再找外部推荐模型提供 CF 表示,而是把用户历史里的 item token 和文本 token 放在一起,组成一张 token 级的协同图,里面有三类边——Text-Text 关系保留语义依赖,Item-Text 关系把每个 item token 连到它自己的标题描述上,Item-Item 关系则来自全局共现,也就是跨用户统计出来的 item 共现强度。
🧩 关键的一步是:这张图不经过图编码器,直接转成轻量的可学习 attention bias,加到 LLM 每一层注意力的 logits 上。这样一来,模型能感知全局共现信息,又不用修改 LLM 主干结构,只多出少量可训练参数。
⚙️ 对比之前靠 attention mask 的做法,区别在于那些方法只建模序列内部的先后依赖,而 Item-Item 边来自全局统计,多个用户的交互历史都能被联合利用。
📊 在四个公开 benchmark 上,GALLM 都是最优结果,HR@5 比最强 baseline 平均高 9.76%。
📈 NDCG@5 上平均提升 7.62%,而且是在全部数据集上一致拿到的,不是靠某个数据集把平均值拉上去。
✅ 代码已经开源,在 github 上搜 GALLM 就能找到,复现门槛不高。
我的判断是:如果你在做 LLM4Rec,而且试过“注入协同 embedding、线上却没动静”这条路,这篇的思路可以直接借鉴,成本主要在构造共现矩阵和调 bias 的分桶粒度上。需要特别留意两个问题:一是 Item-Item 边在长尾 item 上非常稀疏,冷启动场景下这部分 bias 可能等于没加;二是和 LLaRA 这类方法对比时,要把可训练参数量和训练数据对齐,否则这 9.76% 里有多少来自图结构、有多少来自额外参数,说不清楚。
5. OneChord: Distill What You Rank, Recommend in One Pass
- 论文链接:AlphaXiv
- 更新时间:2026-10-19 05:16 UTC
- 机构:University of Chinese Academy of Sciences
- 工业优先级:中
蒸馏别蒸错:蒸你上线排的那个分布 🎯
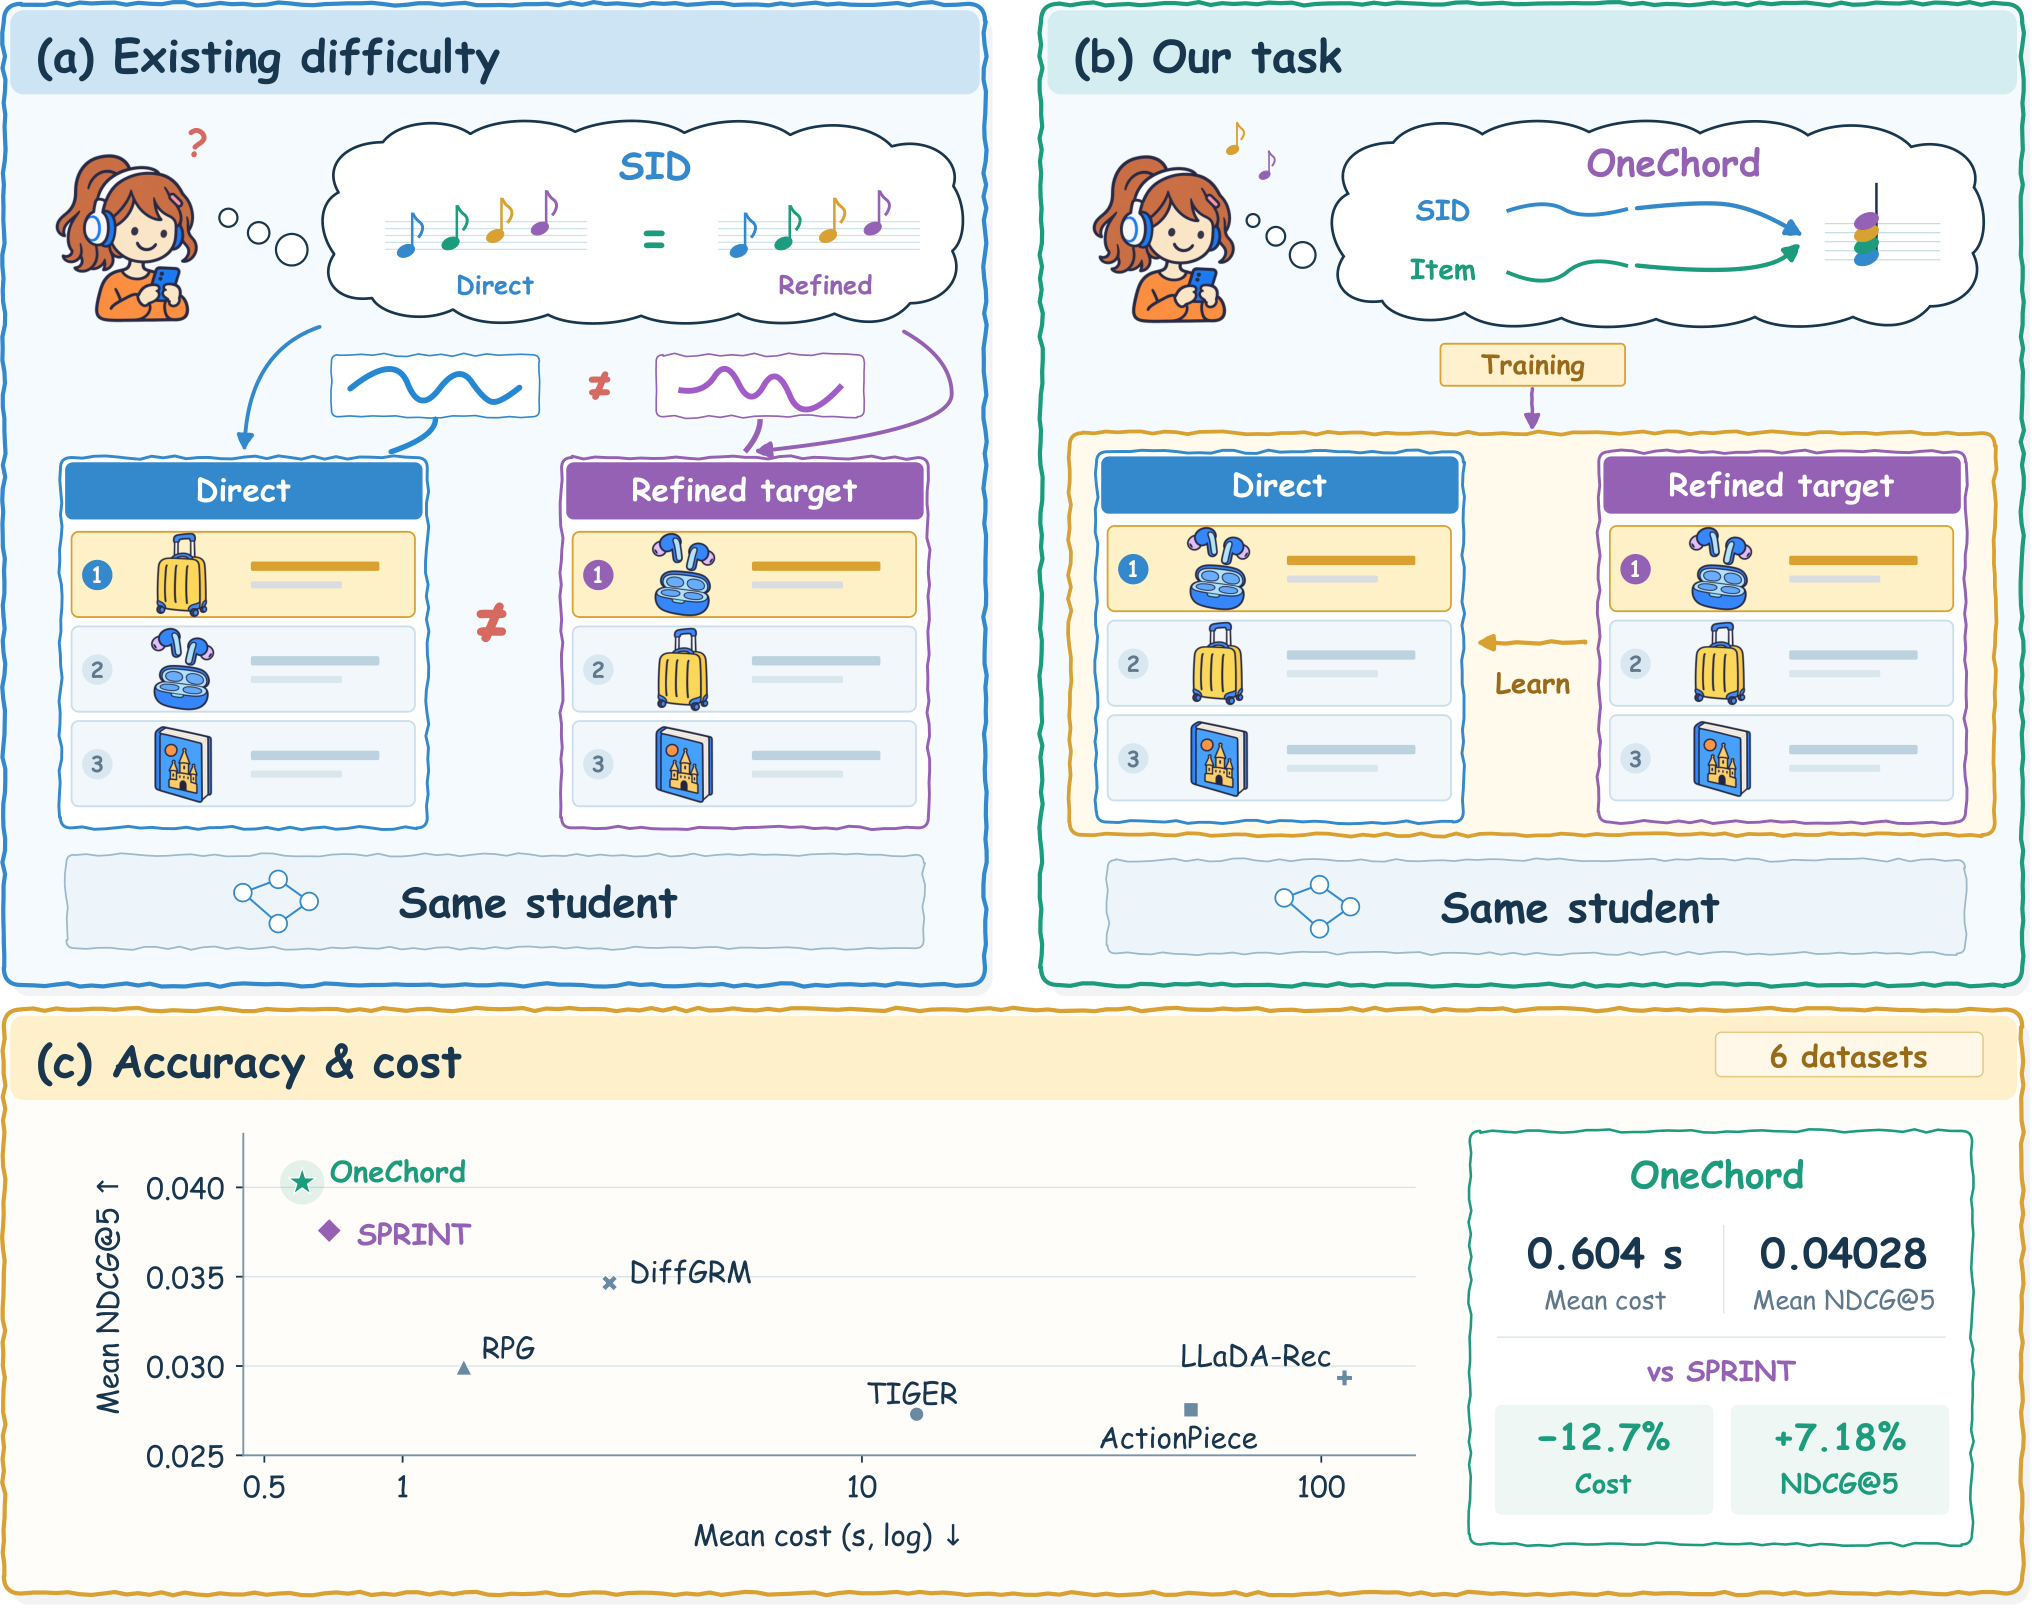
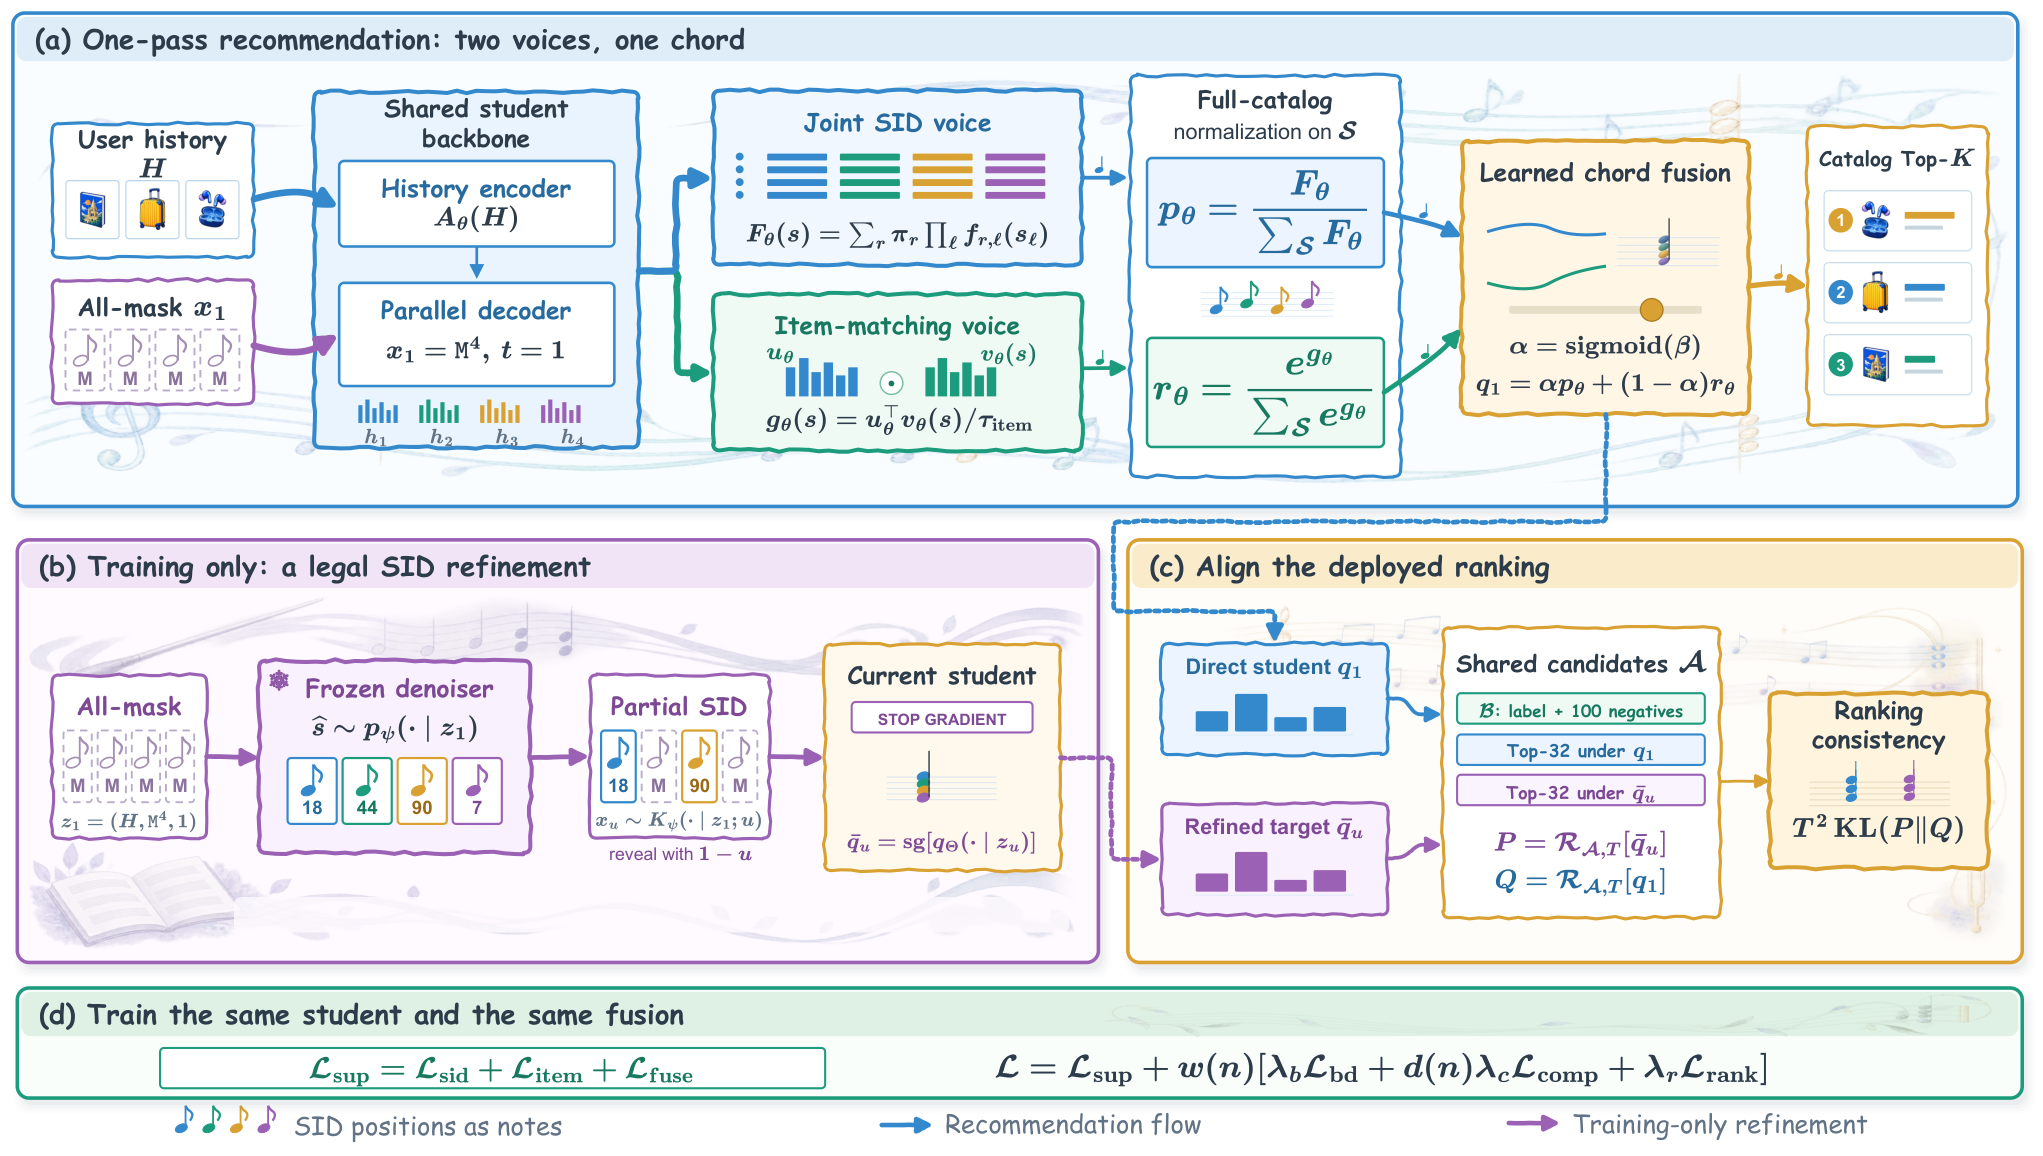
各位算法同学们:语义ID推荐里,训练时蒸馏的分布和线上真正参与排序的分布往往不是同一个,这篇论文要解决的就是这个错位:SID概率和item相似度到底怎么归一化、权重怎么配,直接决定谁进Top-K。
📄 OneChord: Distill What You Rank, Recommend in One Pass(中国科学院大学)
🔧 用一个可学习的门控α,把SID概率和item匹配分分别在全库上归一化后再融合,下一次点击的似然直接监督这个融合分布本身,而不去分别监督两个分支。
🧩 训练时由冻结的去噪器给出合法的部分SID,学生模型对这些中间态打分,得到“精修后的融合分布”;再在共享难候选集上做排序一致性对齐,其中候选集由label、100个负样本和两边各自Top-32组成,从而把精修能力压进一次前向推理。
⚙️ 论文给了两个命题:门控α的梯度等于α减去SID分支对真实目标的“责任”,固定分支时损失对α是凸的;候选条件化会让分支权重漂移——必须先全库归一化、再融合、最后取候选,顺序反了排序会翻。
📊 六个Amazon数据集上Recall@5和NDCG@5全部第一,相对最强基线平均+6.30%和+7.12%;Beauty上NDCG@5相对提升9.96%。
📈 全测试集生成速度比最快基线快1.04–1.18倍,准确率和延迟没有互相拖累。
✅ 对比SPRINT那类一次前向同时出SID分和item分的做法:平均NDCG@5 +7.18%,平均生成成本低12.7%。
💭 这套方法适合正在做生成式推荐或SID召回、并且线上确实要把code概率和item相似度融合的人。重点看最终融合分布上的Recall@5和单次生成延迟,别只盯SID分支自己的命中。需要留意两个问题:它依赖固定语义索引和冻结去噪器,换索引基本要重训;融合门控在数据集内共享,多场景混跑时要确认α没有被大场景带偏。
6. FLMNet: Self-Ensemble Distillation from Masks to Seeds for Single-Tower CTR Prediction
- 论文链接:AlphaXiv
- 更新时间:2026-10-19 10:27 UTC
- 机构:National University of Singapore,University of Science and Technology of China
- 工业优先级:中
- 备注:44 pages, 10 figures, 15 tables. Code: https://github.com/ivanna10240823-rgb/flmnet
自蒸馏的收益,被这篇算清了🧮
各位算法同学们,FinalNet 和 QNN 里那个自蒸馏损失,去掉它 Criteo 上 AUC 只掉 0.06 个百分点,但两年没人说清它到底在正则什么。这篇把 mask 数量推到无穷取极限,答案简单到有点反直觉。
📄 FLMNet: Self-Ensemble Distillation from Masks to Seeds for Single-Tower CTR Prediction
🔧 极限推导:当 mask 数量趋于无穷,masked self-ensemble 目标精确收敛为“平均 logit 上的标签损失 + softplus 在 mask 上的 Jensen 间隙”,外加一个梯度为零的项。也就是说它只正则各 mask 副本之间的分歧,别的都没管。普通 dropout 是系数为 1 的特例,QNN 在 logit 空间池化后系数是 2,多出来的那 1 才是“蒸馏”。
🧩 把间隙换成高斯代理,只需要 logit 对 mask 的均值和方差,不用采样。在这三个条件下有闭式解:门控只读未 mask 的输入、readout 是仿射、每层按坐标缩放。于是训练变成一次确定性前向。
⚙️ 结构上配套做了 FLMNet:每个 field-local gate 只读自己那一列未 mask 的 embedding,再用学出来的 mixer 把门控摊到其他 field。这一步不是白拿的,直接把门控改成读未 mask 输入,Criteo 验证 AUC 掉 10.5e-4(还没加惩罚项),FLMNet 把它补回到与原 QNN-α 只差 0.9e-4。后半段从 mask 换到 seed,FLMNet-KD 拿一个收敛的 FLMNet-CF 去对齐 K 个不同种子 tower 的池化 logit,训练 K+1 次,推理仍然只有一个塔。
📊 5 个 benchmark、17 个 baseline,单塔推理的准确率排到前两名。 📈 消融:QNN 去掉自蒸馏损失,Criteo 掉 0.06 个百分点,Frappe 0.17,KKBox 0.19;FinalNet 从 Avazu 的 0.03 到 Frappe 的 0.12。 ✅ 惩罚项和种子蒸馏的增益,在可测量的地方基本是相加的,不是同一份收益换个说法。 ✅ 只差随机种子的 tower,能把五塔集成一半以上的增益传给单个学生塔。
总结:如果你在做单塔 CTR,而且已经在用 dropout 类自蒸馏辅助损失,这篇给了你一条不用多次随机前向的实现路径,收益量级在 1e-4 的 AUC 上,别指望大跳。需要关注两件事:增益在你自己数据上是否稳定在 1e-4 以上,以及门控改结构带来的掉点有没有补回来。容易出问题的地方也很明确,闭式解依赖那三个结构条件,门控一旦读 masked 输出,均值和方差就是错的;KD 那部分要 K+1 次训练,算力预算得先算清楚再决定要不要跟。