推荐算法日报 · 2026-10-18
总览
今天这三篇有个共同点:方法本身不算惊艳,但实验做得诚实、前提讲得清楚,读起来比那种 SOTA 刷榜文舒服得多。主线大概两条——一条是把生成式推荐往工程里摁,讨论算力到底该加在哪、什么时候算;另一条是 ID 侧的路线之争,SID 该单头自回归还是多头并行一次吐完。最值得细读的是 TransX 那篇,它最有价值的地方不是模型结构,而是把训练和 serving 的账算明白了,scaling 结论还挺反直觉:别一股脑堆 encoder,监督变强后最优分配会往 fusion 那边跑,线上 A/B 的 CTR、CVR 和吞吐数字也扎实,只是生成式那部分目前只有离线探索,而且整套收益强依赖“行为更新率远低于请求率 + 每请求大 fanout”这个前提,前提不成立就白搭。SID 那篇也值得看,它把 MTP 调到最强形态再跟单头自回归比,结果在 8B 上单头全线小胜、训练还快两三倍,跟一批小 benchmark 上吹 MTP 的结论是反着来的,不过要注意它用的是 L=4 的短 SID,换成 64 token 的长 SID 结论很可能翻过来。RecSoup 那篇思路务实,先用 PCA 证明 accuracy 和 diversity 的 task vector 压根不在一个线性子空间里,才引出“先剪枝再学偏好映射”,延迟优势也很大,但可控性并非处处最好、剪枝收益对数据和骨架很敏感,而且全是离线 benchmark。所以今天优先看 TransX 和那篇 SID 路线对比,RecSoup 如果你正好在纠结多目标 serving 成本可以扫一眼。
论文列表
1. TransX Technical Report: Scaling Sequence Transduction for Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-10-14 20:43 UTC
- 机构:未披露机构
- 工业优先级:强
算力堆5倍,线上成本反降80%
各位算法同学们,先甩个反常识结论:把推荐模型每请求算力堆到基线的5倍,线上总服务成本还能降近80%。TransX这篇技术报告的重点不在结构多花哨,而在回答两个问题——算力该加在哪个组件上,以及这些计算到底该多久跑一次。
📄 TransX Technical Report: Scaling Sequence Transduction for Recommendation
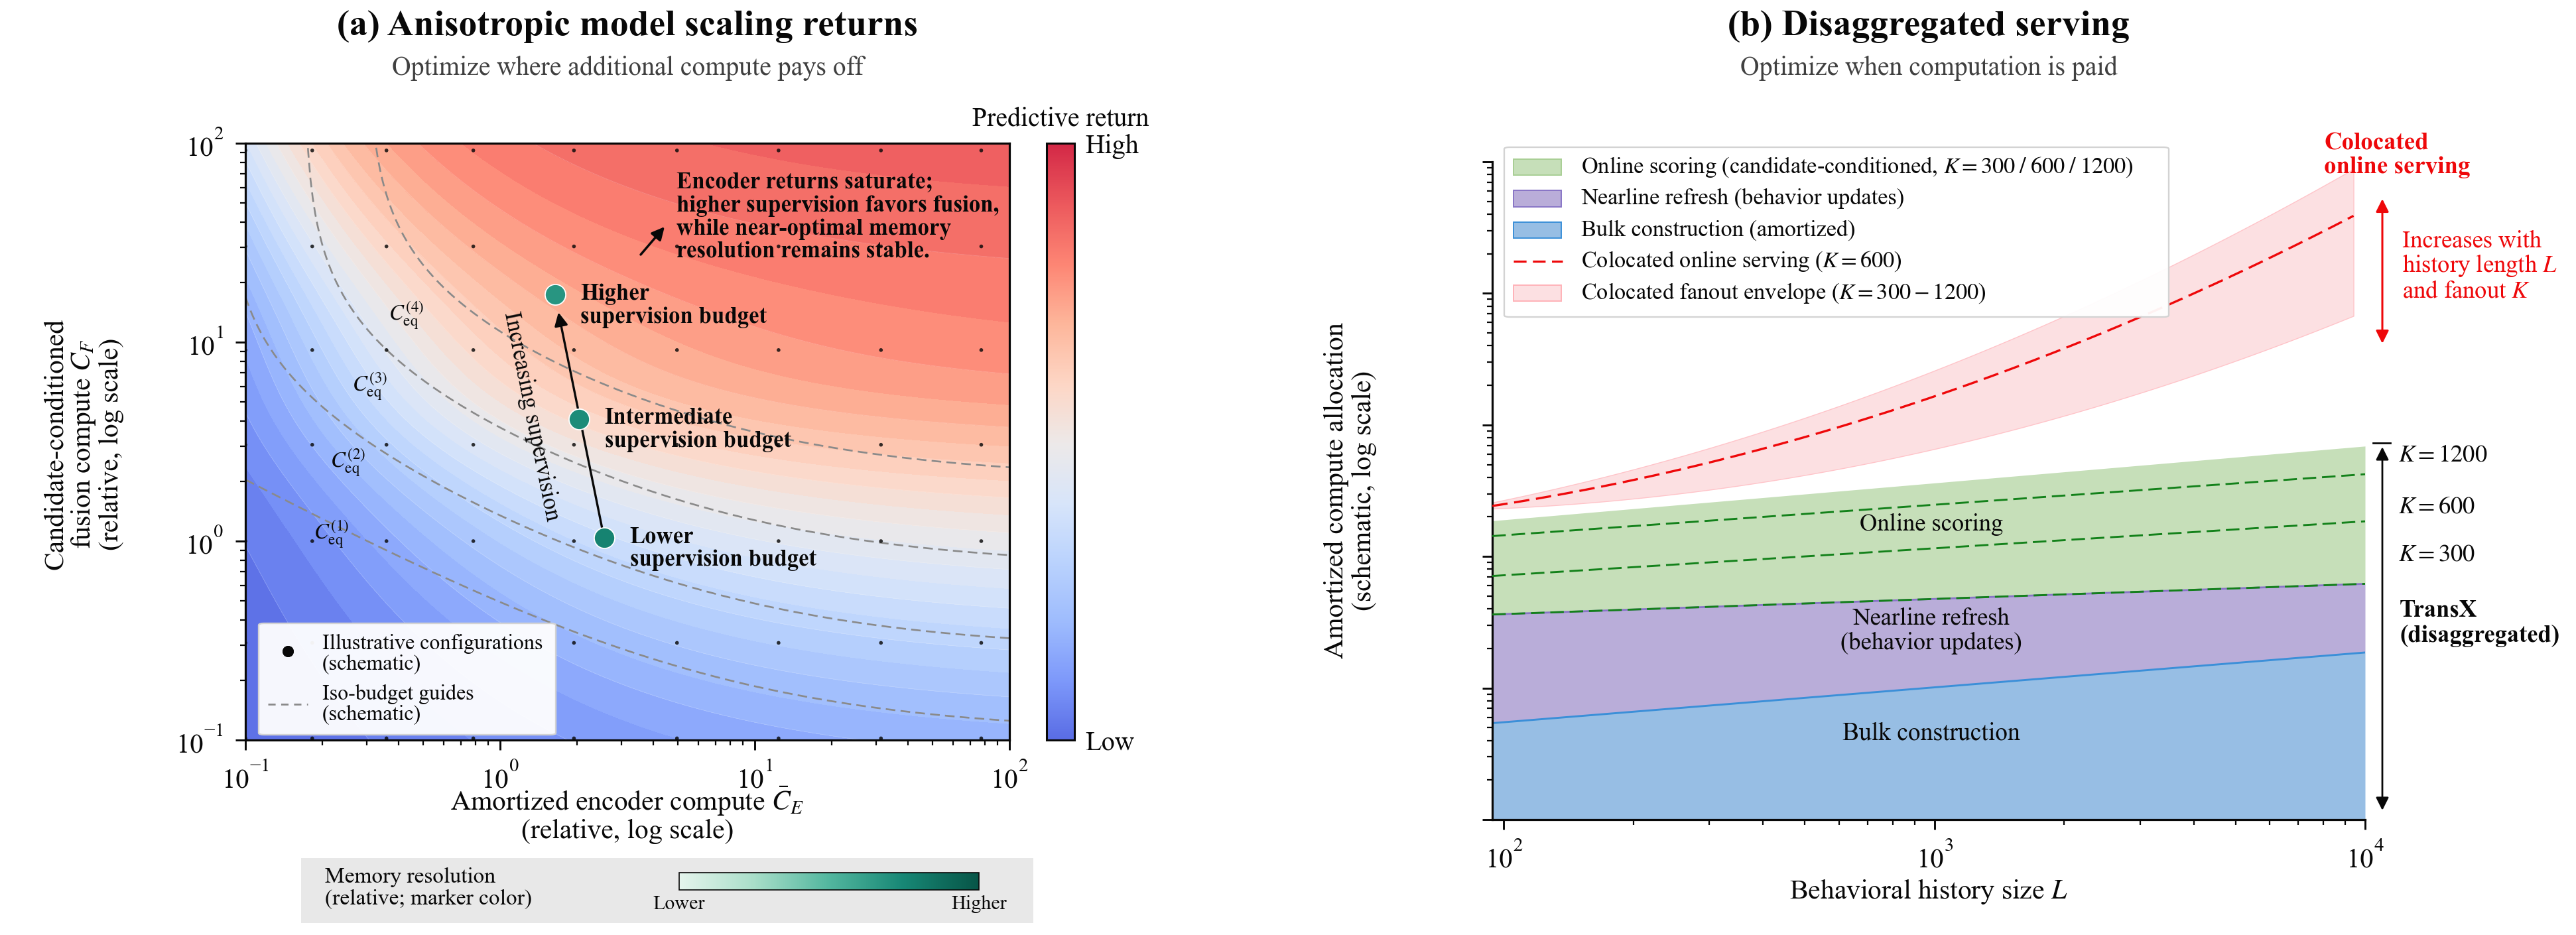
🔧 模型拆成三个可独立扩容的角色:序列编码、行为记忆、候选条件融合。编码只看行为流不看候选,所以重叠前缀的算力可以复用;行为记忆是有界的全局加局部表示,让“记忆分辨率”变成一个独立旋钮,而不是靠堆长序列硬解。
🧩 训练侧多前缀 seq-to-seq:一条轨迹的所有前缀共享一次因果编码,同一前缀下的候选 fanout 共享一份 event state,历史相关计算不再随请求数和候选数重复。配套的序列-fanout 并行把这条路径真正跑满。
⚙️ 服务侧拆开执行:离线 bulk prefill、近线增量刷新行为状态、在线只做 KV 读取加候选条件预测,KV 再做量化和分层驻留。在线路径因此不用背长历史,成本不再和模型容量线性绑定。
✅ 线上 A/B:核心模型 CTR +6.02%、转化 +4.45%;post-train 出的召回与偏好排序变体分别比各自基线 +2.96% CTR、+1.33% 转化。
📈 同等训练条件下,监督目标吞吐 +84%。
📊 拆分式服务在同流量同 SLO 下,总服务成本比一体部署降近 80%,同等成本可撑约 5 倍每请求 FLOPs;即使对齐每请求 FLOPs,单张 H200 的请求吞吐也约 4 倍。
🔍 更有意思的是扩容收益不均:固定融合容量时编码器加到中等深度就饱和;监督信号变多后,验证集选出的预算会往候选融合那边挪;而保住质量所需的记忆分辨率几乎不随模型变大而上涨。
总结感想:能直接抄的是“扩容前先量各组件边际收益”这个动作,别默认所有层一起加。落地时要盯两个指标——每请求 FLOPs 下的单位成本吞吐,以及行为记忆 KV 的驻留命中率与刷新延迟。坑在于这套东西强依赖离线加近线管线的成熟度,状态刷新滞后会伤时效性特征,行为稀疏或冷启动场景的收益要打折看。
2. Personalized LLM Recommendation with Semantic IDs: Autoregressive Beam Search vs. Multi-Token Prediction
- 论文链接:AlphaXiv
- 更新时间:2026-10-11 19:33 UTC
- 机构:未披露机构
- 工业优先级:强
- 备注:Accepted to NeurIPS 2026 PALM Workshop
MTP没赢,beam search更省
各位算法同学们,先给结论:并行解码听起来更高级,但在真实产品指标上,老老实实的约束 beam search 反而比 MTP 表现更好。这篇 Netflix 团队的工作在同一个 Qwen3-8B 级多任务模型上,做了规模相近、条件一致的产业级对比。
📄 Personalized LLM Recommendation with Semantic IDs: Autoregressive Beam Search vs. Multi-Token Prediction
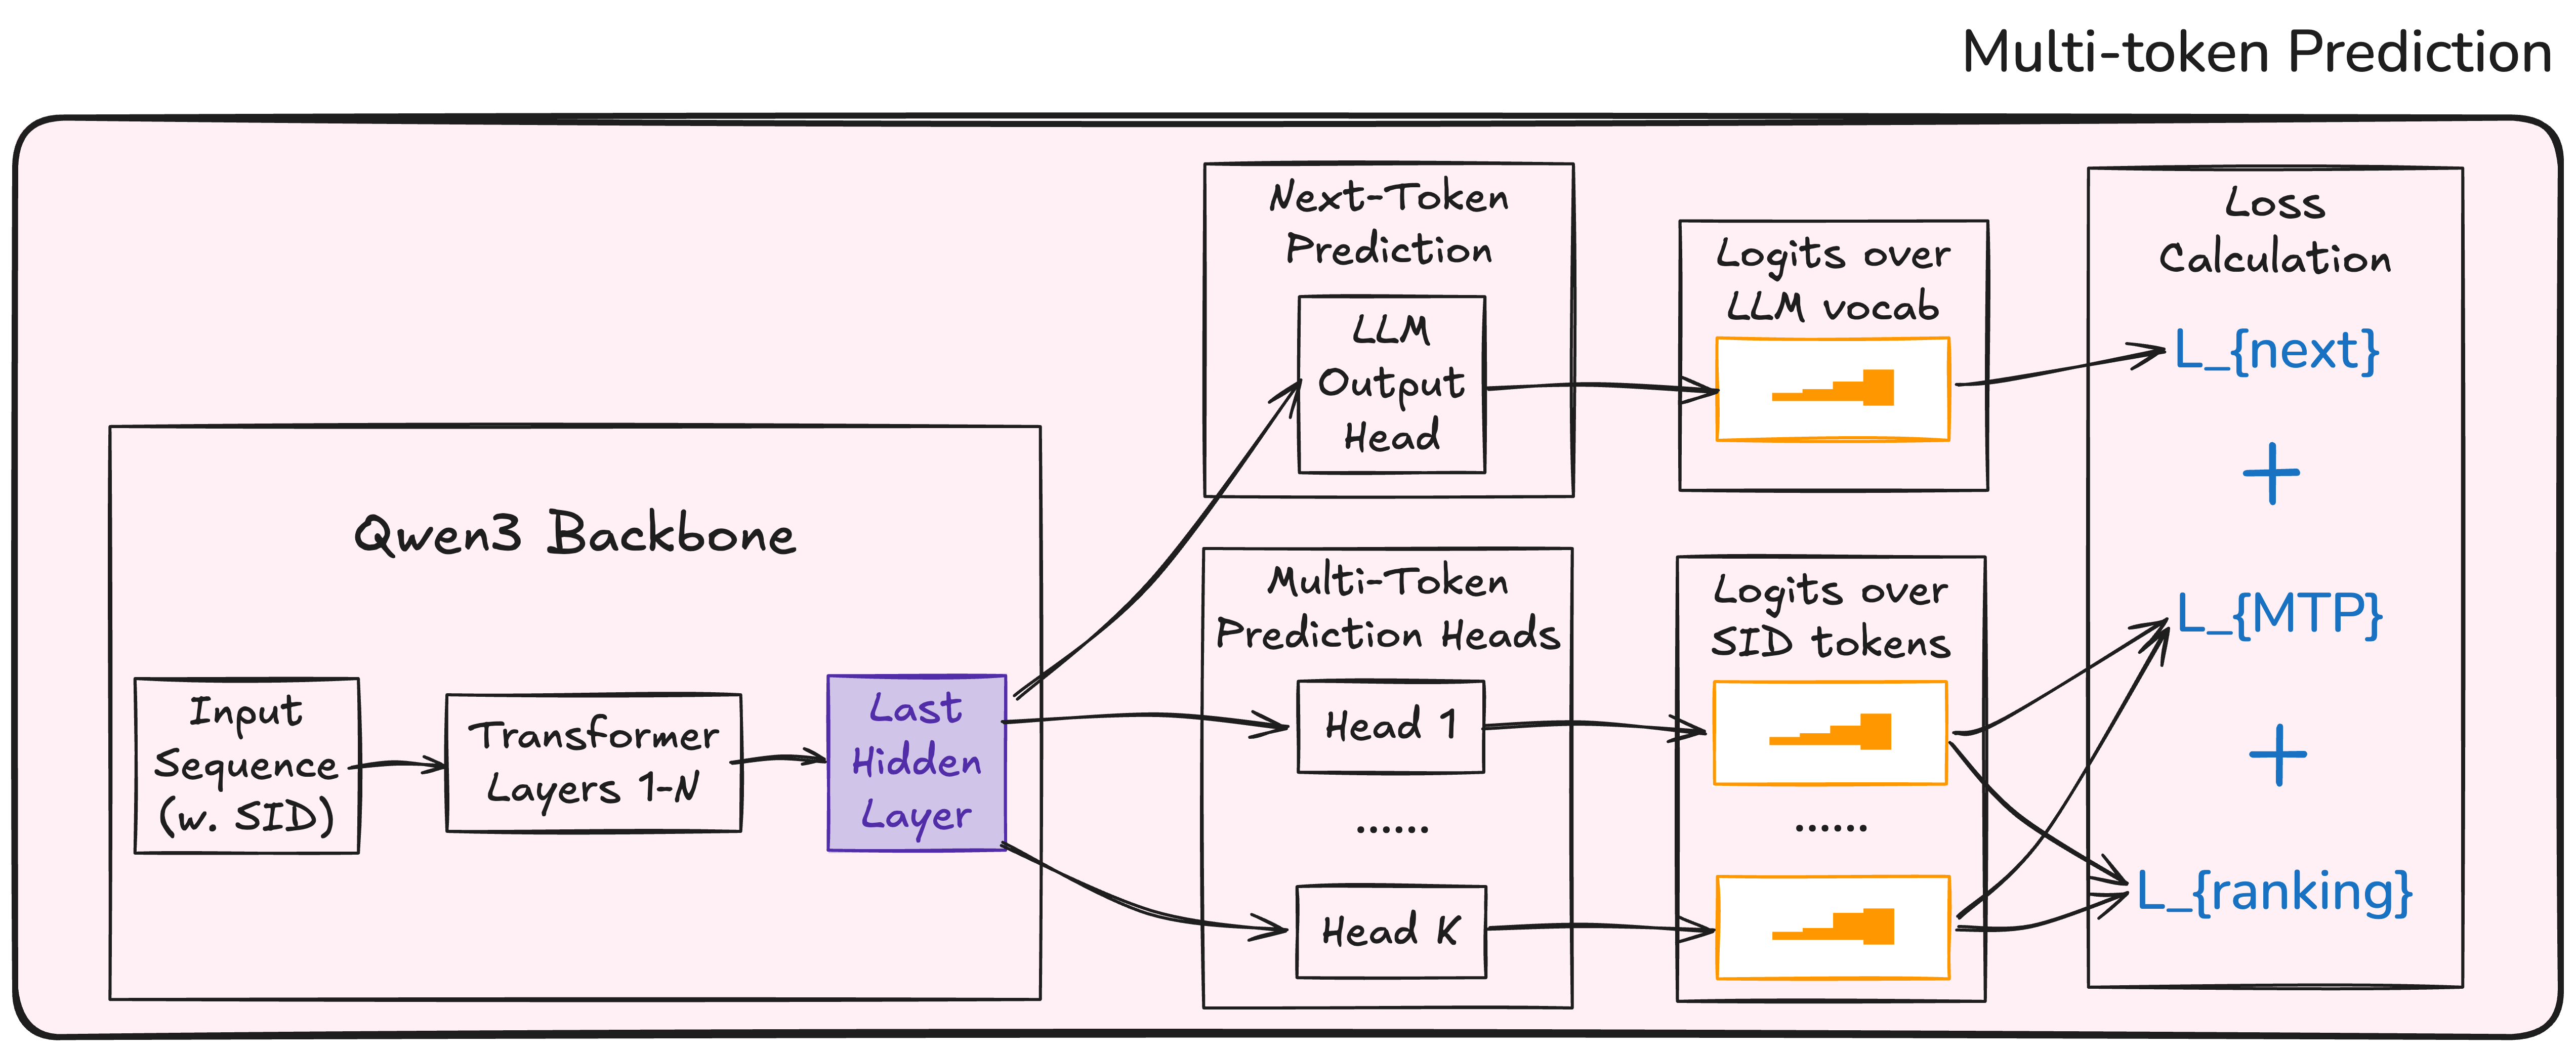
🔧 把 SID(残差量化出的分层内容码,实验用 1024×4)直接加入通用指令微调 LLM 的词表;同一个 LM 头同时完成个性化召回、内容问答和指令跟随,省掉与目录规模相当的大分类头,新品只靠内容就能拿到有意义的 SID。 🧩 点出 MTP 的核心问题:L 个并行头各自计算每个码的边缘概率,从不优化 item 级联合分,于是“每一层码单看都合理”的错误 item 能压过真目标。 ⚙️ 定义在联合 SID 分数上的辅助排序损失(sampled softmax)补上这一环,让并行头输出可比较、可排序的分数;推理侧在 vLLM 上做 trie+目录约束的 beam search,并用前缀缓存复用长历史 KV。
📊 同模型规模、同数据下,单头 beam search 在排序和内容 QA 上稳定优于 MTP,训练 dollar cost 约为其 1/2.6。 📈 MTP 只在原始推理吞吐上赢,特点是快,但排序不准。 ✅ 对比上一版带辅助排序头、不使用 SID 的基线:新品冷启动排序 +77%,内容 QA 准确率 +22%,训练快 2.8 倍。 ⚠️ 语言指标出现回退,作者定位为 SID 词表扩张导致,并用 RL 后训练补回。
总结感想:做生成式召回、正纠结要不要换 MTP 的同学,先别急着换:先拿排序和内容 QA 两个指标跟 beam search 对照测试,并把训练 dollar cost 和线上吞吐分开核算。两个潜在的坑:MTP 的并行独立假设必须靠额外排序损失补,且 SID 词表扩张会拉低语言能力,得有后训练手段作为保障。
3. RecSoup: Efficient Model Merging Approach for Controllable Multi-Objective Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-10-15 04:08 UTC
- 机构:Renmin University of China
- 工业优先级:中
- 备注:Accepted at CIKM 2026
多目标推荐不重训,推理快两百倍
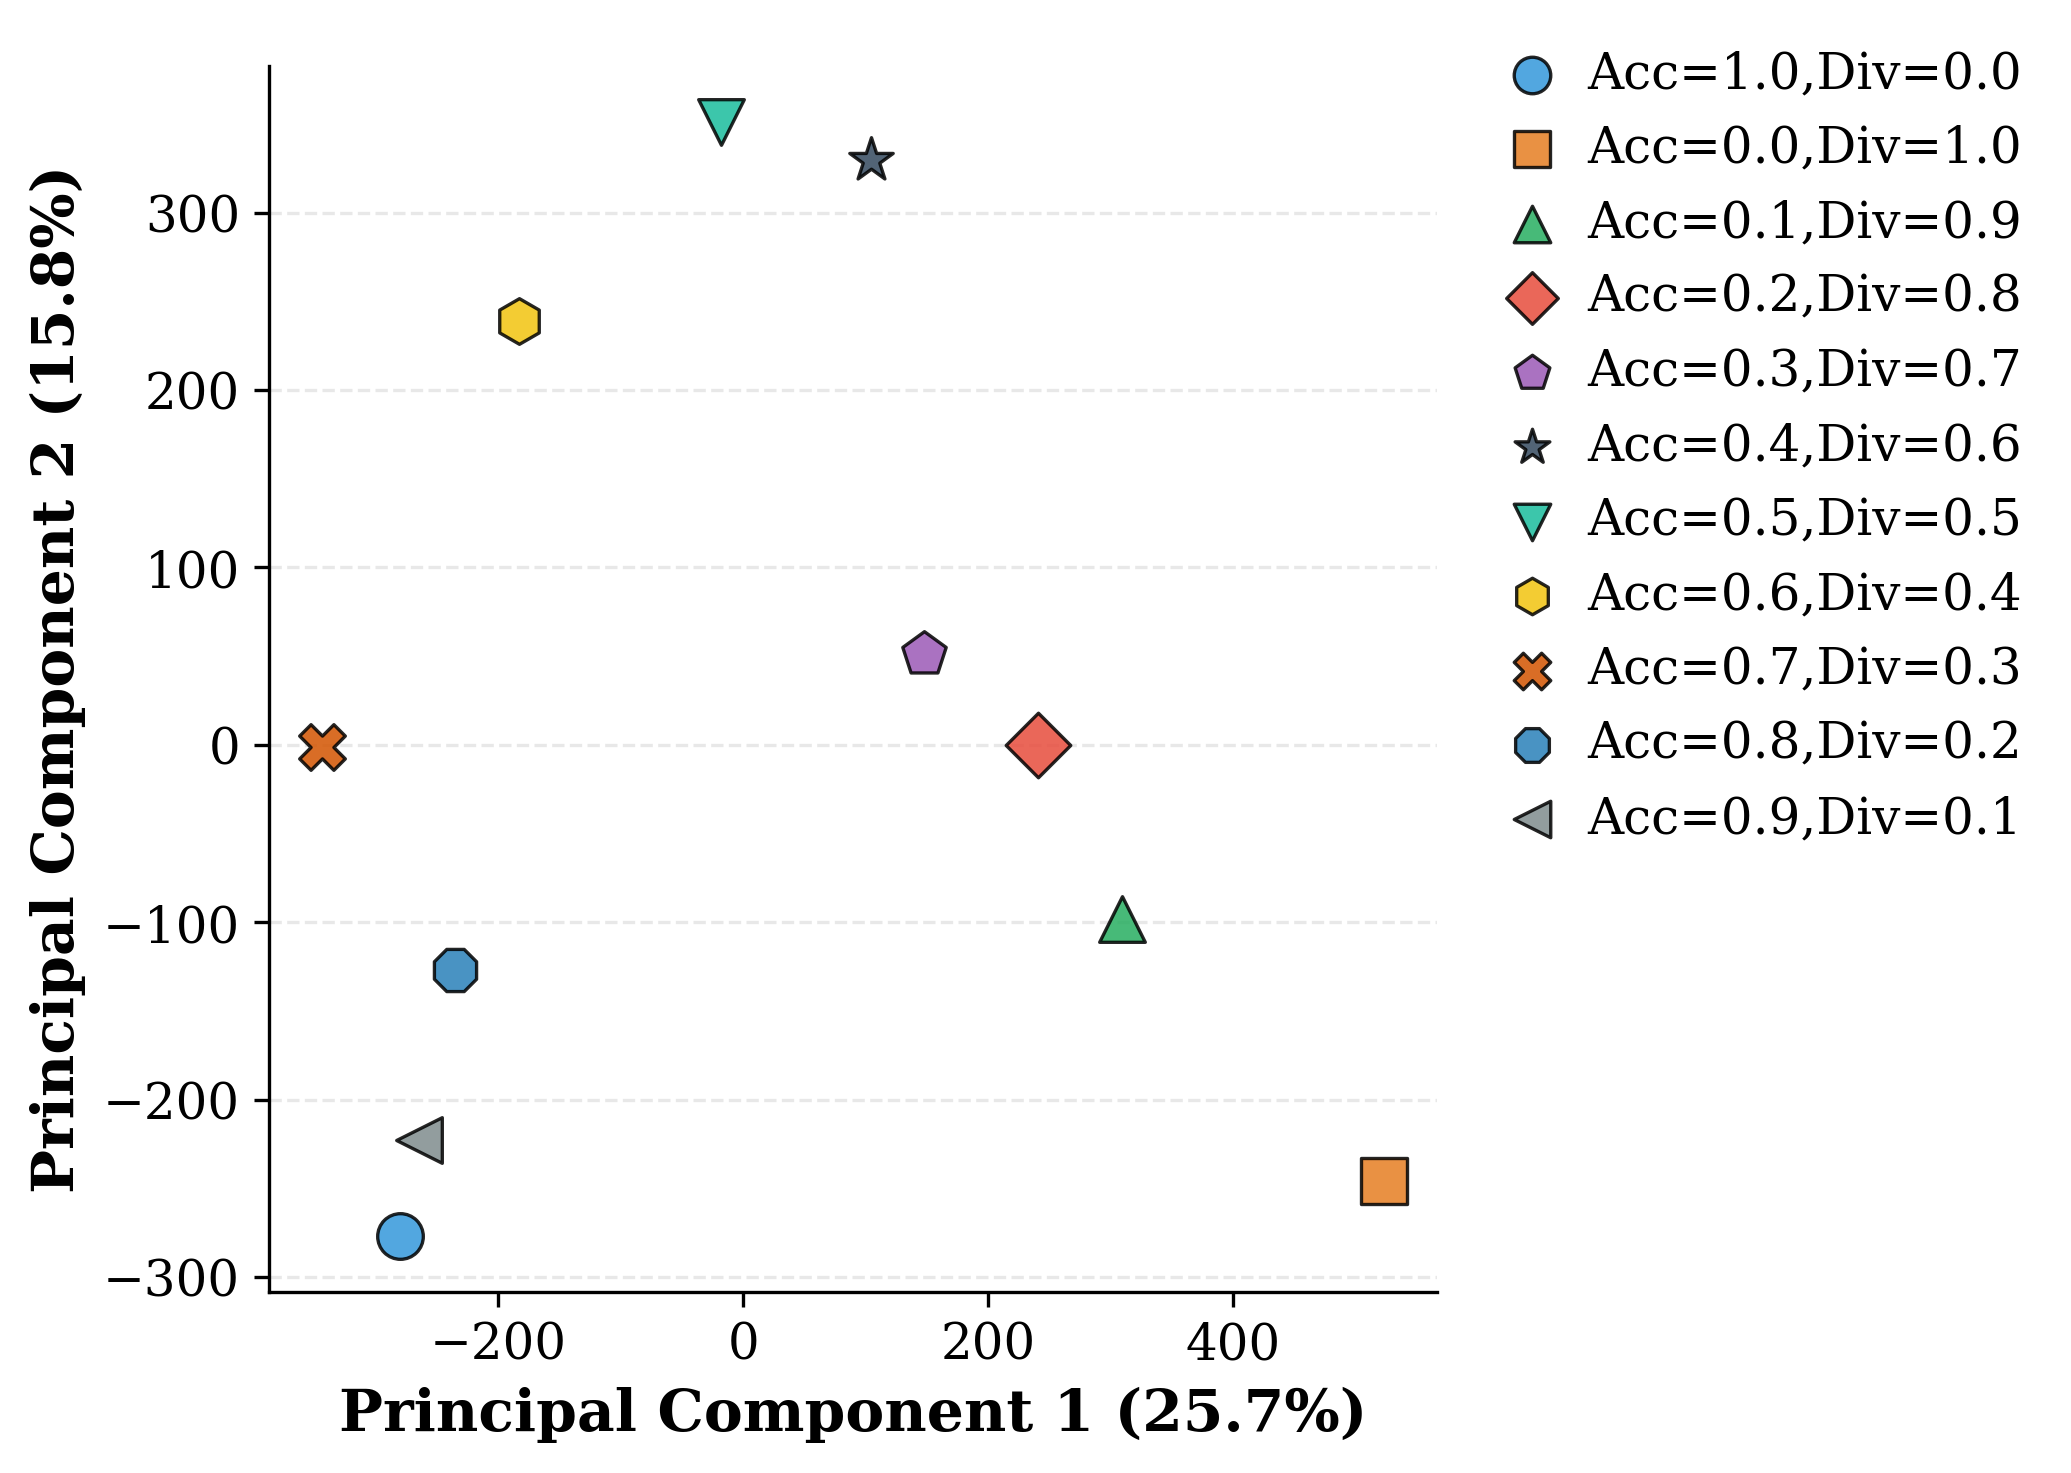
各位算法同学们,如果告诉你:推理时想调准确率和多样性的权重,不用重训、不用额外生成网络,只是换一组“合并系数”就行,你会不会先怀疑效果?这篇把模型合并搬进可控多目标推荐,最反直觉的一点是——精度和多样性的task vector根本不在同一个线性区(PCA前两主成分只解释25.7%和15.8%方差),所以它没有硬做线性插值。
📄 RecSoup: Efficient Model Merging Approach for Controllable Multi-Objective Recommendation
🔧 两阶段框架,先把“打架”的参数挑掉再合并:剪枝准则同时看目标内重要性和跨目标相关性,而不是只看参数幅值,给后续合并在参数空间里留一个冲突更少的底座。
🧩 第二阶段放弃线性插值,学一个偏好向量到合并系数的映射,推理时按用户偏好实时算出λ,模型参数写成base加各项加权task vector,不需要联合重训,也不需要hypernetwork或扩散模块来生成参数。
⚙️ 附带一个理论结论:在不加平滑性约束的前提下,模型合并能走遍整个帕累托前沿,因此在有效性和效率上都优于参数生成范式,这解释了为什么它不用生成模块也能控得住权衡。
📊 推理时延比参数生成类方法快165到228倍,这个量级差主要来自省掉了生成模块的前向开销。
📈 在多个benchmark上帕累托前沿质量优于现有基线,同时可控性与SOTA方法相当,说明快并没有换来前沿质量的明显退化。
✅ 剪枝策略是模块化的,可以接进已有的动态合并机制里一起用,不一定绑定它的系数映射。
总结感想:如果你在做多目标排序,且训练管线里本来就存着一堆目标专精的checkpoint,这套“复用而不是重建”的思路落地成本最低。要盯的指标有三个:帕累托前沿的超体积、偏好权重变化时对应指标是否单调响应、以及剪枝比例对精度的折损曲线。坑在于系数映射是学出来的,真实偏好一旦漂出训练分布,控制可能就不线性了,论文里还是离线benchmark的验证,线上偏好漂移得自己补实验。