推荐算法日报 · 2026-10-16
总览
今天这四篇看下来主线挺清楚:两篇在给生成式推荐(SID 那一套)打补丁,一篇在讲大规模持续训练怎么不崩,还有一篇是把匿名网页点击流榨成意图信号的金融工程活。生成式那两篇路子完全不同,一篇补的是表达力——在 SID 前面先解码粗粒度属性 token,走 speculate-then-refine 的两段式;另一篇补的是训练目标——用层级损失加属性回归监督,把粗到细的结构和物品属性监督密度都找回来。前者是我今天最愿意细读的,因为生成式推荐能跑到线上 GMV 级别正收益的实在少见,而且它把曝光加权的容量约束、多场景条件这些工程细节也交代了,不过它的「理论等价」更像解释性框架,正文里没看到完整消融,各模块贡献多少还得存疑。后者胜在便宜可插拔,层级损失加属性 lookup 这两处设计很聪明,但自家 baseline 偏弱、NDCG 还有几行是负的,增益得打个折看。剩下两篇里,训练稳定性的那篇没什么新算法,价值全在压力测试和「买训练不挂的保险」这个定位上,做持续训练的同学可以扫一眼;金融场景那篇蒸馏做得漂亮,3000 倍吞吐、标签质量只掉 7%,但全离线、单机构单域,现在的数字千万别当线上收益。今天优先看前两篇生成式工作的机制设计,再顺手翻一下稳定性那篇的压力测试结论。
论文列表
1. UniRec: Bridging the Expressive Gap between Generative and Discriminative Recommendation via Chain-of-Attribute
- 论文链接:AlphaXiv
- 更新时间:2026-10-14 16:27 UTC
- 机构:Shopee
- 工业优先级:强
- 备注:Accepted at ACM RecSys 2026
生成式推荐差在哪?这篇用属性链补上
| 各位算法同学们,生成式推荐一直被默认“表达力天生弱于判别式”,但这篇用贝叶斯定理说明:按 p(y | f,u) 排序等价于按 p(f | y,u) 排序,理论上两者上限一样,实际差距只来自特征覆盖不全。更狠的一个数字是,生产数据里 top 10% 的 (s0,s1) 组合吃掉了 87.9% 的曝光,SID 码本的流量集中比想象中严重得多。 |
📄 UniRec: Bridging the Expressive Gap between Generative and Discriminative Recommendation via Chain-of-Attribute(Shopee)
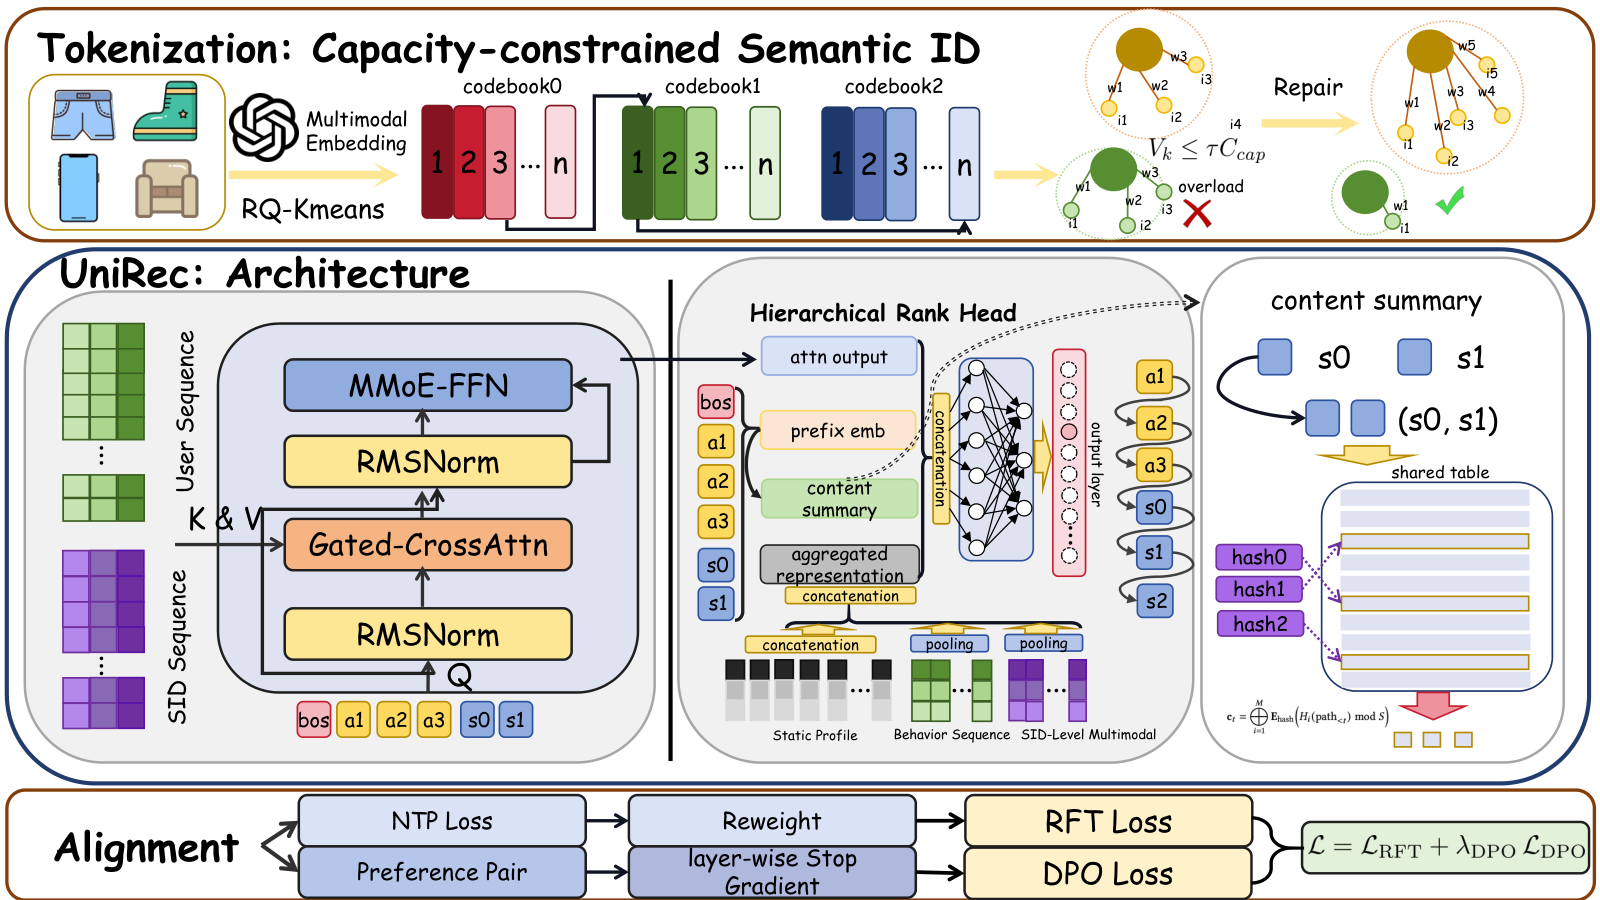
| 🔧 CoA(Chain-of-Attribute):在解码 SID 之前,先按顺序生成 category、seller、brand 这些结构化属性 token,把判别式模型靠特征交叉拿到的那部分 item 侧信号,重新塞回生成轨迹里。论文给出了每步条件熵下降 H(s_k | s<k,a) < H(s_k | s<k),搜索空间被压窄,beam search 轨迹更稳,端到端误差也被衰减。 |
🧩 Capacity-constrained SID:针对长尾流量,把曝光加权的容量惩罚加进残差量化,直接控制每个码本条目的流量负载,压住 token 塌缩和层级之间遗传的马太效应。前面那个 87.9% 就是它的动机——轻度的 item 数量不均衡,被放大成了 2.6 倍的流量集中。
⚙️ Conditional Decoding Context:Task-Conditioned BOS 负责注入场景信号,基于哈希的 Content Summary 负责注入组合特征,每个解码步都带上下文;再叠加 RFT 按连续业务价值重加权和 DPO 偏好对齐,把目标从分布拟合往业务指标上拉。
📊 离线整体 HR@50 相对最强 baseline 提升 22.6%,高价值订单样本上提升 15.5%。
📈 Shopee 线上 A/B:PVCTR +5.37%,orders +4.76%,GMV +5.60%。
✅ 论文自称是首个用信息论刻画生成式与判别式表达差距的工作,并证明 CoA 带来可度量的逐步熵下降。
🧠 做生成式推荐和 SID 的同学,方法部分建议精读,尤其 SID 码本塌缩和多场景统一模型这两个坑,它给的解法是工程可落地的。盯指标别只看 HR@50,高价值订单那一档和曝光分布的均匀度(码本条目负载熵)更能反映容量约束是否真的生效,线上则看 GMV 而不是只看 PVCTR。和 GRACE 相比,CoA 的差别在于给了理论解释而非经验设计,但代价是依赖属性字段质量:属性缺失或噪声大的类目,前缀反而会误导解码;CDC 的哈希摘要也要求场景划分相对稳定。如果你只服务单场景、item 属性又脏,这套的增益大概会打折。
2. From Clicks to Intent: Cross-Platform Session Embeddings with LLM-Distilled Taxonomy for Financial Services Recommendations
- 论文链接:AlphaXiv
- 更新时间:2026-10-14 17:04 UTC
- 机构:未披露机构
- 工业优先级:中
- 备注:Dianjing Fan and Yao Li equally contributed to this work. 7 pages, 1 figure
把LLM意图蒸馏成64维向量
各位算法同学们,每次session都调一次LLM做意图标注,成本和延迟在金融这种高流量合规场景里根本扛不住。这篇的答案是把LLM的意图理解蒸馏进一个64维session embedding,推理时彻底不碰LLM。
📄 From Clicks to Intent: Cross-Platform Session Embeddings with LLM-Distilled Taxonomy for Financial Services Recommendations
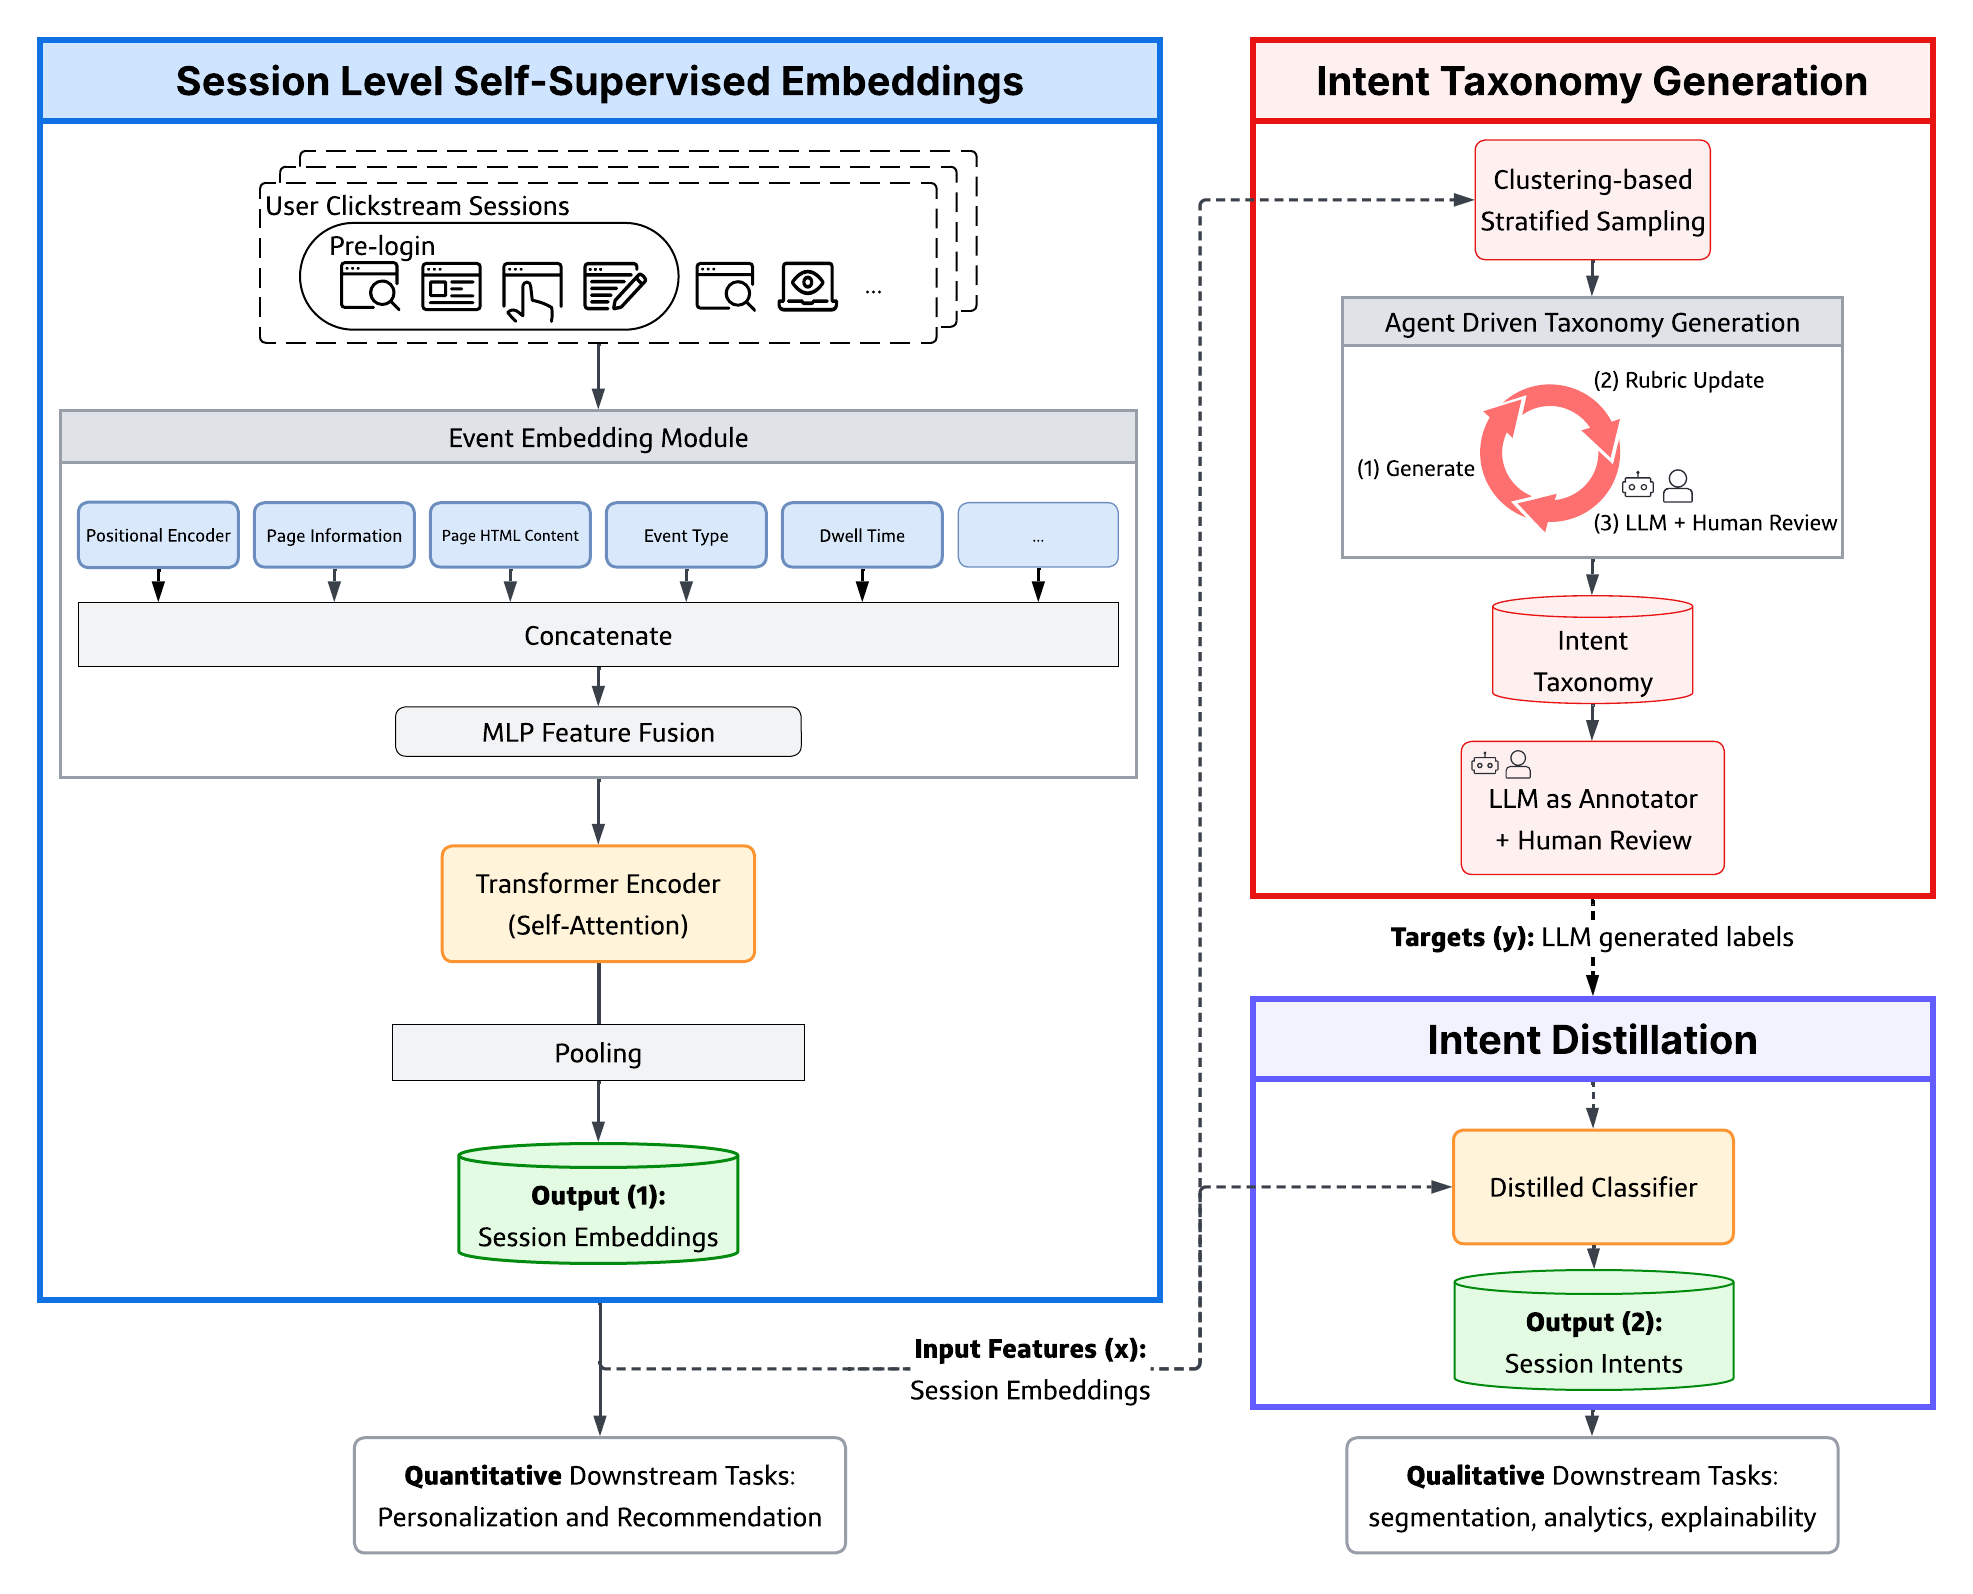
🔧 输入侧做多模态融合:离散特征走embedding表,URL不是字符串而是抓HTML正文过预训练句向量,再拼位置编码过Transformer;自监督目标就是预测下一事件的页面标题和URL,或做masked预测,全程不需要标注数据。
🧩 分类体系不是拍脑袋写的:先对session embedding做K-Means聚类,每个簇采样若干条喂给LLM,让LLM看到的是全量行为分布而不是随机子集;再用generate-update-review迭代流程把标签收敛成闭合标签集,避免自由文本标签前后不一致、没法审计。
⚙️ 蒸馏发生在embedding空间而不是文本空间:轻量分类器直接吃64维向量输出人类可读意图标签,推理阶段没有LLM调用、没有文本编码,一天能扛百万级session。
📊 移动端首页卡片排序任务:macro Recall@1 提升1.88%,Log Loss 下降13.38%,对比的是线上生产baseline。
📈 用户转化预测任务:session embedding 比直接用LLM标签高出4.3% micro F1。
✅ 蒸馏层只掉7%的标注质量,换来数量级更快的推理速度和可解释标签。
总结感想:做金融、合规这类既要效果又要可解释的场景,尤其是想从登录前web流量里挖意图的同学,这套双输出架构可以照着抄。盯指标要盯下游排序的Recall@1和Log Loss,别只看标注一致率。坑有两个:跨渠道实体对齐依赖一方cookie和登录凭证,对不准web意图会反过来污染登录后的个性化;URL正文向量是预计算的,页面改版后得定期重刷,否则语义特征会悄悄过期。
3. Understanding and Mitigating Training Instability in Large-Scale Recommender Systems: A Cascade Perspective
- 论文链接:AlphaXiv
- 更新时间:2026-10-09 23:37 UTC
- 机构:Google
- 工业优先级:中
推荐模型训练崩了?谷歌拆出G-W-L级联
各位算法同学们,推荐模型训练崩掉,常常不是某个超参没调好,而是梯度、权重、损失按顺序连环爆。Google这篇把大规模短视频推荐里的训练不稳定拆成G-W-L级联,给出按阶段出手的排查框架。
📄 Understanding and Mitigating Training Instability in Large-Scale Recommender Systems: A Cascade Perspective
🔧 把发散拆成链式反应:数据漂移或激进扩模型先触发梯度爆炸,大梯度推高权重,权重膨胀让网络输出极端,最后loss爆炸甚至NaN,即G→W→L。
🧩 按阶段映射干预:G阶段控梯度,比如SmeLU、RMSNorm、全局梯度裁剪;W阶段稳权重,做dense层激活值裁剪;L阶段换Huber loss,降低大误差冲击。
⚙️ 强调不是孤立修bug:只处理一个环节也会牵动其他环节,组合策略比单点更稳。
📊 工业短视频推荐模型上,G+W+L组合相对基线:BC T1 AUC涨0.25%,BC T2涨0.38%,回归RMSE降0.03%。
📈 单用L干预,AUC涨0.21%和0.38%,但回归RMSE升0.16%,loss shaping有代价。
✅ G干预把梯度范数拉低63.7%,总loss降3.6%;baseline初始g_t和l_t偏高,本身就在不稳定区。
我的判断:更适合被周期性发散折磨的大规模连续训练团队,不是小模型万能药。落地盯梯度范数、权重范数、loss NaN;和Adam+梯度裁剪基线比,别只看AUC,还要看训练中断和回归RMSE。坑是论文对级联的细粒度时序验证有限,多为聚合快照,真用要在自己数据流上打点监控。
4. HASTE: Hierarchical and Attribute-aware Supervision for Generative Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-10-12 20:25 UTC
- 机构:Glance
- 工业优先级:中
生成式推荐换个损失,收敛快2倍
各位算法同学们,同一个backbone、同一份数据,只把损失从flat cross-entropy换成带层级感知的版本,收敛速度就能快约2倍——更反直觉的是,flat CE不只是没利用SID的层级结构,它在主动破坏这个结构。这篇工作给生成式推荐的训练目标动了台小手术,换来的是长尾效果和训练效率两头受益。
📄 HASTE: Hierarchical and Attribute-aware Supervision for Generative Recommendation
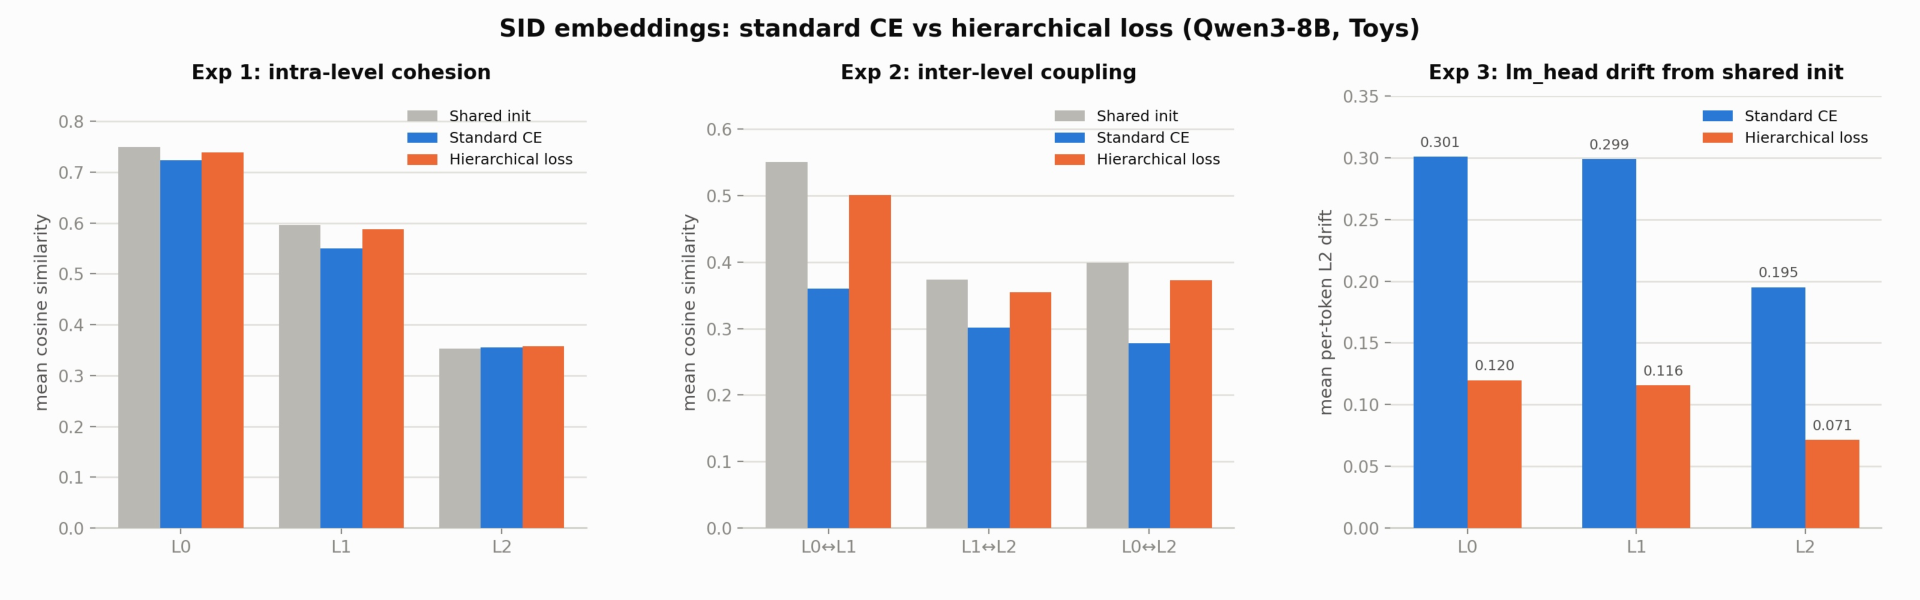
🔧 Hierarchical Loss:不再把SID当成一串扁平token,而是按残差量化的层级逐层给监督。粗层给更大的基础权重(4/3/2/1),细层权重再用模型对上游code的置信度(detach过的)做门控,并且从最初的静态权重退火到条件门控,再加scheduled sampling扰动前缀,缩小训练和推理之间的曝光差距。
🧩 Attribute-Specific Losses:在最细SID那一步的隐状态上挂两个轻量MLP头,分别回归CIELAB颜色和材质成分,用Huber loss,目标从类目属性聚合而来,并按item频次加权,把监督刻意往尾部item上压。
⚙️ 两个损失都是加在现有生成式推荐框架上的微调目标,不动tokenizer和主干网络,落地成本主要落在属性标注这条数据链上。
📊 Hierarchical Loss做到约2倍收敛加速,同时推荐质量持平或更好。
📈 flat CE微调后,相邻SID层的余弦耦合从0.55掉到0.36(-35%);层级损失只掉到0.50(-9%),embedding相对初始化的漂移也少2-4倍。
✅ 尾部颜色的top-1误差从54.5降到50.2,torso颜色从33.5降到29.0,head颜色基本不动(12.5到12.6),增益正好落在监督最弱的地方。
📉 评测覆盖Fashion-140k、Amazon三个子集(P5 5-core协议)和一个内部生产级时尚类目,跨数据集、跨item频次段都有提升。
如果你在做生成式召回、SID又恰好来自RQ-VAE或残差k-means这类层级码,这个损失可以直接在自己数据上试一版,改动小、风险可控。要盯的指标不只是整体Recall,而是分频段效果和达到同等质量所需的步数。坑在于属性监督依赖类目侧标注,属性缺失或噪声大的类目,辅助头可能把表示带偏;另外基线一定要用同backbone、同数据的flat CE,否则那2倍收敛很容易被别的东西吃掉。