推荐算法日报 · 2026-10-15
总览
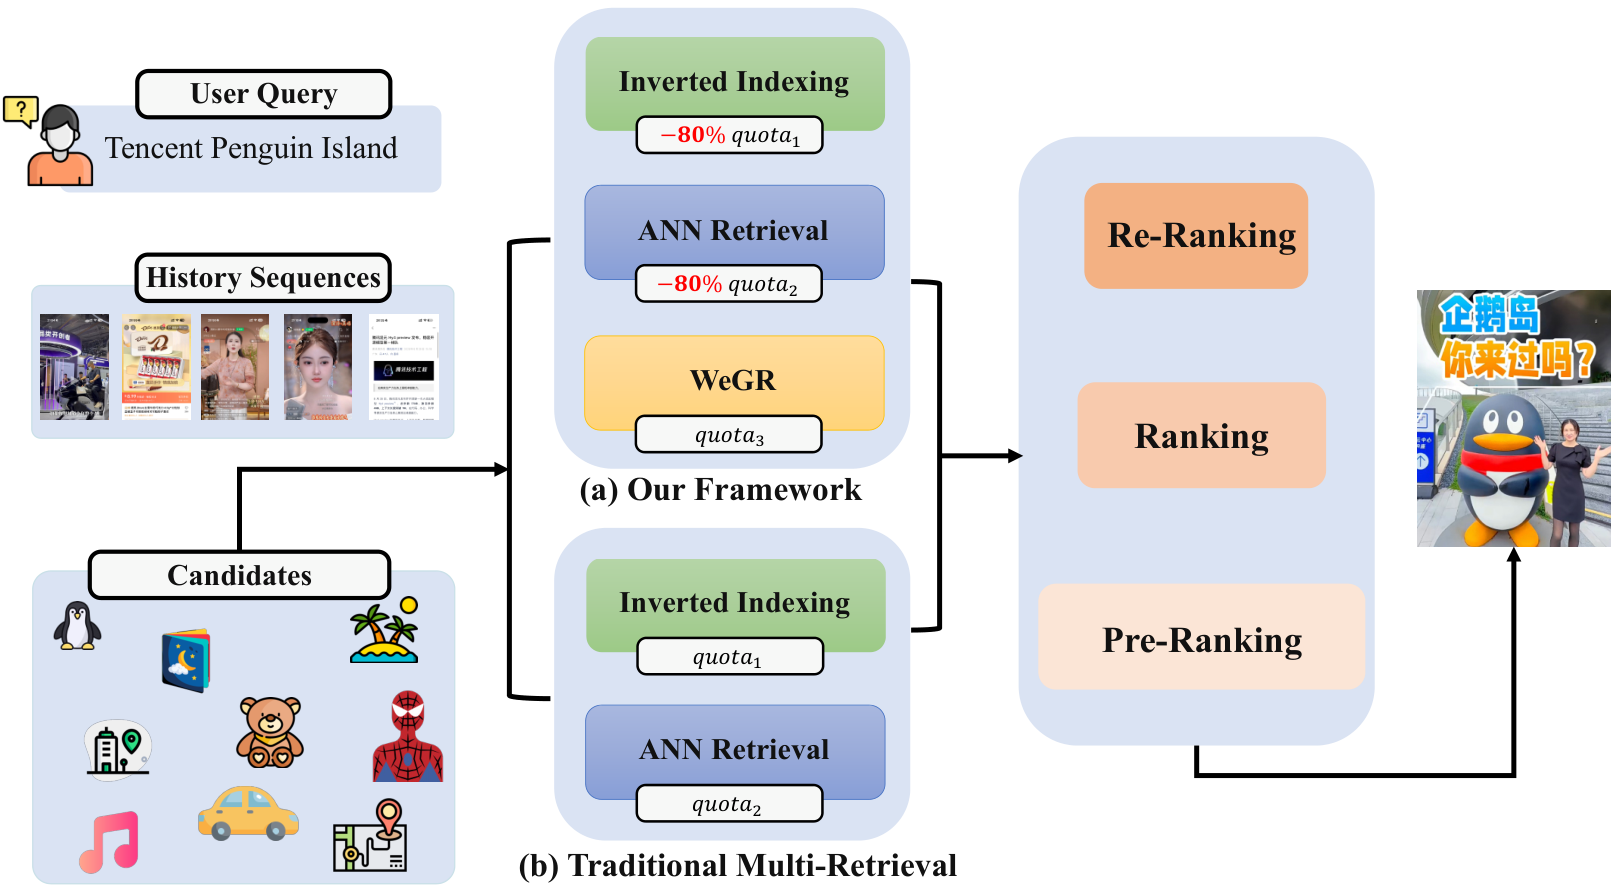
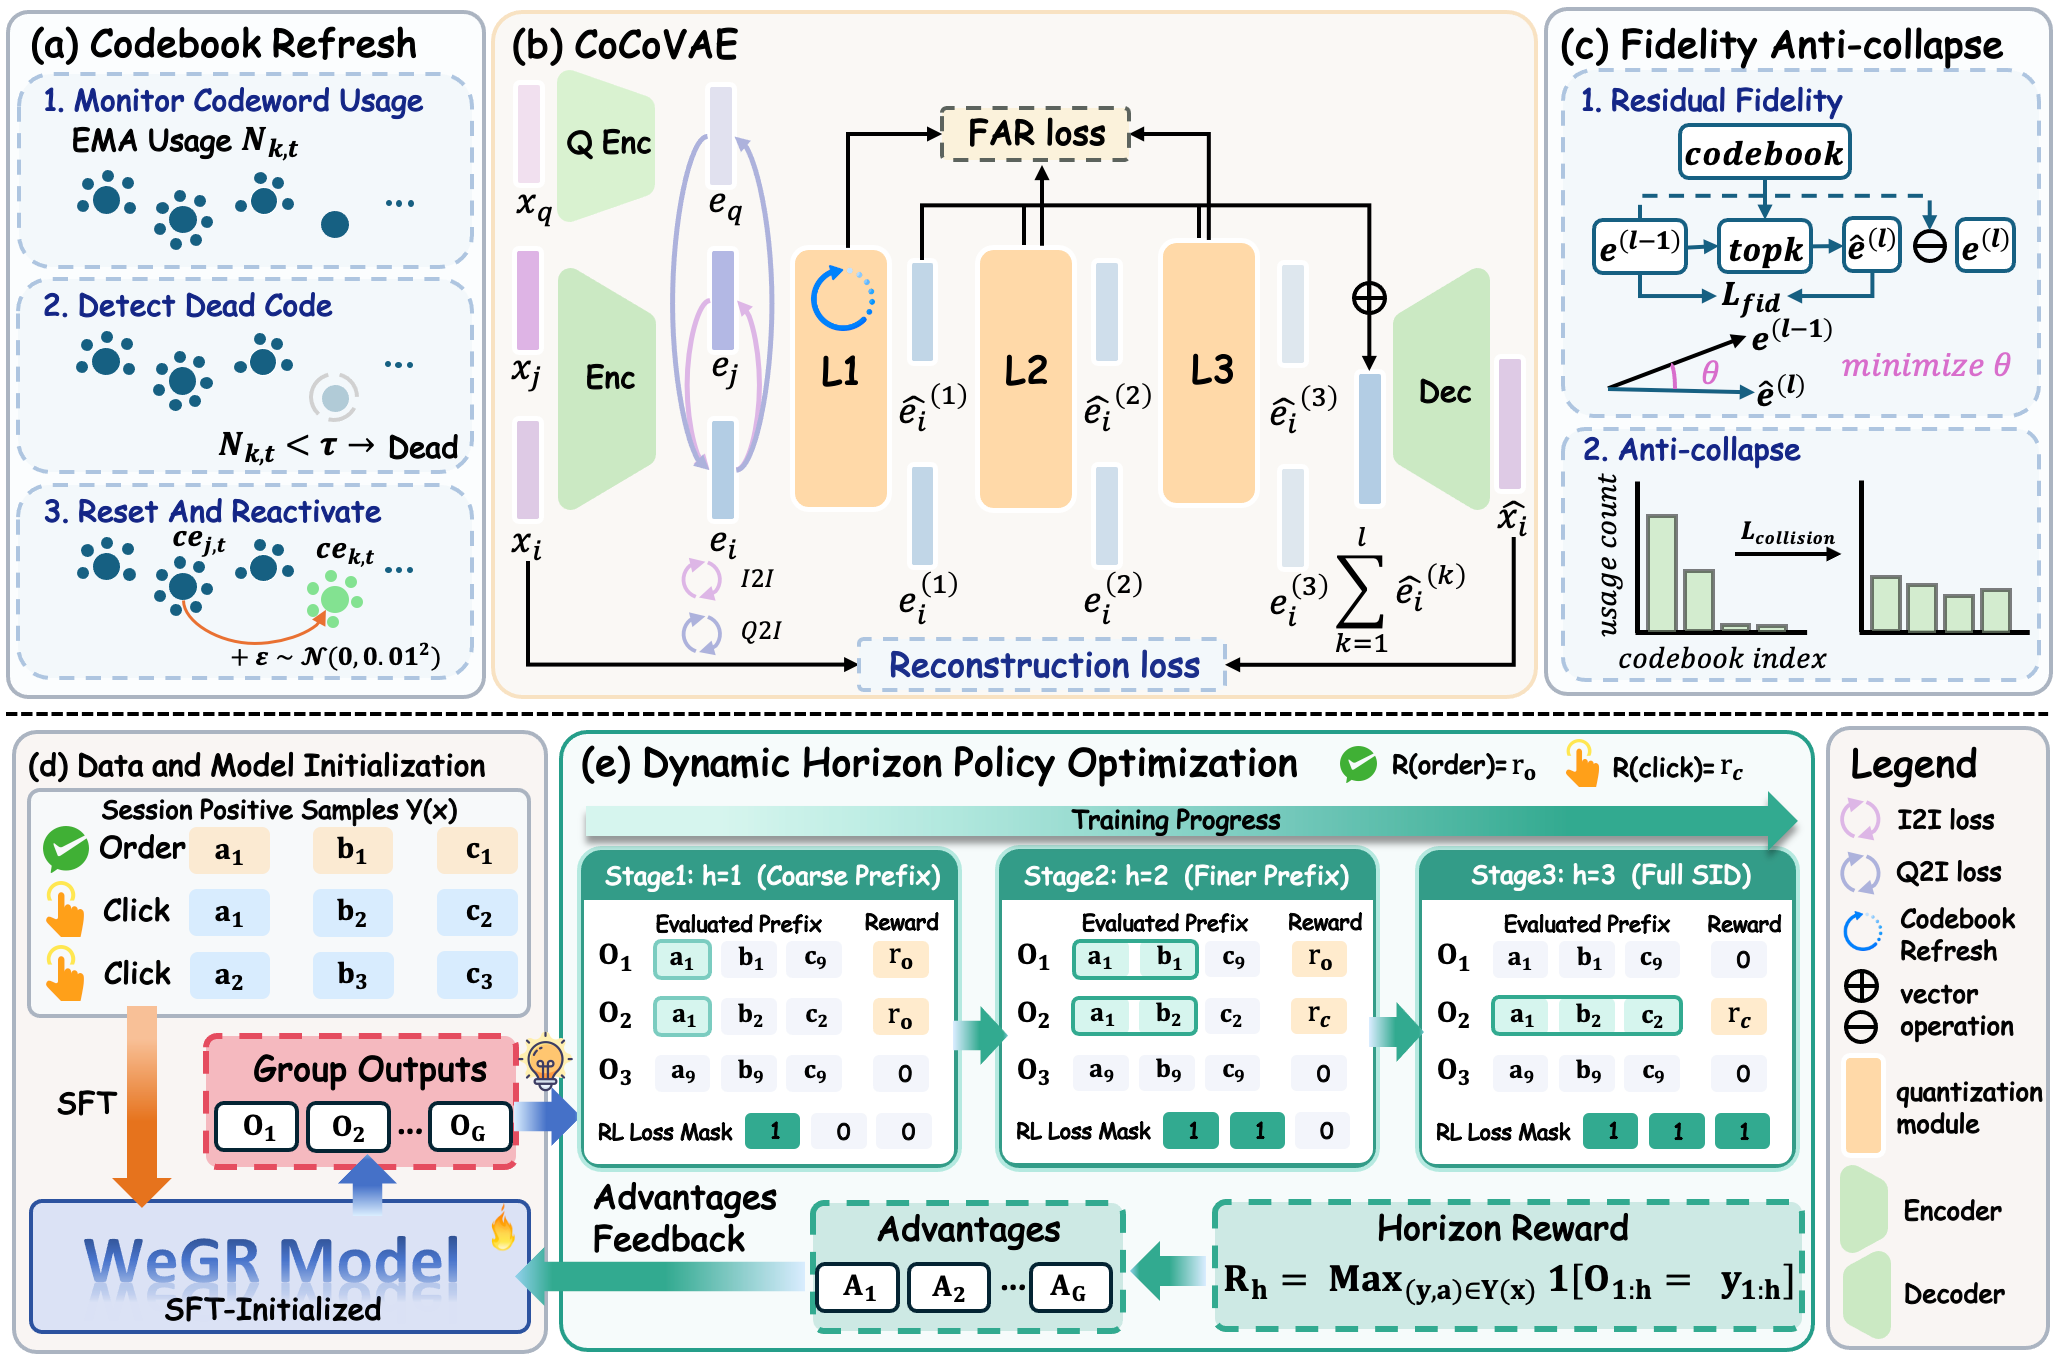
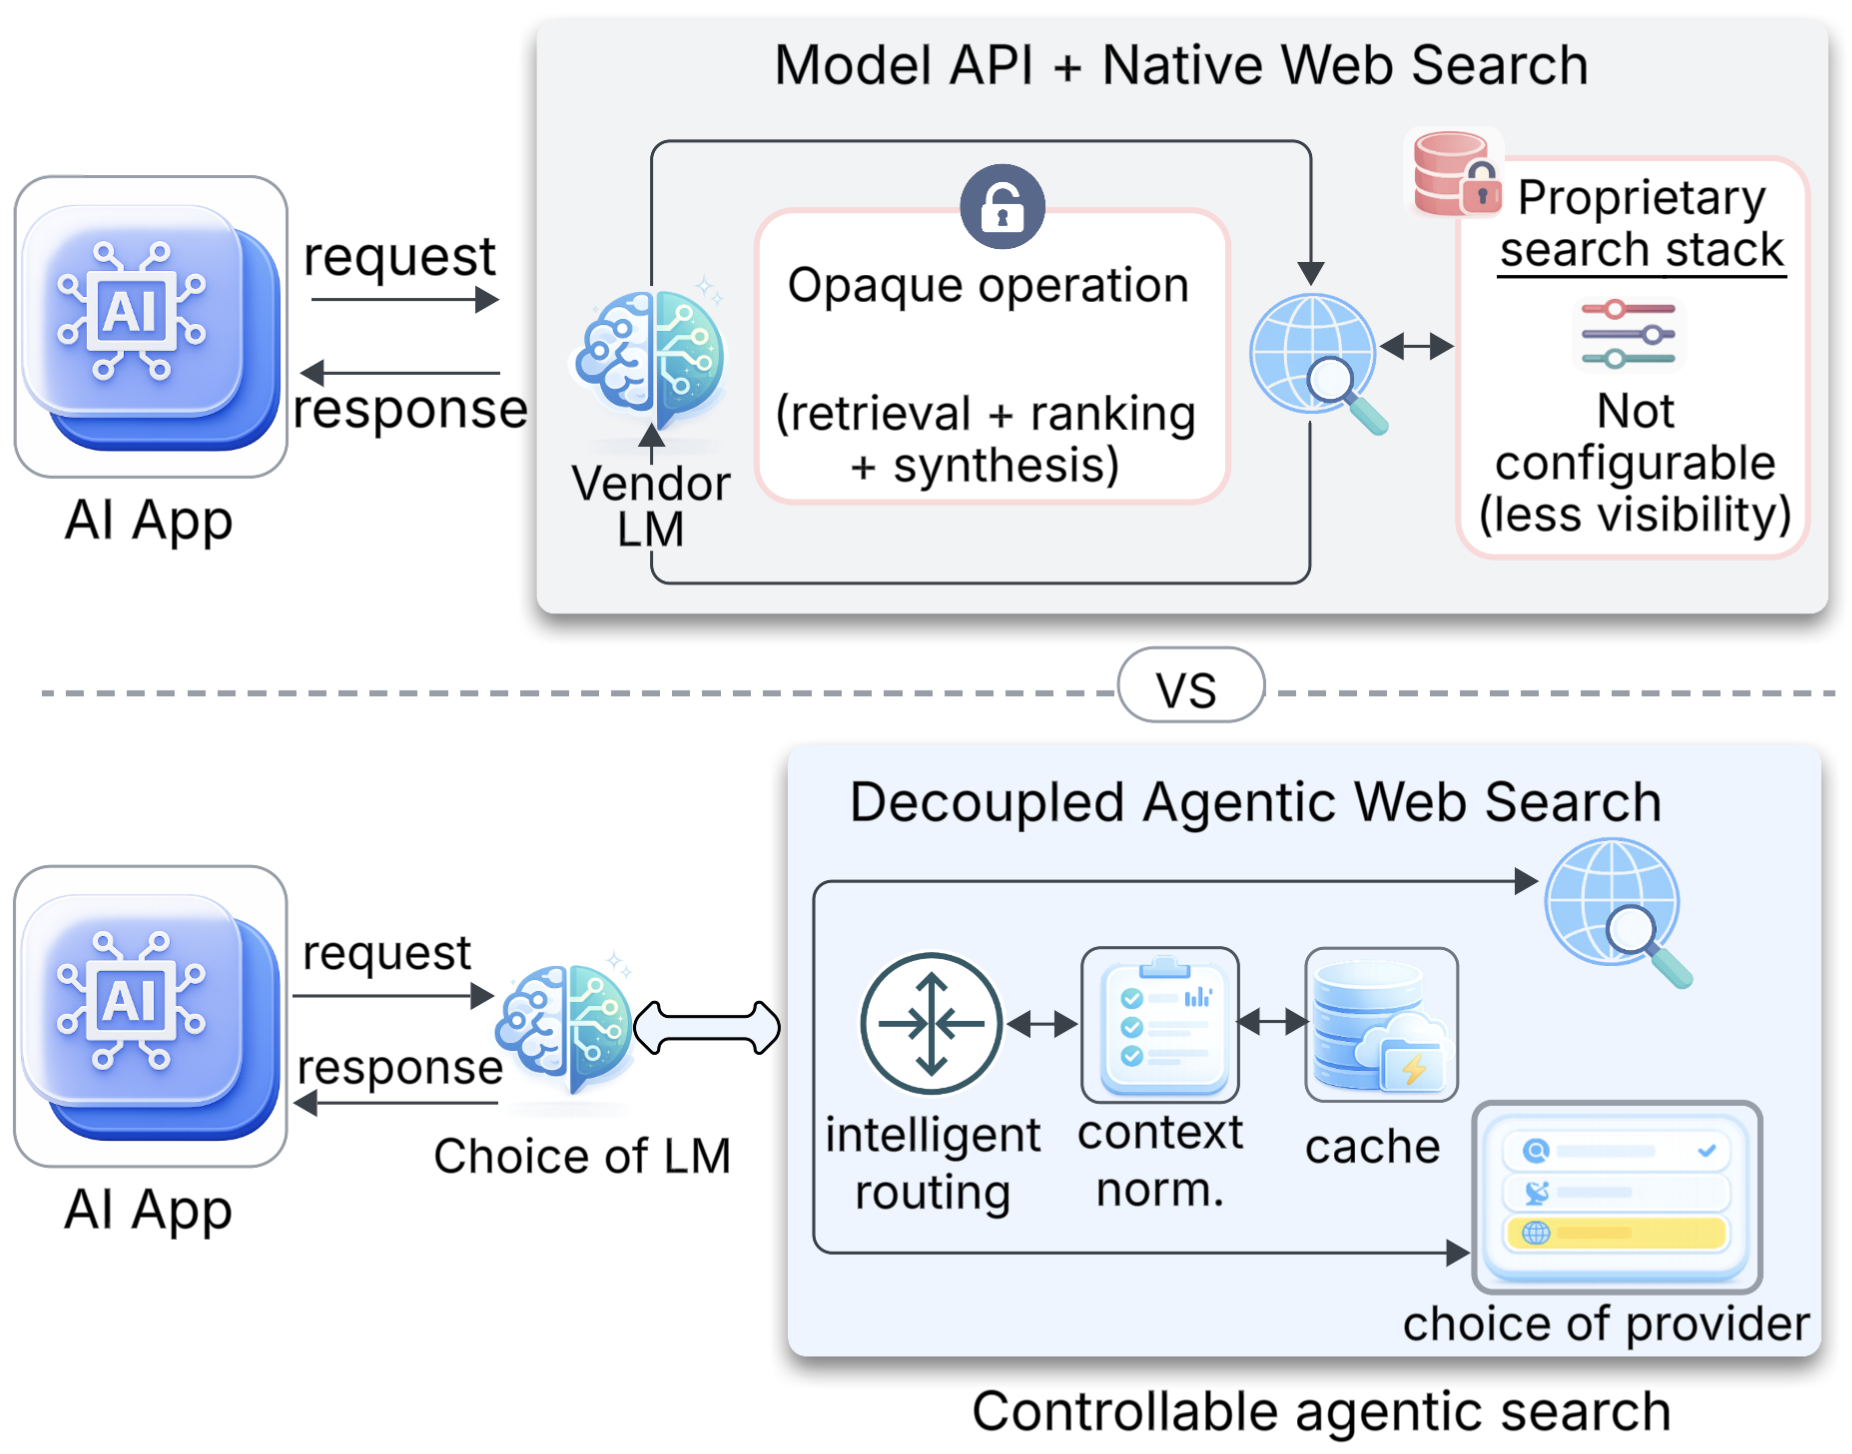
今天这批论文的味道挺一致,六篇里有三篇都在跟生成式检索较劲,从微信搜索的工业级落地、阿里国际的步进式特征交叉,到 Shopify 试图用一个静态值先验把这个方向的老结论整个翻过来。最值得先读的其实是 Shopify 那篇,它不吹生成式检索多强,反而给出一个简单先验就能反超稠密检索的结果,属于那种能让人重新审视主流叙事的文章。微信那篇的价值在另一头,工业搜索系统的完整生成式方案本身就少见,工程细节值得抠。剩下几篇偏架构和评测,把 LLM agent 的检索和推理拆开的那套厂商无关方案思路很干净,落地时可以直接借鉴;ChatGPT 引用行为那篇则是拿生产环境跨代际的数据说话,做引用可溯源的同学别错过。至于 SPARQL 挑战赛那篇,更像一份赛题答卷,除非你正好在做知识图谱问答,否则可以快速略过。今天的优先级很清楚:先把 Shopify 和微信那两篇啃完,再去扫解耦架构那篇。
论文列表
1. WeGR: Unified Generative Retrieval for Industrial Search Systems in WeChat
- 论文链接:AlphaXiv
- 更新时间:2026-10-12 15:38 UTC
- 机构:未披露机构
- 工业优先级:未标注
- 备注:11 pages, 4 figures, conference
精读生成失败
(这篇的精读暂时没能生成出来,原因:模型返回空内容(finish_reason=None,usage={})。通常是 max_tokens 被思考 token 耗尽,请调大 llm.max_tokens。。可以先看上面的总结和图表。)
2. Decoupling Search from Reasoning: A Vendor-Agnostic Grounding Architecture for LLM Agents
- 论文链接:AlphaXiv
- 更新时间:2026-10-11 06:58 UTC
- 机构:未披露机构
- 工业优先级:未标注
- 备注:Accepted at the EMNLP 2026; 16 pages, 9 figure
精读生成失败
(这篇的精读暂时没能生成出来,原因:模型返回空内容(finish_reason=None,usage={})。通常是 max_tokens 被思考 token 耗尽,请调大 llm.max_tokens。。可以先看上面的总结和图表。)
3. Understanding ChatGPT Citations: Evidence from Production Web Search Across Model Generations
- 论文链接:AlphaXiv
- 更新时间:2026-10-11 06:20 UTC
- 机构:Xi’an Jiaotong University,SGIT AI Lab, State Grid Corporation of China,National University of Singapore
- 工业优先级:未标注
- 备注:10 pages, 5 figures
ChatGPT引用只有1/4能复现🔍
各位算法同学们,在ChatGPT里被引用一次,换个模型设置可能就查无此人。这篇工作把ChatGPT Web从检索到引用的整条链路扒开看了一遍,还顺手测了两个外部代理到底能还原多少。
📄 Understanding ChatGPT Citations: Evidence from Production Web Search Across Model Generations
🔧 作者从服务端SSE trace里还原完整执行链:改写query、检索候选、挑引用,并且把分析拆到URL、hostname、entity三层,而不是只看最终回答里出现了谁。
🧩 四个设置的行为差异很大:Instant基本是单轮,5.3平均只执行1.06次查询、5.5是1.45次;5.4 Thinking平均跑到11.82轮,后几轮还会不断收窄搜索目标。
⚙️ 同一query重复跑20次,候选网页在被检索时出现得越频繁,被引用的概率越高;检索snippet更长也是个弱但稳定的正向信号,这点可以直接当监控指标用。
📊 数据规模:5.3和5.5各80个query跑20次,各1600次运行;5.4 Thinking平均返回73.5个主候选,最终只引用7.81个,检索可见和引用可见完全是两回事。
📈 拿Google Search加Responses API当代理,合起来只召回28.3%和26.2%的被引URL,换到hostname层能到50.3%和48.7%,URL级对齐本身就是个伪命题。
✅ 把两个代理的信号拼进监督模型后,5.3 instant在URL、hostname、entity三层AUC为0.782、0.763、0.743,5.5是0.779、0.763、0.742。
总结:做GEO监测的同学,指标别只盯URL层,hostname和entity层才是外部代理能对上的地方;模型设置一换(Instant换Thinking、版本迭代)策略就得重测。坑也直白:AUC是在外部代理候选集内部算的,覆盖只有四分之一左右,不能拿它当全量线上效果的替代。
4. Revisiting Generative vs. Dense Retrieval: A Static Value Prior Reverses the Gap
- 论文链接:AlphaXiv
- 更新时间:2026-10-13 19:02 UTC
- 机构:Shopify,University of Toronto
- 工业优先级:未标注
14B生成检索输给47倍小模型
各位算法同学们,14B 的 SID-LLM 在工业电商数据上,还是打不过一个参数量小 47 倍的 dense encoder。这篇把 GR 和 DR 的输赢拆到指标层,结论不是谁全面更强,而是你用什么指标,谁就赢。
📄 Revisiting Generative vs. Dense Retrieval: A Static Value Prior Reverses the Gap
🔧 先定义互补指标:best relevant item value 和 whole-list value,补上 exact-target recall 看不到的替代品价值。GR 在两者都覆盖的用户里 best item value 赢,DR 在 exact-target recall 和整列相关价值上赢。
🧩 分解 GR 的价值领先,发现 popularity 是最大来源:在 GR 赢的用户里,popularity 贡献 49.8%(Amazon Toys 2014)和 65.4%(2023)。
⚙️ 提出 training-free 的静态 item value prior,只给 DR 加一步 rerank,就反转 best-item value 差距,同时 recall 仍高于 GR。
📊 Amazon Toys 2014 有 11,924 个 item、19,412 条用户历史,采用 leave-last-out 划分。
📈 2023 catalog 规模大 13.6×,value 权重和 rerank 系数从 2014 直接迁移,结论还在。
✅ 工业级内部电商数据用 LLM 判相关性,14B SID-LLM 仍低于小 47× 的 dense encoder。
📉 cold target、substitute credit、random control、graded relevance 等检查里,没有稳定看到 GR 优势。
如果只盯 Recall@10 或 target NDCG,容易把 popularity 误读成 GR 的能力。落地前先看指标是否只奖励 held-out item,再试 DR 加一步 value rerank 的性价比。坑是 value 权重是透明代理,不是通用推荐效用,换业务得重新校准。
5. UniSGR-V2: Stepwise Target-Side Feature Anticipation and Crossing for Generative Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-10-12 03:48 UTC
- 机构:Alibaba International Digital Commerce Group
- 工业优先级:未标注
生成式推荐的目标特征盲区,有解了🔍
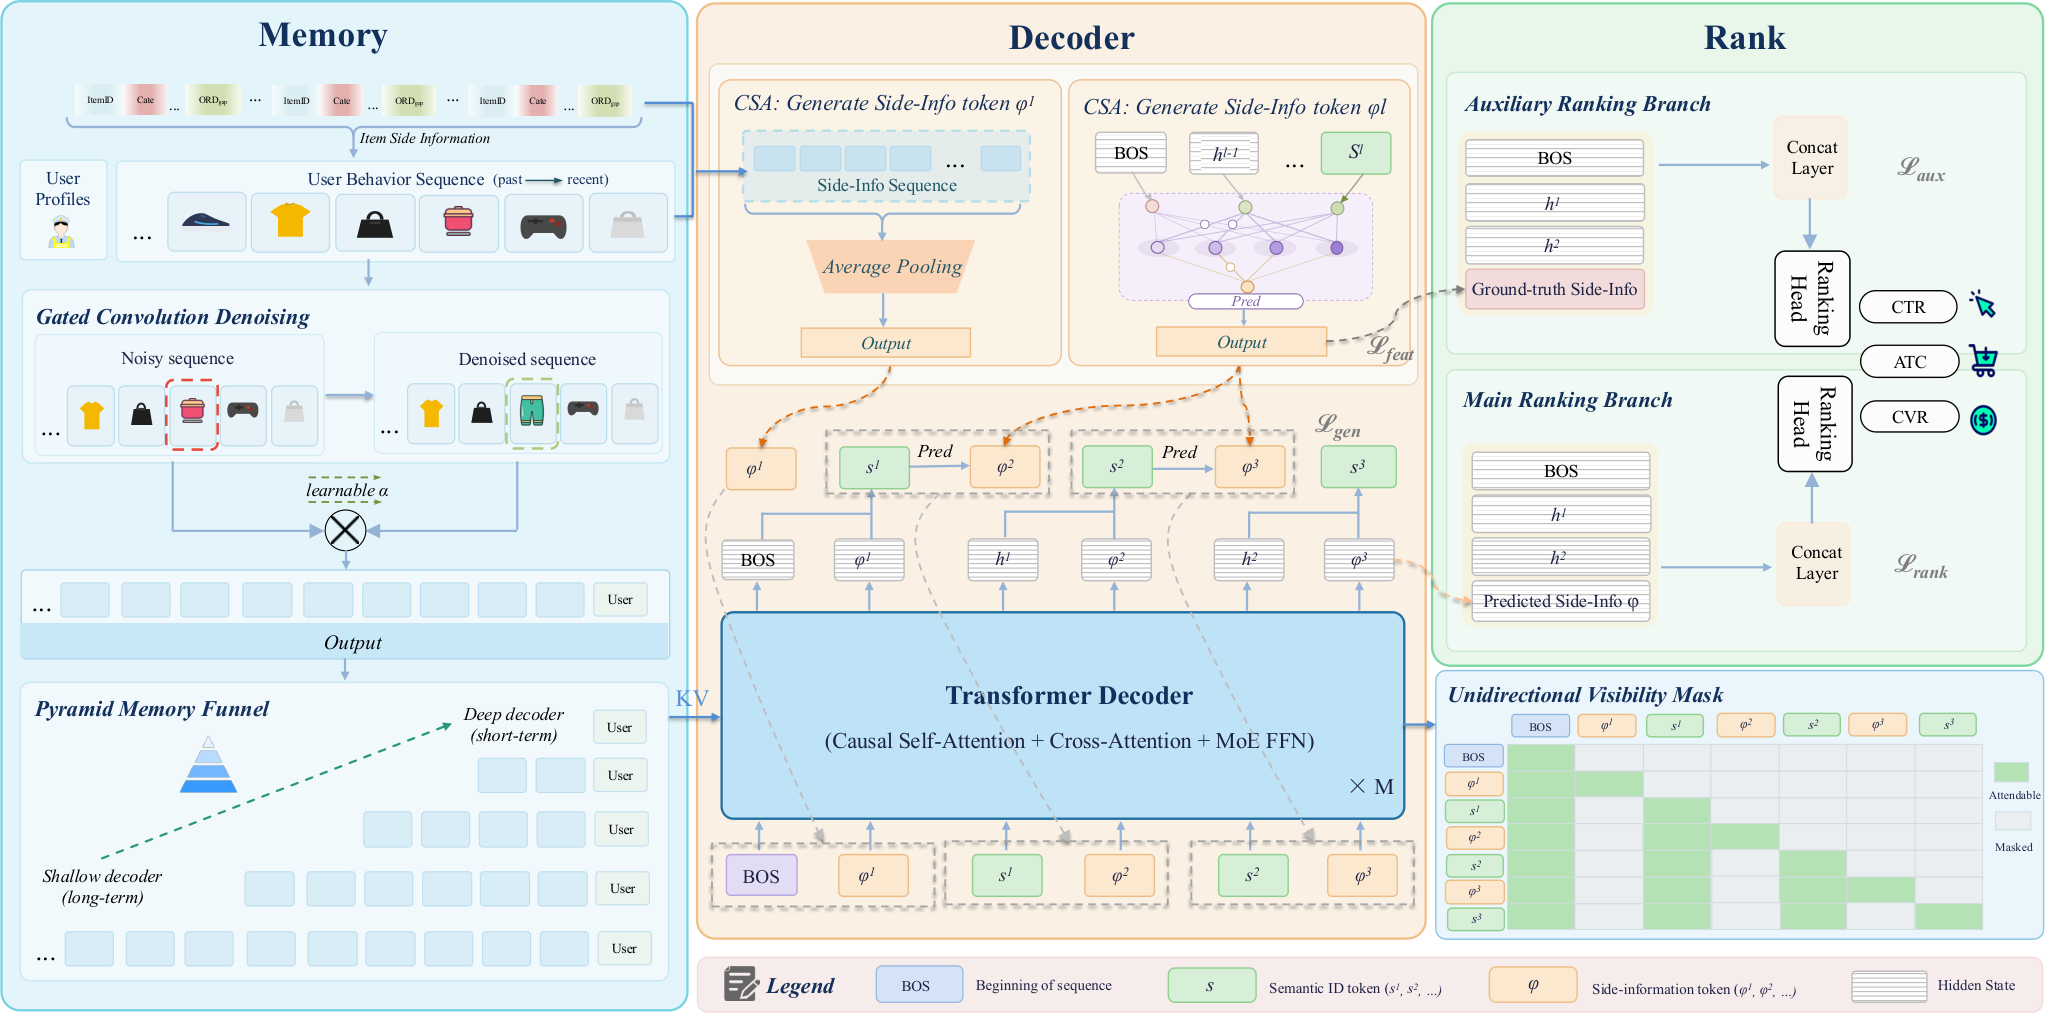
各位算法同学们,生成式推荐有个反常识的结构性缺口:模型逐层解码 semantic ID 时,全程看不到目标商品的类目、店铺、品牌,因为目标还没生成出来,特征根本没地方查。这篇就是冲这个「目标侧特征真空」去的。
📄 UniSGR-V2: Stepwise Target-Side Feature Anticipation and Crossing for Generative Recommendation
🔧 核心做法是在解码路径内部预测一个连续的目标侧特征向量,再和语义前缀、用户行为序列在 decoder 里交叉,同一份表示既给当前层生成当条件,又直接拿去排序,不用再挂事后查特征的补救管线。
🧩 回归连续向量有两个新麻烦:可学习的回归目标可能和预测一起塌缩成平凡解,预测噪声还会顺着 attention 污染生成。前者用语义锚定辅助塔加任务对齐约束,后者用单向可见性 mask 切断——语义 token 不能看预测 token,预测 token 之间也互不可见。
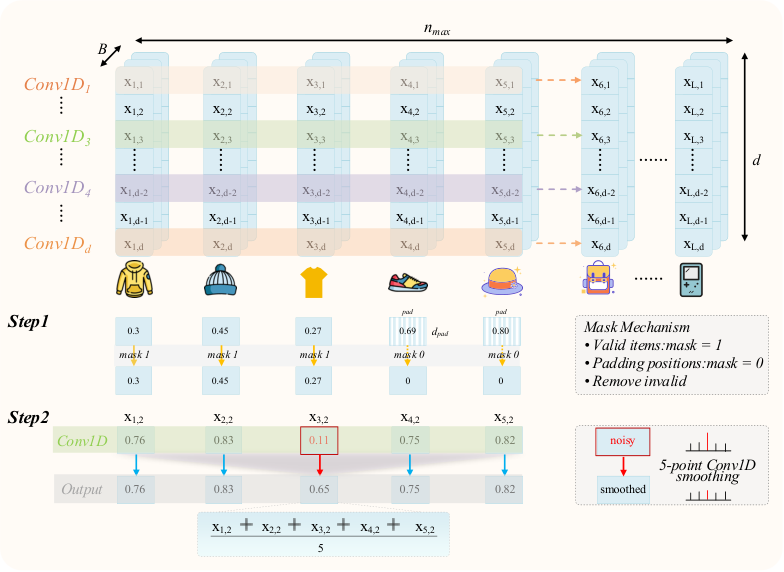
⚙️ 工业长行为序列上,门控卷积去噪压掉脏交互,再改造金字塔记忆漏斗的收缩维度降推理开销。
📊 离线在 Lazada 大规模数据集上,四个召回指标和四个排序指标全部超过 UniSGR,也优于 OneRec、UniRec。
📈 线上 A/B:IPV +0.79%,Order +5.55%,GMV +3.09%。
✅ 对比 UniRec 的 Chain-of-Attribute:那条路先自回归生成离散属性 token,错一步不能回退,属性维度一多解码步数线性增长,带宽还被词表卡住;换成连续向量回归就没这个粒度限制。
做端到端生成式推荐、排序头直接挂在 decoder 上的同学可以跟一下这条路线。要盯的坑是连续回归目标有没有真学出判别性,别退化成和预测互相塌缩的自证循环,论文自己承认这点,语义锚定塔属于缓解不是根治。另外 GMV 涨 3.09% 而 IPV 只涨 0.79%,收益主要吃在高价值转化,冷启和低频品类能不能复现得单独验。
6. SPARQL-LLM in the TEXT2SPARQL 2026 Challenge
- 论文链接:AlphaXiv
- 更新时间:2026-10-09 14:25 UTC
- 机构:未披露机构
- 工业优先级:未标注
- 备注:6 pages, 1 figure, 5 tables
实时生成SPARQL,3美元拿下冠军🏆
各位算法同学们,Text2SPARQL 2026 的第一名,全程没有 agent 循环,每次提问调用 LLM 的次数是固定的,整场比赛所有 LLM 调用加起来花了不到 3 美元。
📄 SPARQL-LLM in the TEXT2SPARQL 2026 Challenge
🔧 不做 agent 探索,走检索式上下文:查询前就把示例问答对(LC-QuAD、QALD-9+、2025 年测试集)和 endpoint 的 schema 拼进 prompt,每问的 LLM 交互次数固定,不存在收敛失败,也没有几十次工具调用堆出来的 token 账单。
🧩 面对完全未知的 Corporate KG,没有现成语料,就用 DeepSeek-V3 按 13 个类、30 个属性生成问答对,再把生成的 SPARQL 拿到 endpoint 实跑,零结果的直接丢掉。
⚙️ 支持英语、德语、西班牙语,代码开源,并且已经部署在去中心化的生物信息 KG 上对外提供服务。
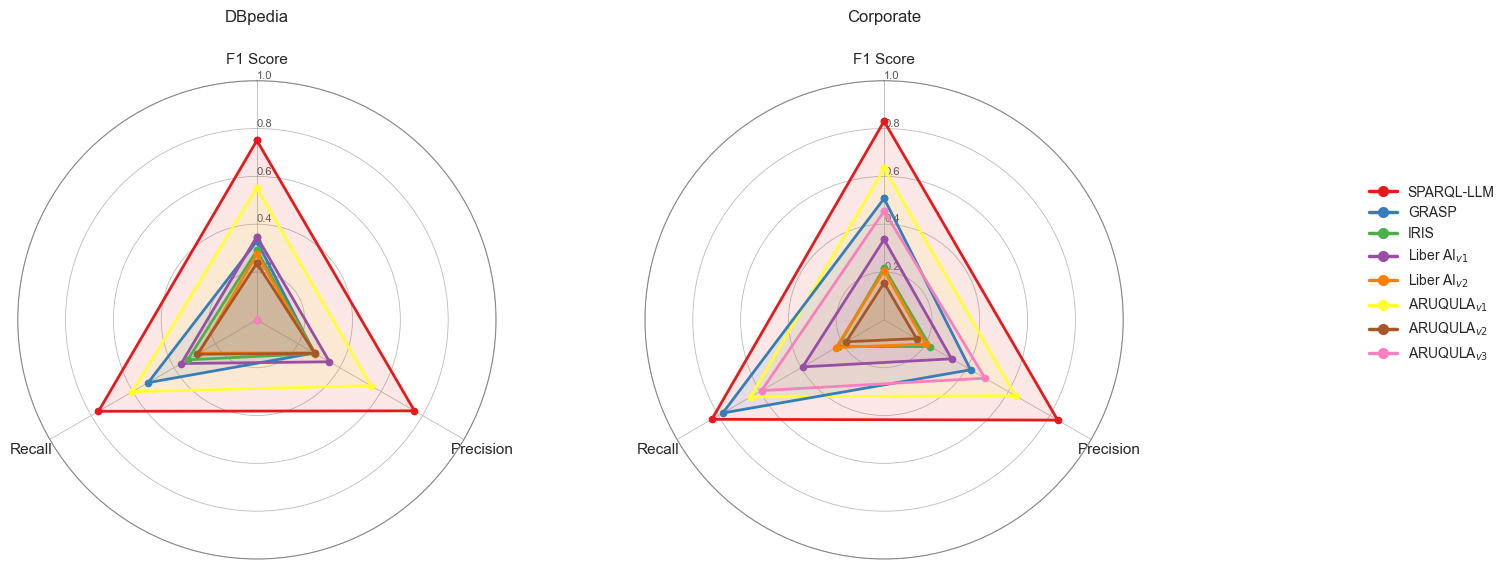
📊 DBpedia 英语 F1 0.7192,比第二名 ARUQULA 高 17%
📈 DBpedia 西班牙语 F1 0.7810,比第二名高 59%
✅ Corporate 英语 F1 0.8539(高 33%)、德语 0.8141(高 30%),NDCG 都是 1.0
💰 八支队伍参赛,它在所有数据集和语言上都是第一,全部 LLM 调用总花费不到 3 美元
要盯的就两点。一是它的收益来自示例覆盖度,换一个全新 KG,这套“生成示例再回灌 endpoint 验证”的流程得重走一遍,成本和质量都压在示例集上。二是它和 agent 式方案是明确的取舍,放弃了对任意复杂查询的自适应,换来固定延迟。如果你要做低延迟、低成本的 text2SPARQL 落地,这套架构比单看 F1 更有移植价值;如果查询模式五花八门、明显超出示例分布,先做自己的覆盖度测试再上。顺带一提,ARUQULA 的 v3 变体在某些语言上直接掉到 0.0000,看多系统对比时别只盯最好的那个变体。