推荐算法日报 · 2026-10-14
总览
今天这批只有两篇,但都在啃硬骨头:一篇讲超长用户序列怎么既便宜又不丢目标信息,一篇讲 bundle 推荐里 user-item-bundle 这种三元关系怎么一股脑塞进超图。UxSID 是我今天最想推的一篇,它没在「逐候选搜索太贵」和「统一压缩丢信息」之间二选一,而是用 SID 做语义分组、按组共享兴趣记忆,最实在的是在线只做 O(1) 查表、序列拉到 10k 延迟基本不变,而且有一周线上广告 A/B 撑着——虽说目前只有广告场景、作者自己也标了 work in progress,但这是今天唯一一个能讲完整落地故事的。另一篇超图 bundle 推荐走的是暴力美学路线,跨类型块和阈值化生成的同类边全保留、item-item 直接置零,指标确实涨得漂亮,NDCG 涨幅普遍大于 Recall 说明赚的是排序不是召回覆盖,可代价太狠了,内存是 CrossCBR 的八倍多、iFashion 直接 OOM,验证集协议偏松又没有独立测试集和多种子,所以只能算离线数字。两篇在方法层面都有值得抄的设计,但证据强度差了一档:一个是能往工程里推的方案,一个是需要先解决内存和评测规范再谈落地。今天优先看 UxSID,重点抠它的语义分组和离线预计算缓存那套;超图那篇当对照读物翻翻就行,别被涨幅冲昏头。
论文列表
1. UxSID: Semantic-Aware User Interests Modeling for Ultra-Long Sequence
- 论文链接:AlphaXiv
- 更新时间:2026-10-09 08:29 UTC
- 机构:未披露机构
- 工业优先级:强
- 备注:Work in progress
长序列推荐第三条路,10k序列常数推理
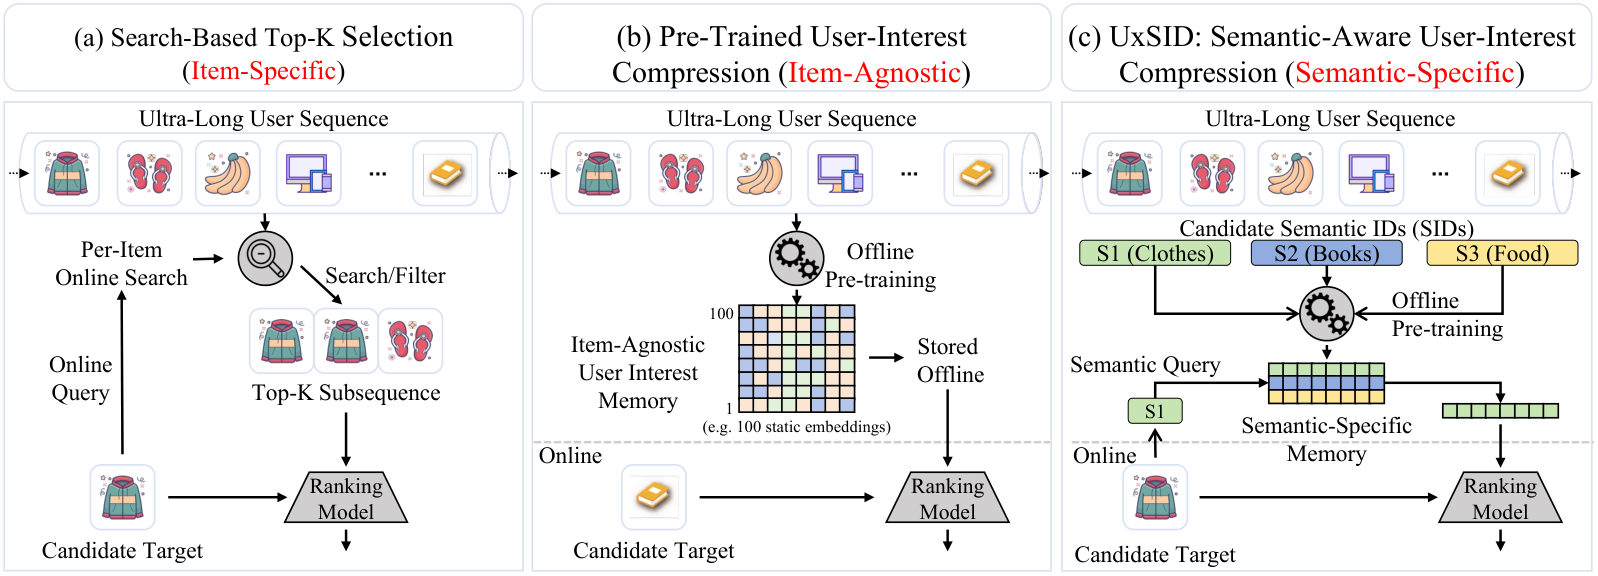
各位算法同学们,长序列建模不一定要在“每个候选都检索一遍”和“压成一坨用户向量”之间二选一。UxSID 走的是中间态:用 Semantic ID 把兴趣压缩成语义组共享的记忆,序列拉到 10k 级别线上仍是常数级推理,广告 A/B 收入涨了 0.337%。
📄 UxSID: Semantic-Aware User Interests Modeling for Ultra-Long Sequence
🔧 第三条路:语义组共享兴趣记忆。既不做 item-specific 的逐候选检索,也不做 item-agnostic 的静态压缩,而是让同一 SID 语义簇下的候选共享同一份压缩后的用户兴趣,保留目标相关性,但只暴露有限信号去引导压缩方向。
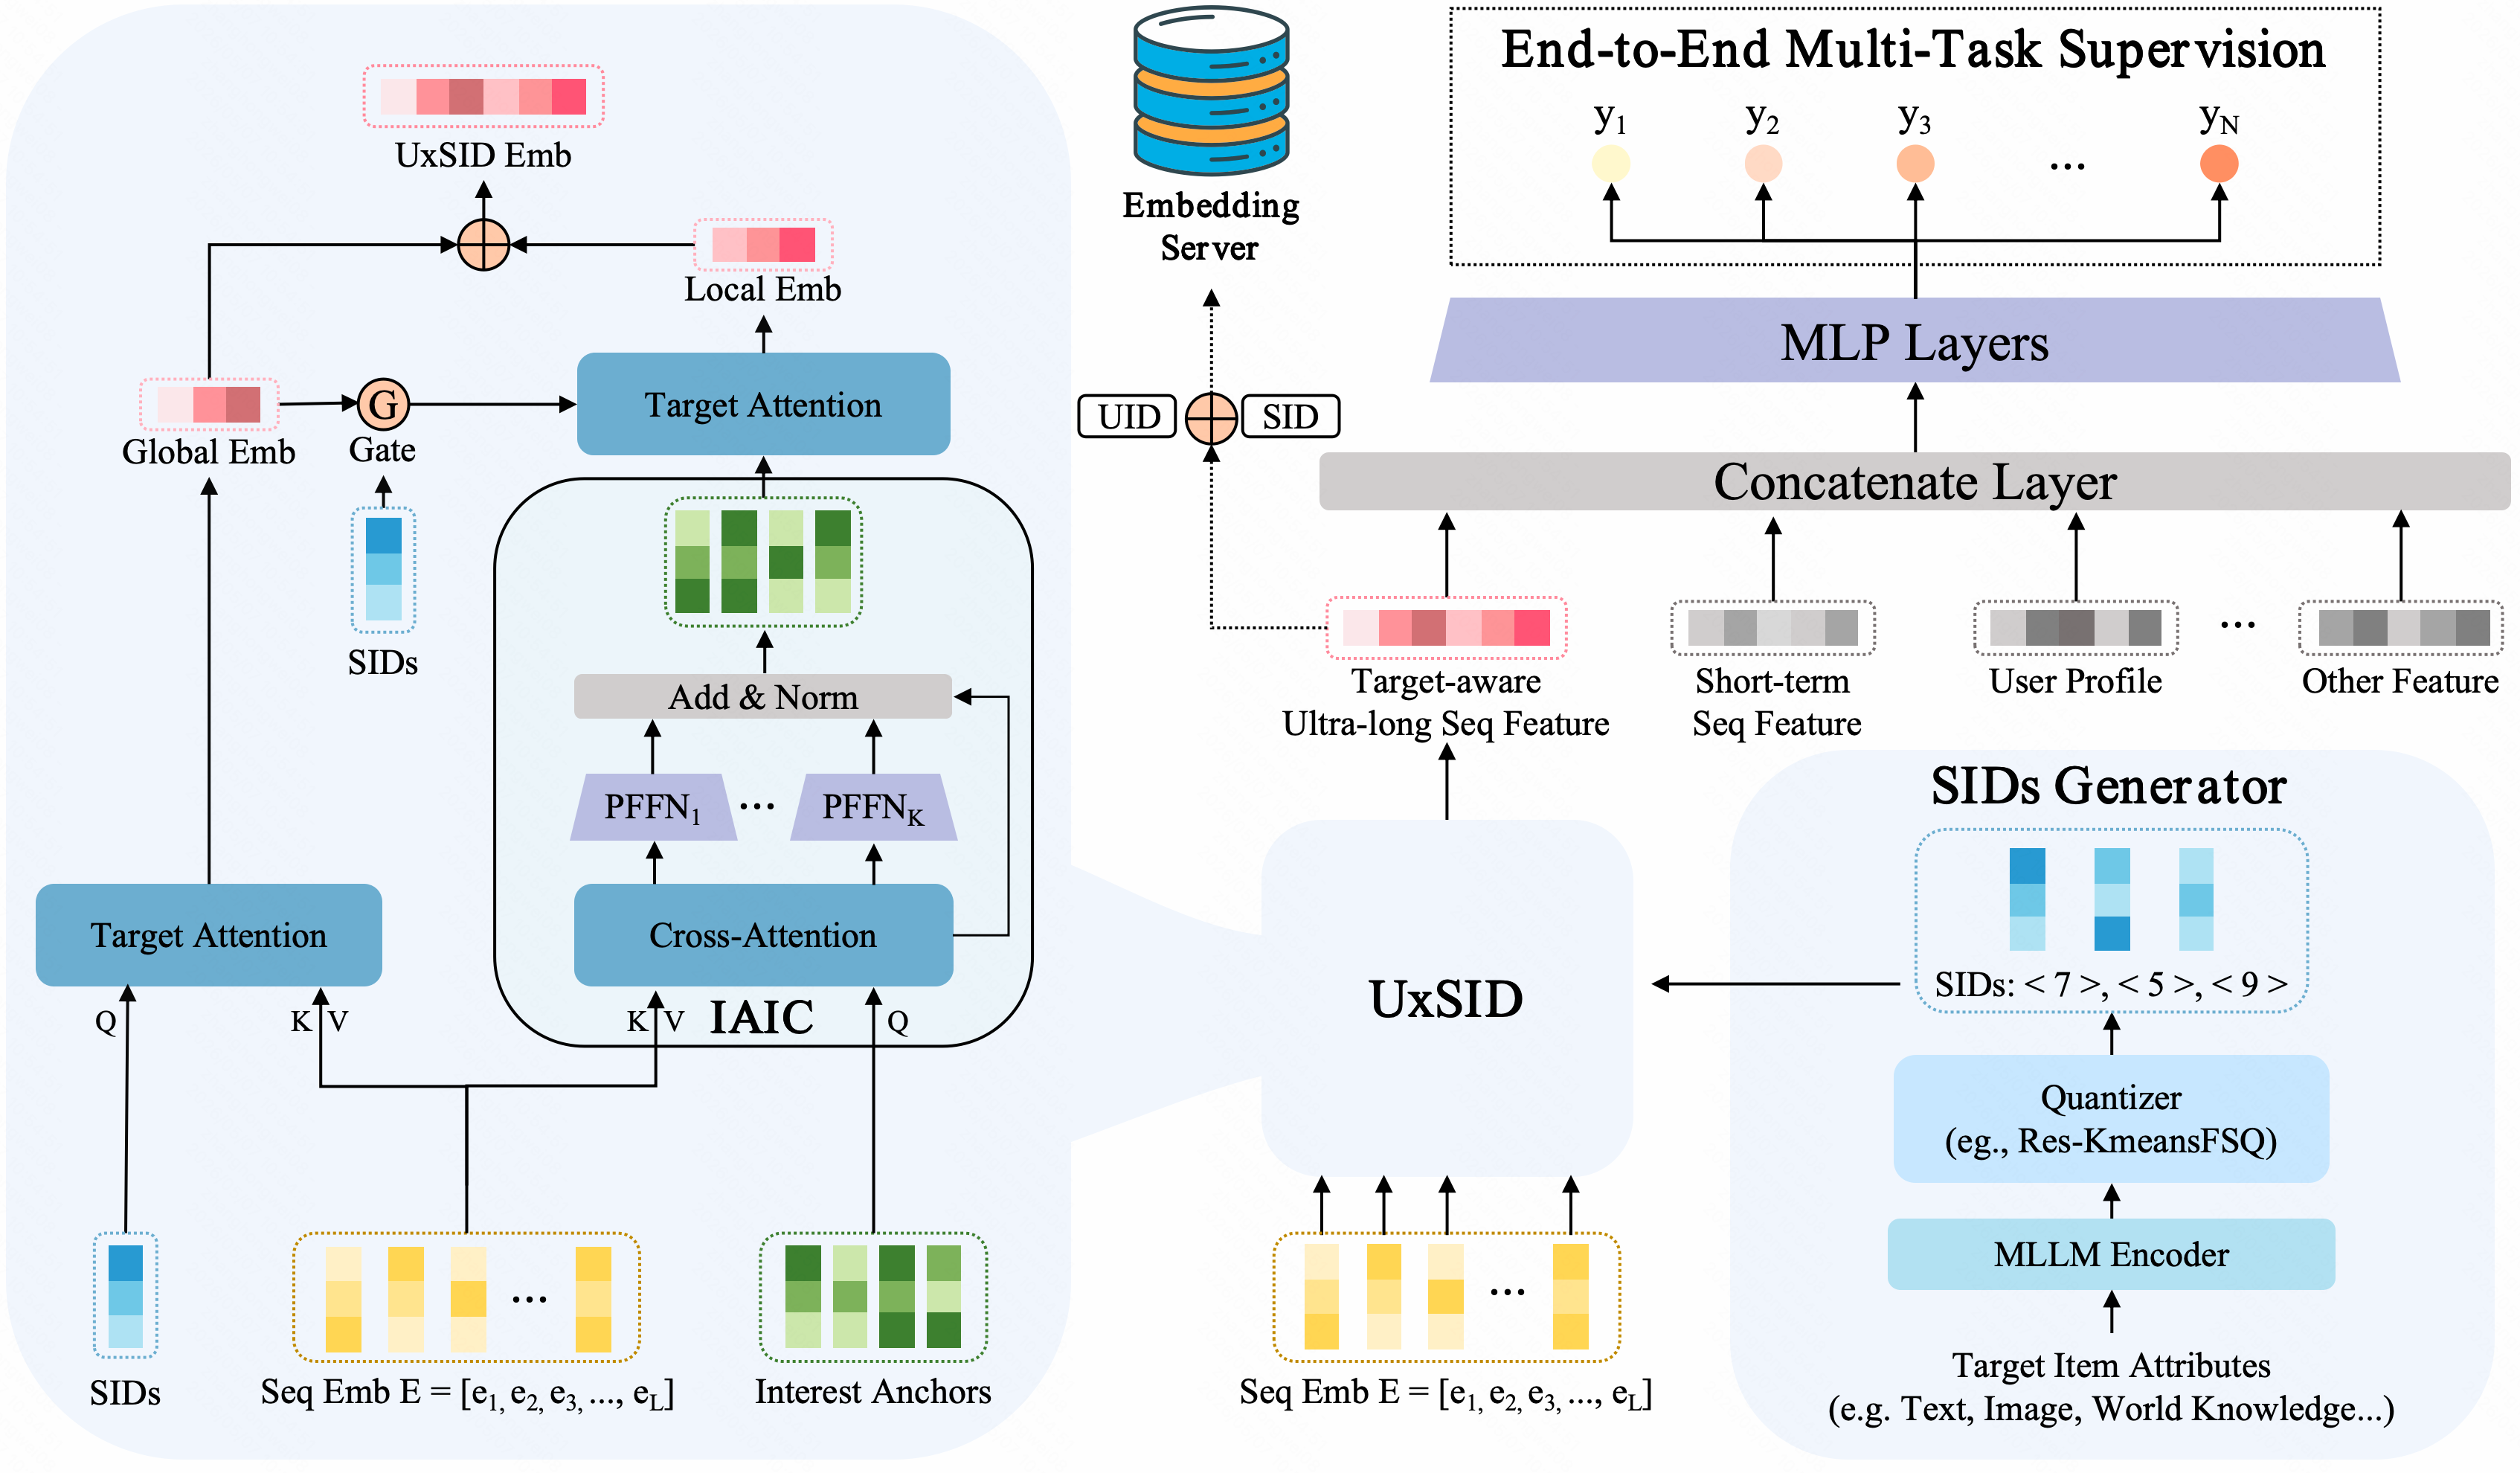
🧩 两级注意力拆成“压缩 + 探测”。IAIC 先把异构历史压成一组可学习兴趣锚点,用 PFFN 加正交约束逼每个锚点抓不同偏好面,防止表征塌缩;分层语义探测再从超长序列抽全局细粒度信号,用门控语义 query 动态融合压缩兴趣,放大目标相关、过滤噪声。
⚙️ 离线 embedding 和线上推理严格对齐,端到端训,不靠特判。
📊 公开 benchmark 上超过 SOTA,对比的是 SIM、TWIN 这类检索派和 MIMN、LURM、C-Former 这类压缩派。
📈 快手大规模线上 A/B,广告收入 +0.337%。
✅ 序列扩到 10k 交互量级,推理时间与资源占用保持常数级,满足了毫秒级延迟约束。
总结一句:这篇主要对做工业推荐、被长序列 serving 延迟卡住的人有用。要盯的不是离线 AUC,而是序列继续往上加时延迟曲线是不是真的平;另外 SID 质量基本决定上限,RQ-VAE 那套量化如果和业务语义对不齐,压缩出来的兴趣记忆可能只是换个方式丢信息。
2. Hypergraph-Enhanced Dual Convolutional Network for Bundle Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-10-07 11:10 UTC
- 机构:未披露机构
- 工业优先级:中
超图+双通道,捆绑推荐涨了7%?
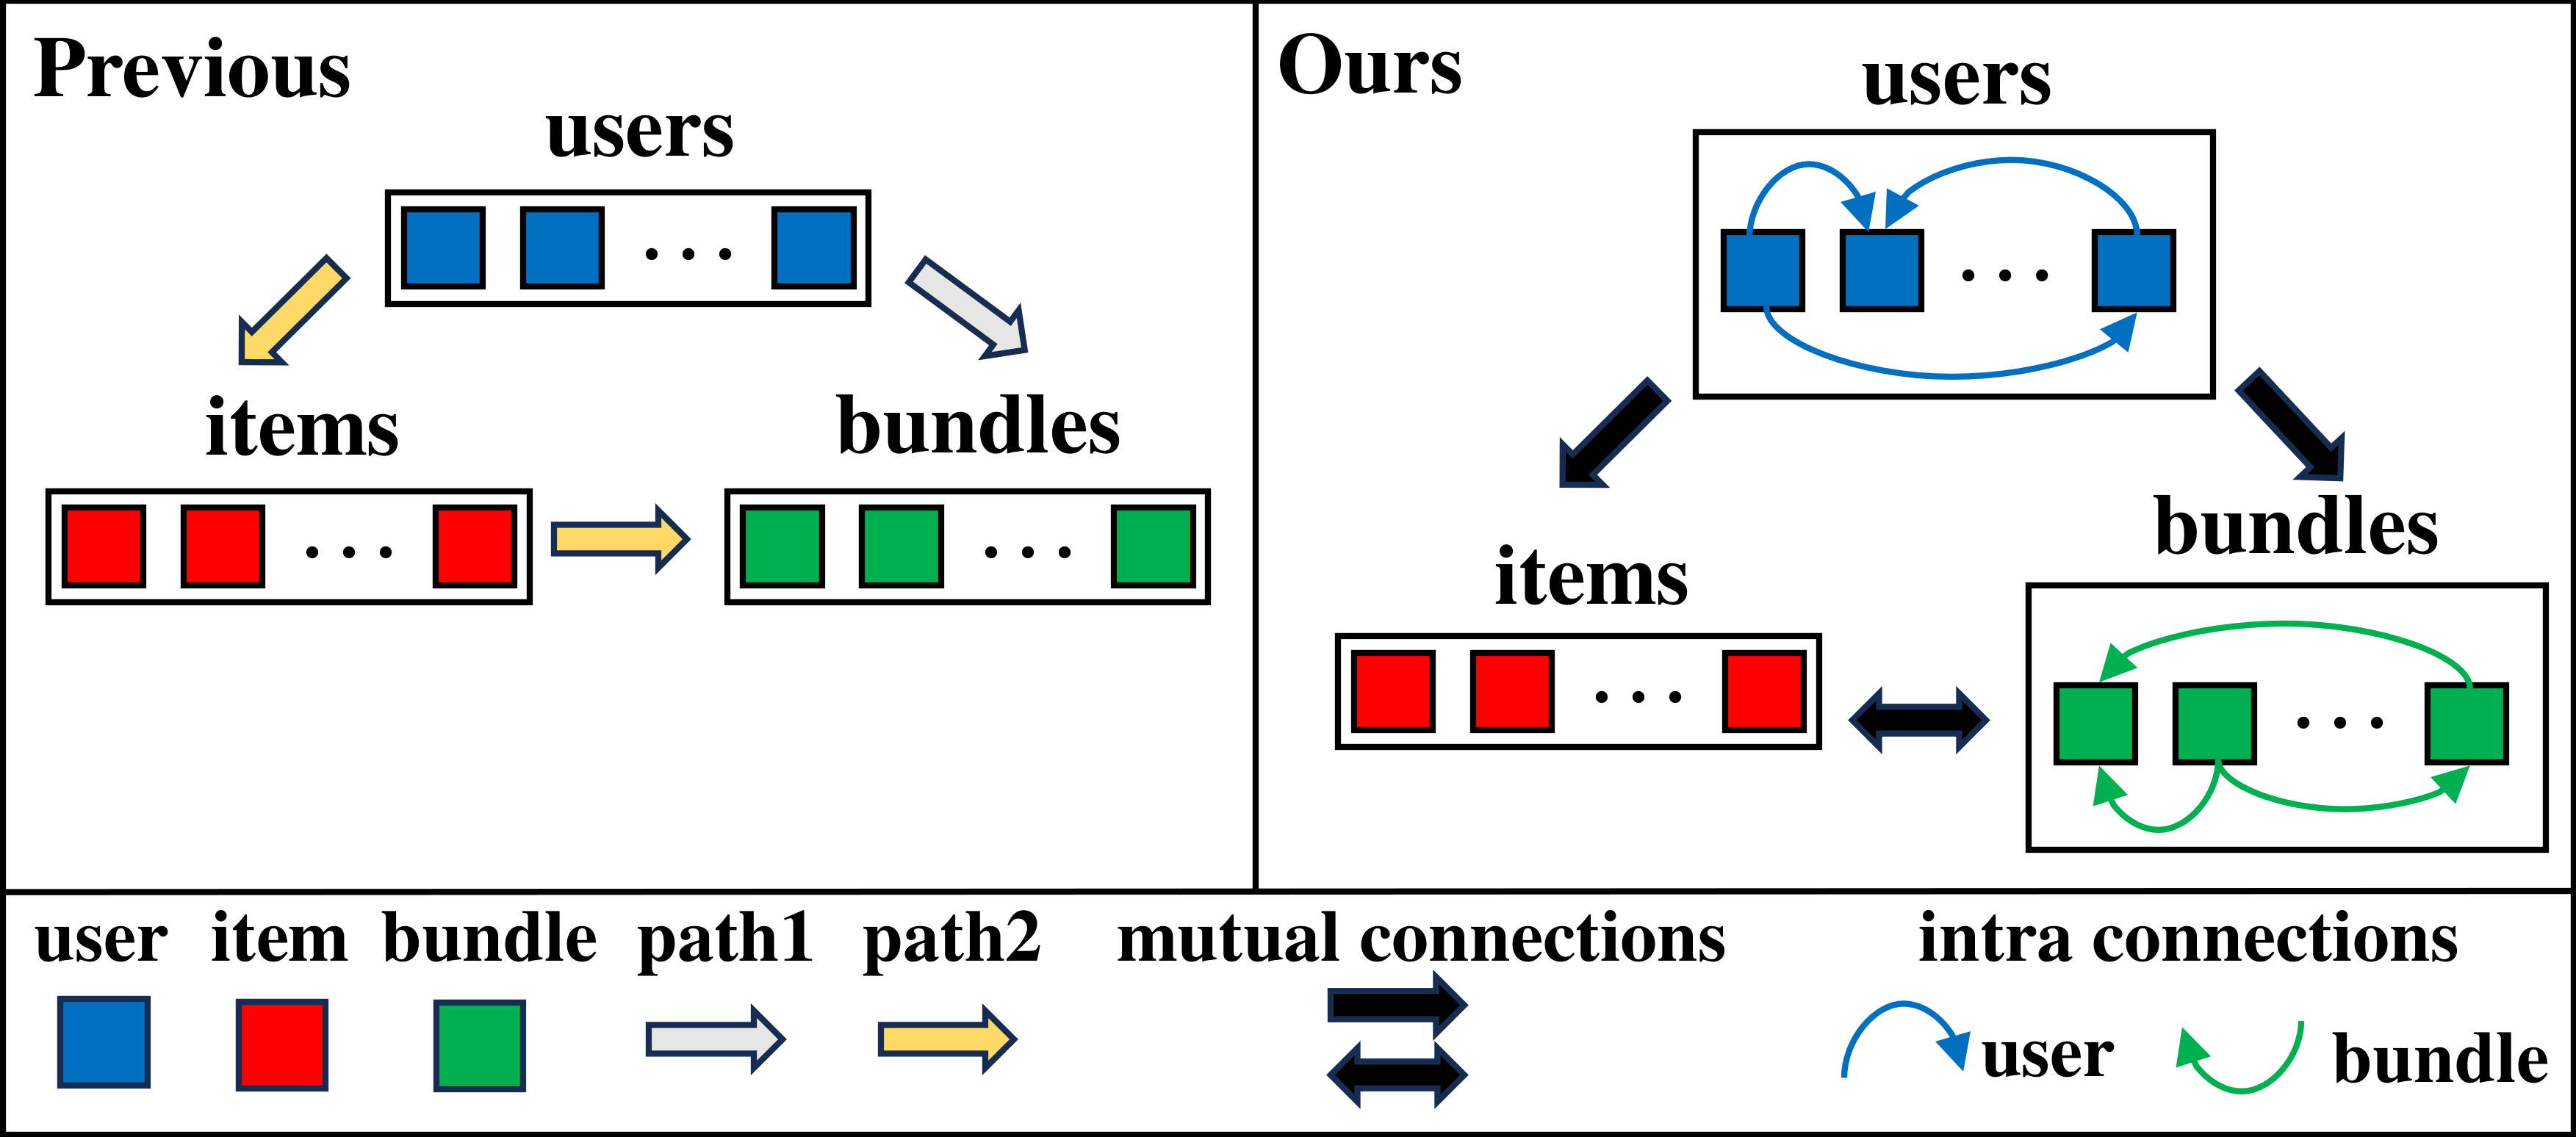
各位算法同学们,捆绑推荐里那个老毛病又被人拿出来治了:物品信息要传到捆绑分数上,中间得绕好几跳,绕完信号也淡了。这篇干脆把 user–bundle、user–item、bundle–item 三类关系全塞进一张超图,NetEase 上六个指标一起涨 5%~7%。
📄 Hypergraph-Enhanced Dual Convolutional Network for Bundle Recommendation
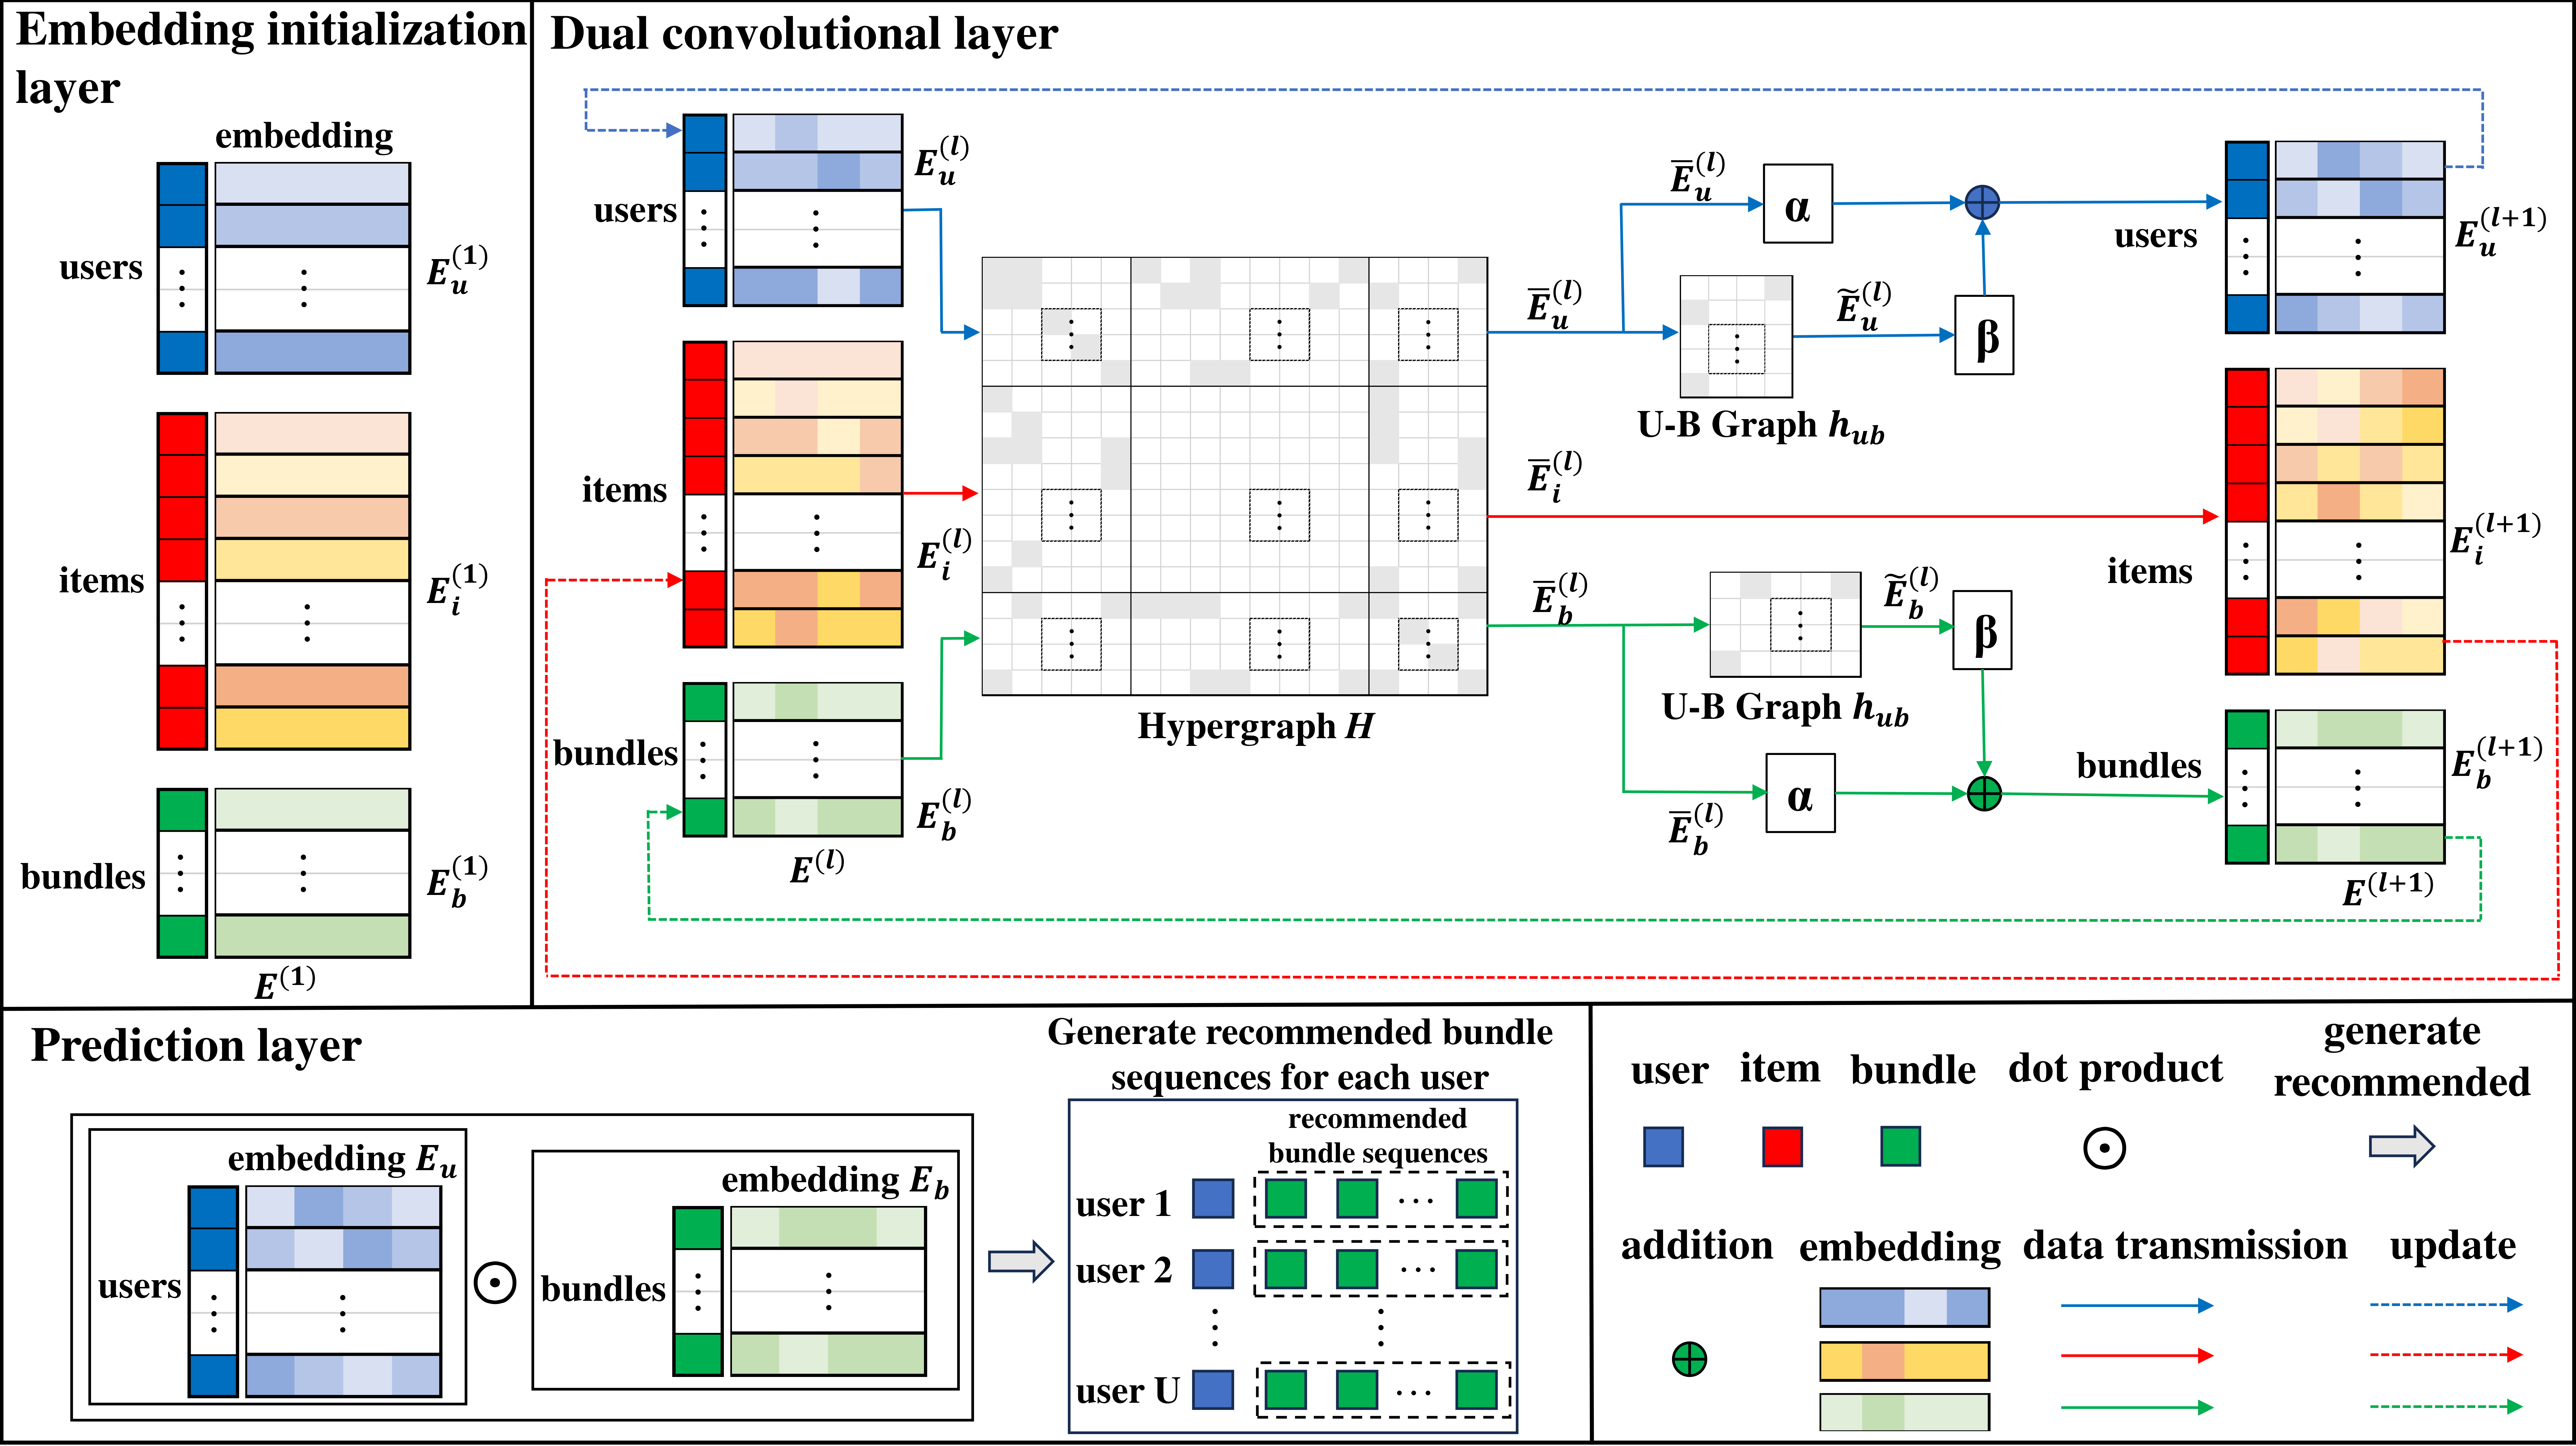
🔧 构造了一张“完整超图”:三类交叉关系全部保留,另外补上 intra-user 和 intra-bundle 的同类型关系,靠共享邻居计数加阈值 n 筛出来。注意“complete”指的是覆盖指定关系类型,不是 all-to-all 全连接。
🧩 双通道传播:一条在完整超图上传播带物品的高阶上下文,另一条只在 user–bundle 图上传播以保住排序信号,最后按 α、β 加权相加而不是拼接,维度不变、不额外增参。item 表征只走第一条通道。
⚙️ 卷积本身没有特征变换和非线性,逐层聚合照搬 LightGCN 的加权方式,损失用 UIB。所以新意不在卷积算子,在关系怎么建、两条通道怎么耦合。
📊 NetEase 上 HED-128 比最强 baseline 在六个指标上提升 5.04%–6.97%;Youshu 上 HED-64 提升 1.87%–4.56%。
📈 这六个指标是 Recall 和 NDCG 各三个 cutoff,不是单点挑出来的好看数。
✅ 消融显示 user–bundle 分支和 intra-type 关系都有贡献,超参灵敏度分析给出了稳定区间。
⚠️ 论文自己把完整超图的内存和计算代价摊开写了,这点比很多同类工作实在。
判断一下:如果你做的是游戏、音乐这种打包售卖场景,而且三张交互矩阵都拿得到,这套关系构造可以照着搭;但共享邻居阈值 n 是数据集特定的,原始计数天然偏向活跃用户和热门 bundle,换数据得重调。上手前先量一下内存峰值,超图随实体数膨胀,这一关往往比精度更早卡住你。