推荐算法日报 · 2026-10-13
总览
今天这三篇数量不多但挺对味,基本都压在「生成式检索与推荐怎么做得更可控、更可评」这条主线上。一篇是快手那边把可控条件塞进检索模型的工业向工作,另一篇干脆把语义 ID 空间从头到尾系统性地拆了一遍,这两篇凑一块儿看,恰好是「落地」和「刨根」两种视角的对照。第三篇走的是另一条路,盯着用户意图模糊时推荐系统该怎么调度工具,做成了一个 benchmark,属于给 agent 化推荐补评测基建的活。要说最值得细读的,我个人投语义 ID 那篇一票,因为它给的更可能是能复用的结论而不是单点涨点,对做生成式召回的人直接有用;CRM 那篇则适合想抄落地思路的同学,重点看它在条件可控上是怎么做文章的。RecToolBench 偏框架型,如果你不做 LLM agent 方向的推荐,读个摘要知道有这么个评测就够了。今天就优先看语义 ID 那篇和 CRM,前者给方法论,后者给工程感觉。
论文列表
1. CRM: Retrieval Model with Controllable Condition
- 论文链接:AlphaXiv
- 更新时间:2026-10-09 08:54 UTC
- 机构:Kuaishou Technology,Unaffiliated
- 工业优先级:未标注
- 备注:4 pages. Revised version with improved presentation
快手把观看时长塞进召回塔了🎯
各位算法同学们,快手在召回阶段加了一个”期望观看时长”当输入,主站视频观看时长涨了0.372%,服务4亿用户——召回模型也能被”点菜”了。
📄 CRM: Retrieval Model with Controllable Condition
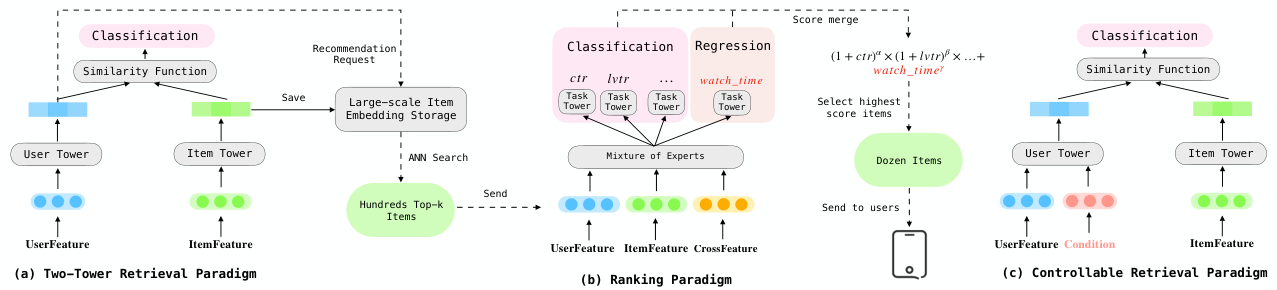
🔧 观看时长进用户塔:训练喂目标视频的真实时长,推理喂一个期望时长,不用重训就能调目标。物品塔完全不依赖条件,item embedding照旧预计算加ANN检索,这是它能上线的前提。
🧩 Transformer版借了Decision Transformer的结构,把watch-time-to-go条件token和item token交错成序列,目标时长相当于一个数值prompt,直接预测下一个item;DNN版就是用户塔多一列特征,线上跑的是Transformer版。
⚙️ 线上serving用时分复用:从最近32条历史里按概率p取最大值当条件,其余取平均值。因为平均条件涨播放和互动但总时长几乎不动,最大条件涨时长却容易推长视频、掉播放和互动。
📊 主站视频观看时长+0.372%,极速版+0.457%;总使用时长分别+0.175%和+0.196%。
📈 极速版播放量+0.324%、关注+0.828%、评论+0.697%,主站关注+0.447%。
✅ 和Swing、ComiRec、DimeRec、LTR、TDM、KuaiFormer六个召回方法在同场景比,CRM平均单次观看时长42秒,是这批里最高的。规模是4亿用户、每天50亿条日志。
想做多目标召回、把时长这类连续目标直接塞进召回的,这篇”条件进用户塔、物品塔不动”的结构可以直接抄,工程上不用重建索引。坑有两个:时长和互动在max条件下互相拉扯,p和窗口n都是线上调出来的超参,换场景要重调;条件只做了max/avg二选一,按请求个性化选条件还留在future work,这是目前最粗的一环。跟的话就盯总时长和播放量会不会一起掉。
2. RecToolBench: Benchmarking Recommendation-Specific Tool Orchestration under Fuzzy User Intent
- 论文链接:AlphaXiv
- 更新时间:2026-10-08 12:01 UTC
- 机构:未披露机构
- 工业优先级:未标注
- 备注:EMNLP Findings 2026
工具调用成功,推荐就对吗?🤔
各位算法同学们,先抛个反常识结论:工具调用的语法全对,最后推出来的东西照样可能是错的。这篇工作把”模糊意图下的工具编排”单独拎出来做成了 benchmark,戳的正是现在 agentic recommender 评测偏乐观的那块——老榜单要么假设用户把需求说得很清楚,要么只测单次函数调用。
📄 RecToolBench: Benchmarking Recommendation-Specific Tool Orchestration under Fuzzy User Intent
🔧 基于 MCP 搭了 13 个 server、32 个工具,覆盖商品、餐饮、位置三个场景,能力包括检索、评论情感、评分过滤、排序、地理推理、网页搜索,调用 schema 统一,换模型能直接跑。
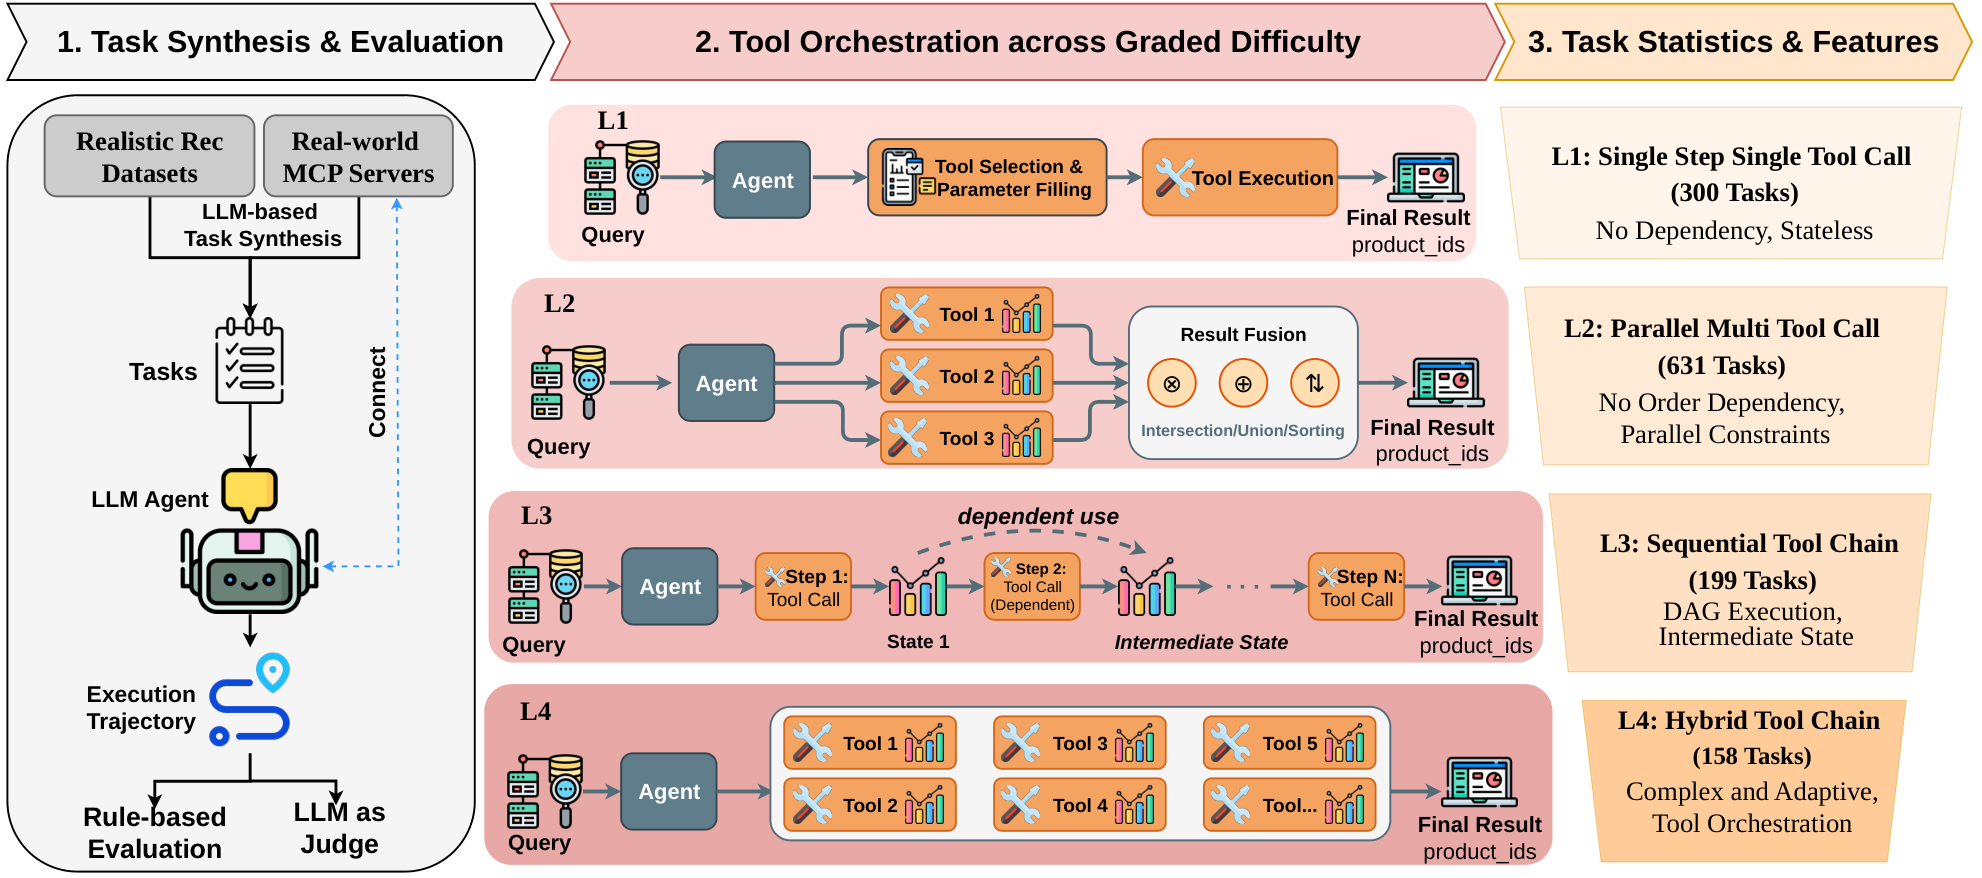
🧩 任务按四级难度递进:L1 单工具、L2 并行多工具、L3 串行依赖链、L4 混合编排,重点考中间状态能不能跨步骤传递。
⚙️ 构造走 synthesize–fuzzify–judge 流水线:先生成明确意图的任务,再按欠指定、软矛盾、模糊量化词、偏好不确定、隐式约束五类方式抹掉工具名和步骤提示,最后过滤可解性与歧义合理性;评测同时用规则检查执行正确性和 LLM rubric 打 grounding 分。
📊 1288 个任务:L1 300、L2 631、L3 199、L4 158,分布为 Amazon 675、Yelp 465、Foursquare 148。
📈 L1 上小模型调用格式合法,但工具选错、参数填错。
✅ L2、L3 里 schema 合规率依然很高,参数落地、并行拆解、依赖追踪却明显跟不上。
🧠 L4 反差最大:规则分不低,Hit Ratio 和 grounding 分数掉得厉害,执行成功和推荐正确之间有一条稳定的沟。
总结:如果你在做 agentic 推荐或工具调用评测,这个集子比通用 tool-use 榜单更贴推荐场景,适合当回归测试集用。坑在于模糊化和 rubric 打分都留了主观空间,任务分布也不均衡。实际用的时候盯三个指标就行——参数落地准确率、串行链路里的中间状态传递、最终 Hit Ratio,别被”调用成功”这个数字骗过去。
3. A Systematic Study of Semantic ID Spaces for Generative Information Retrieval
- 论文链接:AlphaXiv
- 更新时间:2026-10-06 17:33 UTC
- 机构:Artefact Research Center,LERIA, Angers University
- 工业优先级:未标注
- 备注:8 pages, 3 figures, 1 table
DocID设计空间被系统性拆了一遍
各位算法同学们,生成式检索里能不能把对的文档召回回来,很多时候在你训练之前就被DocID的构造方式定死了,但大多数工作只固定一种量化方法加一组超参就直接开跑。
📄 A Systematic Study of Semantic ID Spaces for Generative Information Retrieval
🔧 把PQ和RQ塞进同一个参数化框架:先把文档向量切成C个子空间,每个子空间内部再做L步残差量化,DocID长度M=C×L。C=1退化成RQ,L=1退化成PQ,中间C、L都大于1的那块就是新的混合PQ×RQ,也是之前没被系统扫过的区域。
🧩 混合方案给了两种码本训练方式:PQ×R-KMeans逐层在残差上跑k-means,PQ×R-VQ端到端按重建损失学。作者特意跟OneSearch划清界限——后者只在全局RQ的最后一层残差上做PQ,这里是从头就把向量切成C路并行层级再各自做深度。
⚙️ 还定义了一套免训练的内在指标:唯一率U(不同文档撞同一个DocID会机械地压住召回上限)、归一化熵H(看码字用得均不均、有没有塌缩)、共享语义相似度S、对比对齐保持率A(采1000个有效三元组,看离散DocID的远近和连续向量相似度的排序一致到什么程度)。
📊 MS MARCO 300K上跑了60组配置,NQ320K上48组,把编码方式、码本大小V、DocID长度M、码本训练方式的影响分别拆开看。
📈 之前的工作基本固定单一量化方法和固定的V、M,平行(PQ)和残差(RQ)被当成两个互不相干的阵营,混合配置没被成规模地扫过,这篇补的就是这块空白。
✅ 这组指标的价值在训练前:先诊断DocID空间的结构可用性,而不是每次都训完一个生成模型再靠下游效果反推。
总结:正在做GIR、准备挑DocID编码方案的同学可以直接拿来当筛子。我会先看U有没有因为重复文本撞到上限,再看H有没有塌缩到少数几个码字,然后把S、A和下游Recall放一起看排序是否一致——不一致就说明这套代理指标在你的语料上不成立,别硬套。两个坑:一是摘要和正文里没给出下游检索的绝对数字,想抄具体配置还得翻全文;二是这些指标都是相对比较用的,没有绝对阈值。