推荐算法日报 · 2026-10-12
总览
今天这八篇工业界占了绝大多数,整体是「落地味」很重的一批,没什么新范式,但工程细节的密度相当高。主线大概三条:生成式召回和 agent 往系统层砸、把业务终极目标(成交、转化)直接写进训练目标、以及 LLM 在离线评估这类脏活上的用法。最值得细读的是 AMap 那篇首页 agent 规划,SC-DPO 处理「合法但非最优」负样本的方式、以及把压缩课程进度绑到学习率切换点上,是少见的真能上线的设计;Google 把约束前缀树拍平成 CSR 做全向量化解码那篇同样值得系统同学花时间,它是今天唯一把代价讲到毫秒级的。Airbnb 用 search log 和 booking log 回溯 join 造样本、把 filter 排序从点击拉到 uncanceled booking 这件事,思路比方法本身更值钱,消融也老实交代了只排 P(F|Q) 会掉点。那篇拆「漏召目标到底该不该补」的受控分析建议当方法论读,它点破了 append 和不 append 的对比本来就不干净,只是自己的结论也大量跨零;剩下的 LoopFM、LIME、H2CE 和沃尔玛的页面布局都是扎实的工程活,但增益强依赖具体场景。最后提醒一句,今天几乎全是离线实验加相对 lift,0.28%、1% 这种量级别当全站收益看——优先看 AMap 和 Airbnb,系统方向加看 Google 那篇。
论文列表
1. Generative Spatiotemporal Intent Sequence Recommendation via Implicit Reasoning in Amap
- 论文链接:AlphaXiv
- 更新时间:2026-10-08 06:19 UTC
- 机构:AMAP, Alibaba Group
- 工业优先级:强
- 备注:9 pages, 1 figure
高德把大模型推理塞进小模型🔧
各位算法同学们,把 CoT 蒸馏进小模型,难点从来不是压得够小,而是压完之后它还愿不愿意按场景改计划。高德这篇 GPlan 做的是地图首页的生成式时空意图序列推荐,目标不是猜下一个 POI,而是直接生成一串能落地的意图,比如打车、酒店签到、附近吃饭。
📄 Generative Spatiotemporal Intent Sequence Recommendation via Implicit Reasoning in Amap
🧩 PICD 渐进式隐式 CoT 蒸馏:把老师的显式推理按 context、strategy、step 三级逐步换成位置特定的 latent token 三元组,学生只吐隐式 think token 再接意图序列,省掉长推理文本的解码开销。
🔧 顺手配了个 CALR 压缩感知学习率,学习率切换跟着压缩课程的状态走,而不是按固定步数拍脑袋。
⚙️ SC-DPO 时空反事实对齐:对时间或地点做最小扰动,构造双向偏好对,用带参考锚点的 DPO 让模型做到上下文一变计划就得变,同时别把 SFT 学到的规划能力带崩。
📊 数据侧:1000 条专家校准的意图、环境、逻辑种子三元组,再用 Qwen3-235B-A22B 做 few-shot 合成,过格式、schema、逻辑不变量三层过滤。
📈 论文给的对照例子:跨城旅客 15:00 落地后,GPlan 的 5 步意图在锚定去酒店之后,把后续 POI 重新基准到酒店区域;listwise baseline 还在按机场位置打分,退化成通用卡片。
✅ 离线和线上 A/B 都报告了序列连贯性、上下文响应性的提升,但摘要没给具体幅度,复现时得盯论文表格里的指标定义和 baseline 设置,别只看结论句。
总结感想:这个方向是对的,工业推荐要的不是会思考,而是思考完还能在延迟预算内交付。要留意的坑有两个,latent token 的可解释性和线上监控怎么做,以及反事实扰动造得对不对,弱了学不到、强了会把偏好学偏。如果你的场景也是多步意图串行触发,这篇的蒸馏课程和偏好构造值得拆开看;只想提升单点 CTR 的话,收益可能不在这个层面。
2. Recommending Search Filters To Improve Conversions At Airbnb
- 论文链接:AlphaXiv
- 更新时间:2026-10-05 00:02 UTC
- 机构:Airbnb, Inc.
- 工业优先级:强
- 备注:Accepted at the KDD 2026 Workshop on Two-sided Marketplace Optimization: Search, Discovery, Matching, Pricing & Growth (TSMO)
🔍Airbnb不推房源,改推搜索过滤器
各位算法同学们,Airbnb这套系统推荐的不是房源,是搜索过滤器——而且它想证明推荐过滤器本身就能把下单转化拉起来。facet ranking的老工作基本都在优化导航便利或者filter点击率,这篇直接把目标定在最终booking上,思路拐了个弯。
📄 Recommending Search Filters To Improve Conversions At Airbnb
🔧 目标换成转化:不优化上层engagement,直接瞄准lower-funnel的未取消订单,把搜索过滤器当“中间工具”来推荐,而不是推荐最终item。
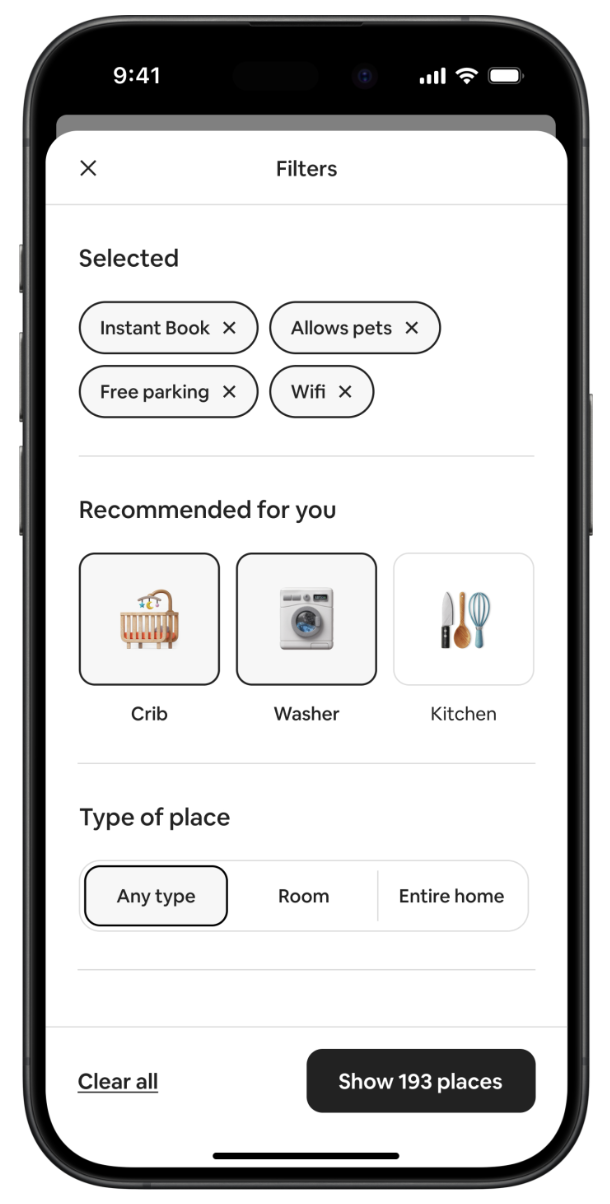
🧩 训练样本靠booking回溯归因:从一次成交倒推之前的若干次搜索,某次搜索用到的filter结果里包含最终被订的房源就标正样本,把被订房源过滤掉就标负样本,监督信号天然和转化对齐。
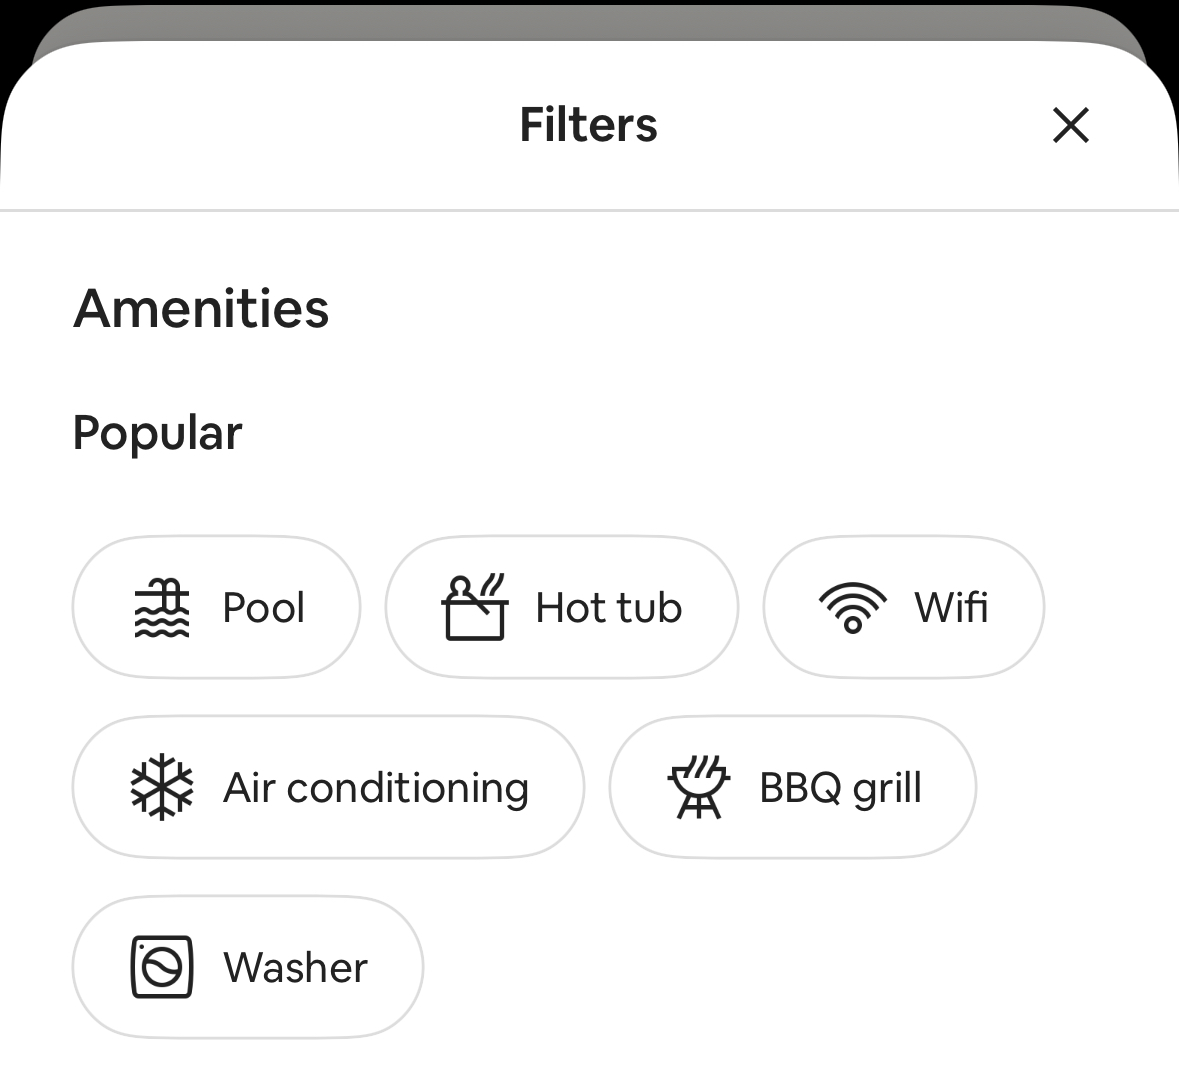
⚙️ 一套能落地的系统:从0到1的冷启动bootstrap策略,加上扛得住线上延迟的可扩展架构,已经跑到Airbnb多个界面上,包括filter面板推荐区、amenities区和filter bar。
📊 论文定义了Filter Conversion Rate,即“应用该filter且发生转化的搜索数÷应用该filter的搜索数”,数据显示FCR在filter之间和query之间差得很开:长住query(≥28晚)下面是dedicated workspace、washer、wifi,团组出行则是free parking、hot tub、barbeque area。
📈 线上A/B测试拿到的是增量booking转化提升,而不是只动filter点击率。
✅ 消融实验逐项验证了这套框架和几个关键设计选择确实在起作用。
我的判断:这个“推荐中间工具”的设定,对做电商和双边市场筛选项/facet的同学可迁移性挺高,要盯的是FCR和带filter的最终转化,别只看filter CTR。坑有两个:正负样本全靠booking回溯归因,归因窗口以及“成交算给哪次搜索”的设计一变,标签就跟着变;冷启动阶段FCR方差大,数据不够容易估歪。另外它是拿转化换导航类指标,线上filter点击率不一定涨,拿这个当对照容易误判。
3. LoopFM: Learning frOm HistOrical RePresentations of Foundation Model for Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-10-07 03:55 UTC
- 机构:未披露机构
- 工业优先级:强
- 备注:Hua Zheng, Shali Jiang, Boyang Liu contributed equally to this work
知识蒸馏传标量不够?FM改传序列
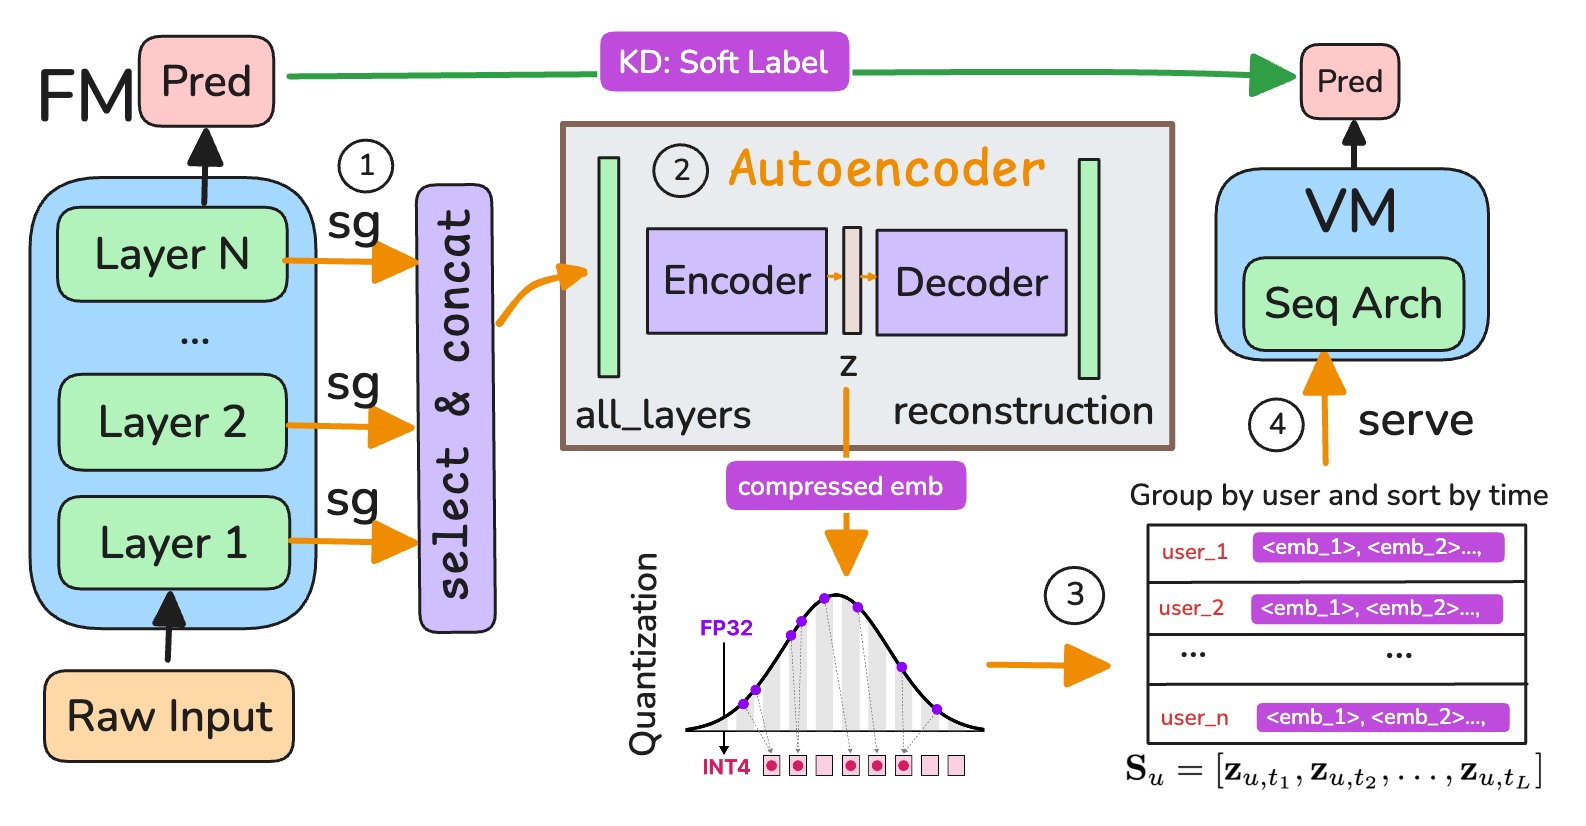
各位算法同学们,把一个万亿参数的 FM 压成一个标量 soft label 去带 VM,这条路在参数量差到三个数量级时已经不太够用了:teacher 越强,能被那个数字带过去的比例反而越低。这篇想干的事就是给蒸馏换一条带宽更宽的通道。
📄 LoopFM: Learning frOm HistOrical RePresentations of Foundation Model for Recommendation
🔧 不走辅助 loss 去对齐当前样本的隐层,而是把 FM 的中间 embedding 离线抽出来、压缩、按 key(论文里是 user)分组成历史序列,直接当 VM 的输入特征。推理时不用实时跑 FM,也不要求和 FM 做架构耦合。
🧩 压缩是和 FM 一起训的自编码器,输出接 tanh 后做 INT4 量化,存储比 FP16 省 4 倍;还用 Matryoshka 式训练,任意前缀维度都算有效表示,部署时能按维度调效果和成本的平衡。
⚙️ 理论上把增益拆成三项:用户历史时序信息 + FM 跨特征带来的信息 − 压缩损失。transfer ratio 的下界随 FM 与 VM 的特征差变大而升高,压缩越好下界越紧,另外序列变长信息增益不下降。
📊 三个公开集:TaobaoAd 平均 +6.4% AUC(区间 +6.1~6.6%),KuaiVideo 平均 +1.0%,Amazon 平均 +0.5%。
📈 工业规模(十亿级样本、万亿参数 FM)上,在已有 KD 之上把知识迁移率大约翻倍。
✅ 线上转化:首次上线前半段 +0.5%,后半段两次独立上线分别 +1.03% 和 +1.22%。
🧭 序列长度、embedding 维度、上游 FM 规模上都出现了 scaling law,维度那一条的前提是下游 encoder 容量够。
我的判断:这套东西和 KD 是互补关系,不是替代,而且它把收益来源解释得比我见过的多数蒸馏工作清楚。坑也明显——离线抽取、存储、序列编码都带额外工程和延迟开销,embedding 维度加太猛但下游 encoder 撑不住就是白白烧存储。如果你在做两阶段推荐、teacher 已经大到 KD 收益越来越薄,建议盯两个指标:transfer ratio 有没有真的抬起来,以及压缩后相比原始 embedding 的 AUC 掉了多少;只报前者不报后者就得留个心眼。
4. LIME: Link-based User-item Interaction Modeling with Decoupled XOR Attention for Efficient Test Time Scaling
- 论文链接:AlphaXiv
- 更新时间:2026-10-08 17:45 UTC
- 机构:未披露机构
- 工业优先级:强
- 备注:NeurIPS 2026
候选集涨10倍,推理延迟几乎不动
各位算法同学们,候选集从几万涨到几十万,线上打分延迟几乎没怎么动——这篇把推荐推理成本从「跟候选数线性挂钩」里拆了出来。它正面碰的是那个老三角:长用户历史、大候选集、深度交叉,过去只能三选二。
📄 LIME: Link-based User-item Interaction Modeling with Decoupled XOR Attention for Efficient Test Time Scaling
🔧 低秩 link embedding 当中间桥:在用户历史和候选之间插一组固定大小的可学 link token,把一次完整 cross-attention 拆成用户侧个性化和候选侧交互两步,复杂度从 O(M·N) 降到 O(ℓ(M+N))。
🧩 真正省算力的是候选侧注意力权重 ϕ(TLᵀ) 只依赖候选和全局 link,与用户无关,可以对全库离线预计算并缓存;线上从矩阵乘变成查表加一次加权求和,单候选延迟基本不随用户历史长度走。
⚙️ LIME-XOR 把完整自注意力矩阵分解成 link 与用户序列之间的双向线性注意力,历史长度方向从 O(N²) 降到 O(N)。顺带一提,它和 Set Transformer 那类置换不变的摘要不是一回事,目标是保留序列性的目标感知排序表示。
📊 公开集与工业集上,性能接近 SOTA transformer(HSTU 一档),候选集大或序列长时推理快 10×。
📈 Figure 1 中 LIME-MHA 的延迟在候选数、用户历史长度、QK 维度三个维度上都最低也最平,曲线基本不抬头。
✅ 线上部署在服务数十亿用户的推荐平台,source rate 最高提升 38%,推理成本对候选集规模和历史长度都不敏感。
我的判断:做大规模排序、候选集和历史长度同时往上顶的团队,可以认真看这套结构,它给的是不砍表达的省算力路线。盯两个指标就够:延迟曲线是否真的对候选数平坦,以及 AUC/GAUC 相对全 cross-attention 的差距能不能接受。两个坑先说在前面:link token 数 ℓ 是关键超参,压太小表达力先掉;另外全库预计算权重的缓存一致性和更新延迟要在工程上想清楚,离线注意力和线上用户特征对不齐会很坑。
5. Language Models for Page-Level Layout Decisions in E-commerce Search
- 论文链接:AlphaXiv
- 更新时间:2026-10-07 21:19 UTC
- 机构:Walmart Global Tech,University of Illinois at Urbana-Champaign
- 工业优先级:中
- 备注:Accepted at the OARS Workshop, ACM RecSys 2026
LLM评页面布局,打不过浅层模型🤔
各位算法同学们,如果我说“让7B大模型当裁判,判断搜索页这个位置要不要塞一个横向carousel,结果输给了一个拿embedding喂浅层分类器的做法”,你信吗?这篇来自Walmart Global Tech和UIUC的工作,第一次把“页面级布局决策”的离线评估做成了统一对比基准,结论跟当下LLM-as-judge的热度有点反着来。
📄 Language Models for Page-Level Layout Decisions in E-commerce Search
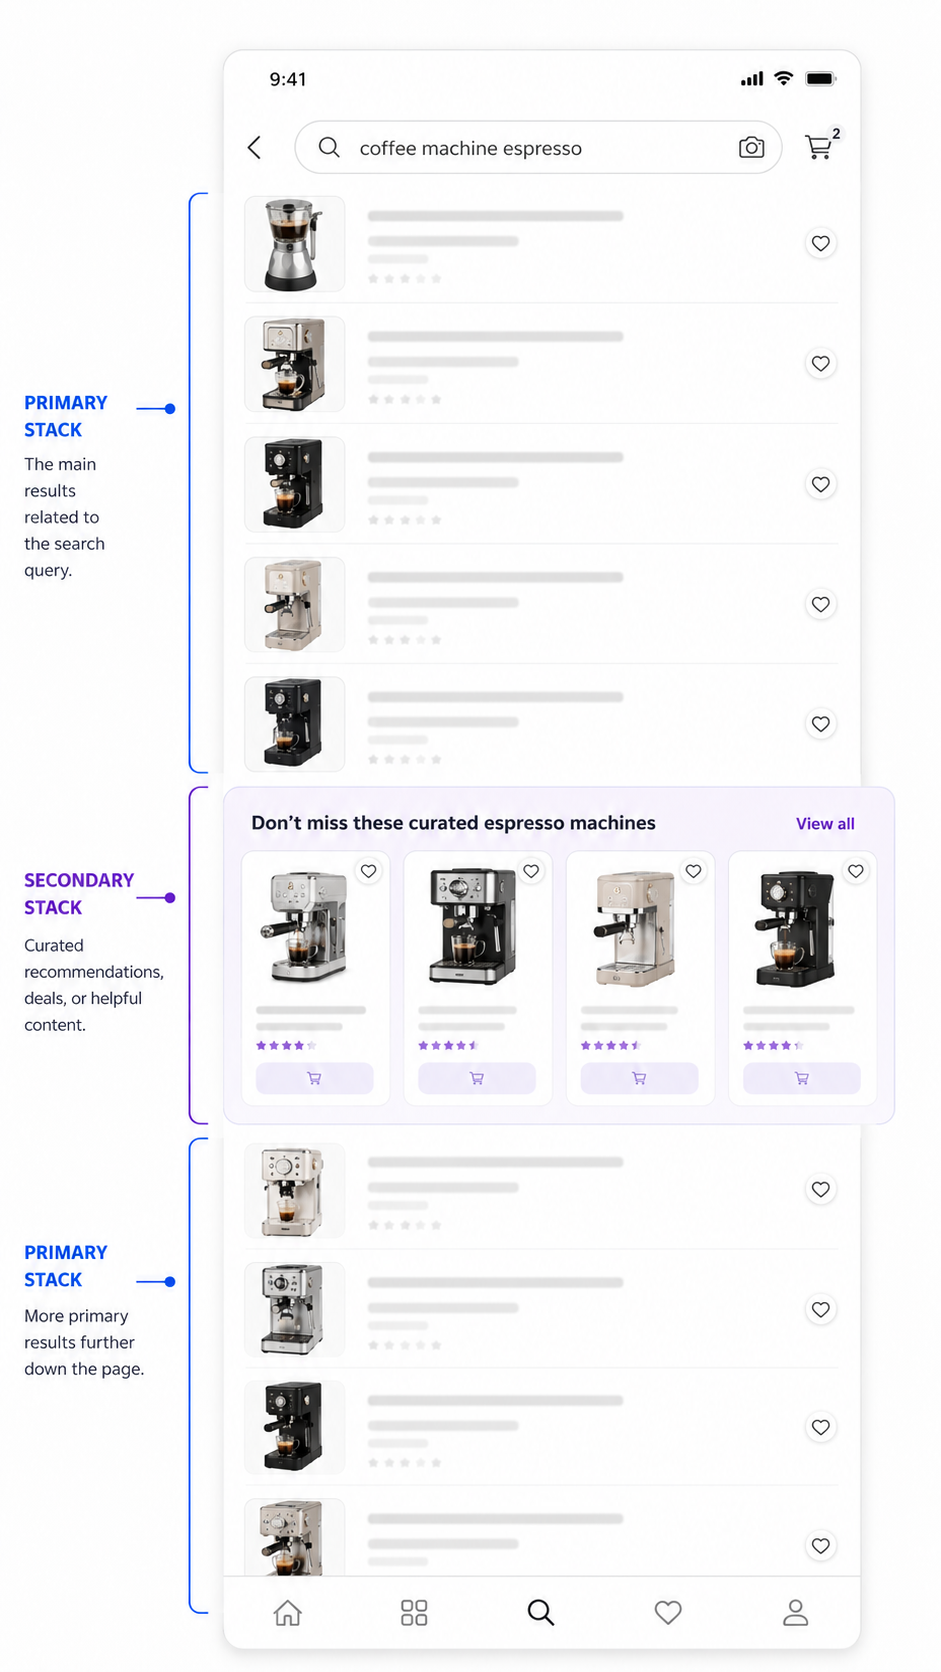
🔧 把“布局决策”形式化成二分类:给定query、主结果列表P、候选secondary stack S和插入位置i,模型只回答“加S更好(1)”还是“不加更好(0)”,监督信号直接取历史日志里的Add-to-Cart,绕开了传统排序评估里interleaving那套成熟工具的缺失。
🧩 标签构造挺讲究:假设用户自上而下滚动,所以只看stack位置及以下主结果的ATC;用户既没点stack、下方主结果也没加购的会话直接丢弃,因为无法确认他真的滑过了这个模块,这样正负样本都对应“确实见过stack”的会话。
⚙️ 三类方法同一套标签、同一数据划分硬碰硬:Mistral-7B-Instruct直接prompt判分、prompt派生特征喂轻量分类器、ModernBERT编码页面上下文再挂浅层预测。其中PDJ变体还把判断拆成6条判据(意图对齐、商品相关性、品牌热度、价值对齐、与主结果重复、打断成本),每条3分制打分,想模仿思维链的效果。
📊 摘要给出的核心结论:representation-based方法在预测用户engagement上一致优于prompt-based判断。
📈 同一份页面上下文,取文本编码器的表征再训个浅模型,比让LLM直接吐0/1和分数更稳——说明这类带UI约束、带滚动成本的任务,LLM的“直觉推理”不一定接得住。
✅ 但论文摘要里没给具体提升幅度,要判断能不能上生产,得回正文看指标口径、label正负比例,以及换一个engagement信号(比如点击而非ATC)结论是否还成立。
总结一下:做电商或内容平台、想改页面模块位置又不想每次都开AB的人可以看,思路是把“离线筛布局”当成有监督预测,而不是让LLM写评语。要盯的坑有两个:标签完全绑定ATC的定义,换指标大概率要重训;而且它只能帮你排掉明显差的布局,别指望替代线上AB,顶多把候选从100个压到10个。至于LLM-as-judge,至少在这个任务上,暂时不是最优解。
6. Training with Missed Targets in Generative Recommendation: Separating Supervision from Probability Competition
- 论文链接:AlphaXiv
- 更新时间:2026-10-07 14:07 UTC
- 机构:Independent Researcher,Zhejiang University
- 工业优先级:中
- 备注:12 pages, 4 figures, 8 tables
补全漏掉的正样本,排序反而更差?
各位算法同学们,把生成器漏掉的正样本补进重排训练列表,居然可能把真正能上线的排序搞坏?这篇工作就是来拆这个反差的:不补浪费监督信号,补了却可能让只在训练时出现的候选跟推理候选抢概率,最后伤到的偏偏是返回项的排序。
📄 Training with Missed Targets in Generative Recommendation: Separating Supervision from Probability Competition
🔧 先把「补全」拆开:往重排训练列表追加漏掉的目标,同时改了三件事——检索命中目标的权重被稀释、多了对追加目标的监督、两组开始抢同一份概率。所以「补/不补」的消融其实说明不了任何一件事。 🧩 于是构造三个匹配损失,WN→Cond→Full,检索目标权重全程固定,一次只加一个条件。中间的 Cond 让两组各自归一化,训练才有的目标不再和推理候选竞争概率。 ⚙️ 结论指向很清楚:出问题的是跨组概率竞争,不是追加监督本身。
📊 Amazon Video Games 上四组预设对比,去掉组间竞争后 FT-NDCG 提升 7.8%–22.2%。 📈 用户维度 95% 区间全部排除 0,训练轮次维度四个里三个排除 0。 ✅ 还给了一条能落地的判断规则:一个留出类目下三个生成器里两个采纳追加训练,另一个类目下三个全部拒掉,避开了 1.7% 的损失。已发布的 OneRec 上也能看到竞争带来的返回项排序退化。
总结:做生成式召回下游重排、而且推理时候选池锁死的同学,这套拆分可以直接当消融模板用。落地别默认开补全,逐生成器在 dev set 上做一次决策,盯 FT-NDCG 这类全目标指标,别只看命中样本上变好的数。一个坑要注意:训练组里只有一个追加目标时 Cond 会退化成 WN,这时你根本测不出竞争的影响。
7. H2CE: Modeling Geo-Semantic Interactions for POI Reranking with Heterogeneous Two-Stage Cross-Encoders
- 论文链接:AlphaXiv
- 更新时间:2026-10-08 05:40 UTC
- 机构:Amazon,University of Trento
- 工业优先级:中
别急着上LLM:POI重排提22个点🔍
各位算法同学们,先说个反直觉的:在本地搜索的POI重排里,一个零样本LLM重排器被一个两阶段cross-encoder拉开了35.89个点。这篇CIKM’26论文讨论的正是”距离近但语义不太对”和”语义准但远一点”这类用标量加权解决不了的排序问题。
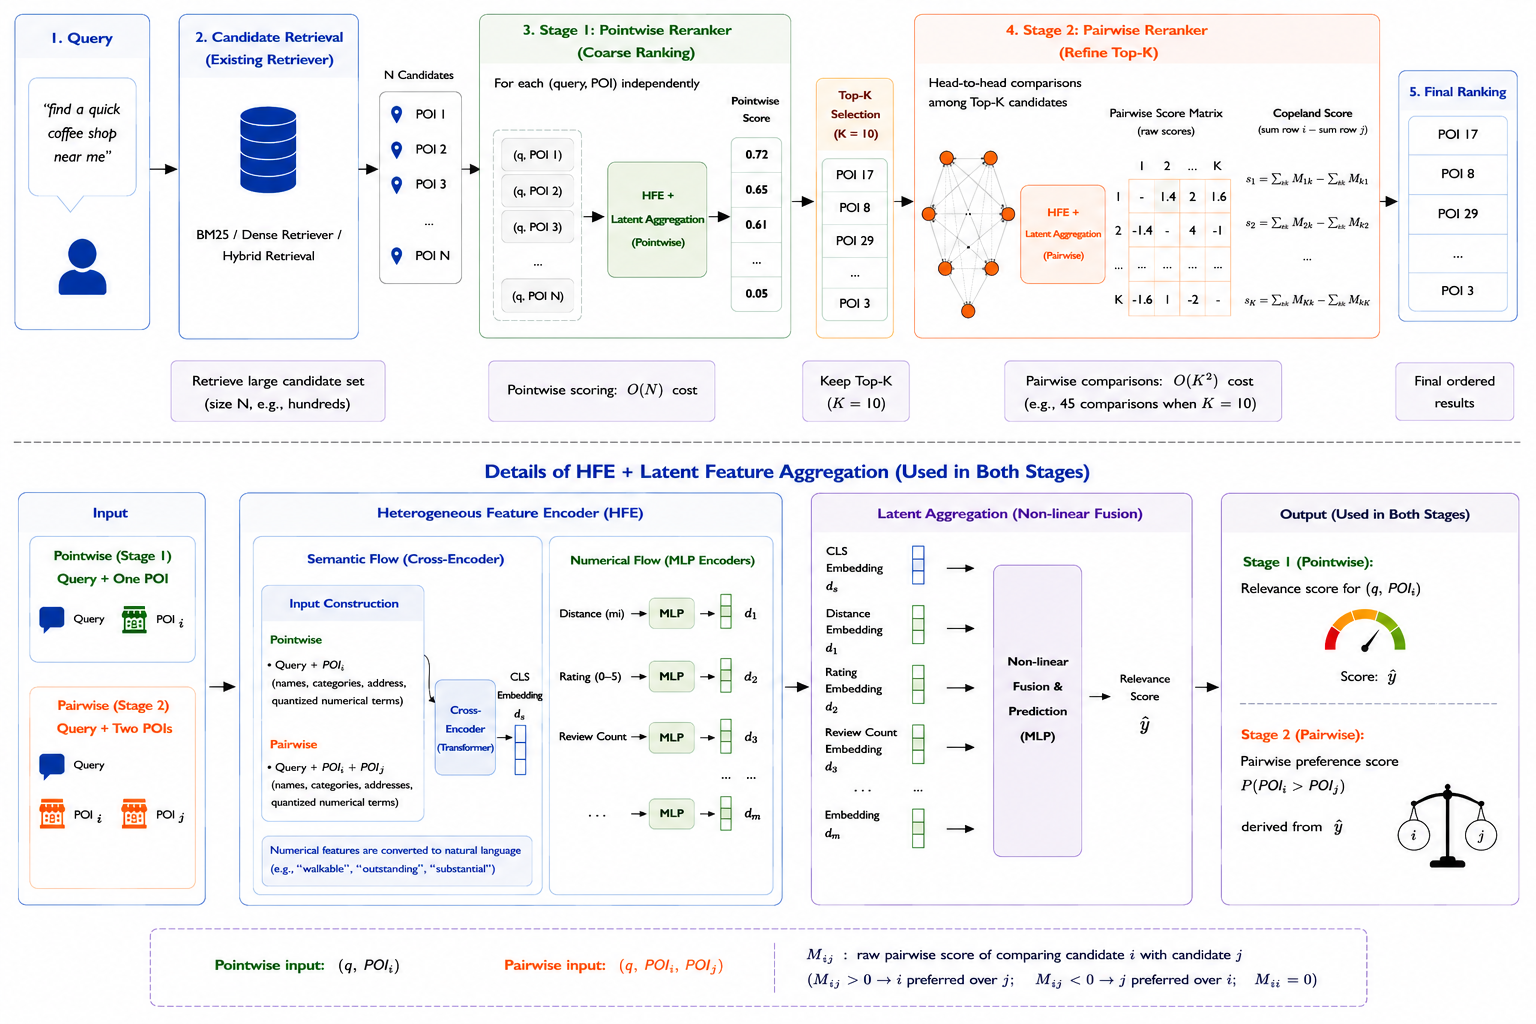
📄 H2CE: Modeling Geo-Semantic Interactions for POI Reranking with Heterogeneous Two-Stage Cross-Encoders
🔧 数值属性走两条路:分桶后的自然语言描述(walkable、near、excellent)塞进cross-encoder输入,让attention能对”近”“好吃”这类粗粒度概念做条件化匹配;精确标量交给专用MLP,保住数值大小信息不被分桶抹平。
🧩 融合不再是语义分和数值分的加权和,而是把CLS向量和数值embedding在隐空间做聚合,非线性交互因此能表达”走路距离类query距离权重大、best类query评分权重大”。
⚙️ 两阶段:Stage1对全部候选pointwise打分做粗排过滤,Stage2只对top-K做两两对比,用Copeland聚合出最终顺序,pairwise成本从O(N²)压到O(N+K(K-1)),论文里K取10。
📊 5,743条query的本地搜索测试集上,NDCG@5达到67.48%,比XGBoost LTR绝对提升+22.82%。
📈 比零样本LLM重排器RankGPT高+35.89%,比做过本地搜索微调的BGE reranker高+9.62%。
✅ RDQ@5为60.77%,比XGBoost绝对+20.96%;只看pairwise阶段,比纯pointwise版本再涨+1.98% NDCG@5。
🧪 消融覆盖数值特征、隐空间聚合、top-K pairwise和对齐训练,这几块都不是装饰。
总结一句:如果你在做本地搜索或重排、又卡在延迟预算上,这套”语义+数值双通道、top-K两两比较”的结构可以照着搭,但要盯两件事——K太小的话Stage1漏掉的好候选Stage2救不回来,分桶边界也得按自己业务的距离分布重调。另外它的基准是XGBoost和微调BGE,不是最强LLM listwise,别把结论外推太多。
8. Vectorizing the Trie: Efficient Constrained Decoding for LLM-based Generative Retrieval on Accelerators
- 论文链接:AlphaXiv
- 更新时间:2026-10-07 03:10 UTC
- 机构:Google,Yale University
- 工业优先级:未标注
- 备注:KDD 2026 camera-ready
Trie拍平成稀疏矩阵,解码快948倍
各位算法同学们,约束解码的瓶颈往往不在算法对不对,而在内存访问规不规整——把前缀树拍平成一个静态CSR稀疏矩阵,TPU上每步只多0.033ms、占推理时间0.25%,比CPU trie快948倍。做生成式推荐时被“只能推有货的、只能推新鲜的”这类业务规则卡过的人,这篇是正面解法。
📄 Vectorizing the Trie: Efficient Constrained Decoding for LLM-based Generative Retrieval on Accelerators
🔧 把前缀树压成静态CSR稀疏矩阵,树遍历变成向量化的稀疏矩阵操作,读取是coalesced的,对约束集大小的I/O复杂度是O(1),而二分查找baseline是对数级。
🧩 无分支解码:动态切片加掩码算术,约束逻辑全程留在加速器上跑,Host和Device之间不用来回通信,也让依赖静态图的XLA能编译。
⚙️ 面向SID生成检索的真实规模:2000万量级的物品约束集也扛得住;FST在这种百万级以上高基数词表上会状态爆炸,而且没有TPU原生支持。
📊 线上每步解码只增加0.033ms,约占推理时间的0.25%。
📈 相比CPU trie实现948倍加速,相比硬件加速的二分查找baseline快47到1033倍。
✅ 已部署在服务数十亿用户的视频推荐平台上,2000万新鲜视频约束集下核心业务指标有正向变化;论文称这是首个生产规模的严格约束生成式检索。
📉 Amazon Reviews评测里,把冷启动物品集作为约束,冷启动推荐效果有明显提升。
要我判断的话:如果你在做生成式推荐、又被业务过滤规则和延迟两头夹着,这套方案可以直接抄,代码已开源。真正要盯的指标是per-step延迟和约束集规模放大后的曲线,而不是只看向上的加速倍数。落地坑在于CSR索引本身的内存占用和构建成本,约束集高频变化(比如库存实时变动)时怎么增量维护,论文没展开;另外加速来自稀疏算子,约束集特别小的时候未必划算。