推荐算法日报 · 2026-10-02
总览
今天这批货的成色不错,而且信号很集中:生成式推荐已经从「能不能跑通」往「怎么真上线」迈进了一大步,工业界的味道明显压过学术味。一条主线是生成式检索/推荐的结构改良与落地——快手的挑战赛、抖音的端到端广告检索、华为那篇在语义 ID 里平衡语义与协同信号的工作,再加上分层多分辨率和残差轨迹蒸馏,基本把这条路上从表示、训练到服务的坑都覆盖了。另一条主线是「可控性」,Comcast 的服务时门控和 KAIST 那篇行为引导的稀疏路由,本质都在回答同一个问题:生成得野和推得准之间,那个开关该拧在哪儿。剩下那篇大模型推荐系统训练时间优化属于工程侧的硬货,做大规模训练的同学别跳过。真要我挑,最值得细读的是抖音那篇端到端生成式广告检索,工业级细节最实在,以及华为的 GrIS,语义 ID 怎么不把协同信号丢掉是当下最核心的争点。今天优先看这两篇,手上有线上可控性需求的再补一下 Comcast 的门控那篇。
论文列表
1. KUAISHOU Explorer LLM-Rec Challenge 2026: Reasoning Generative Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-09-30 14:28 UTC
- 机构:未披露机构
- 工业优先级:未标注
推理加进推荐,指标反而掉了?
各位算法同学们,给推荐模型加思维链,效果不一定涨——这是快手这篇挑战赛报告里反复强调的反常识结论。他们干脆把“推理式生成推荐”做成赛题,顺手把模型权重、推理 SFT 数据、评测基准全开源了。
📄 KUAISHOU Explorer LLM-Rec Challenge 2026: Reasoning Generative Recommendation
🔧 物品用 Semantic ID 表示:领域标记加三层残差量化码,每层 8192 个码字,RQ-KMeans 把多模态内容压成 LLM 词表里的特殊 token,推荐目标就是自回归吐这些码。
🧩 四类任务塞进同一个模型:理解物品、理解用户(按给定兴趣主题挑出相关历史行为并生成兴趣演化链)、跨域预测下一交互、外加世界知识选择题,考验训练后通用能力还剩多少。
⚙️ OneReason 的应对是强化 SID 与自然语言的语义对齐,用结构化模板监督兴趣推理,再叠 RL/RFT,让 CoT 真正对推荐有用,而不是模型自嗨。
📊 开源 SFT 数据 792,797 条,其中 412,438 条带 CoT 轨迹;另有 50 万匿名用户行为,覆盖短视频、电商、广告、直播四域。
📈 评测用 thinking 与 non-thinking 两种模式各跑 Pass@32 再合并算分,思路是逼 thinking 捞到非思考模式预测不出的多样兴趣物品。
✅ 榜首队伍总分 1.44,其后是 1.42、1.41、1.41、1.40,头部咬得很紧,没出现断层方案。
做 LLM 与推荐融合的同学可以盯这个赛题,重点看双模式合并后指标怎么涨、RL 阶段怎么筛 rollout 轨迹、SID 对齐做到哪一层。坑也很明确:CoT 不加约束就是拖后腿,直接套通用推理模板大概率白跑一轮。
2. Generative End-to-end Ad Retrieval at Douyin
- 论文链接:AlphaXiv
- 更新时间:2026-09-30 09:00 UTC
- 机构:未披露机构
- 工业优先级:未标注
生成式召回的两个死结,被一起解了🔧
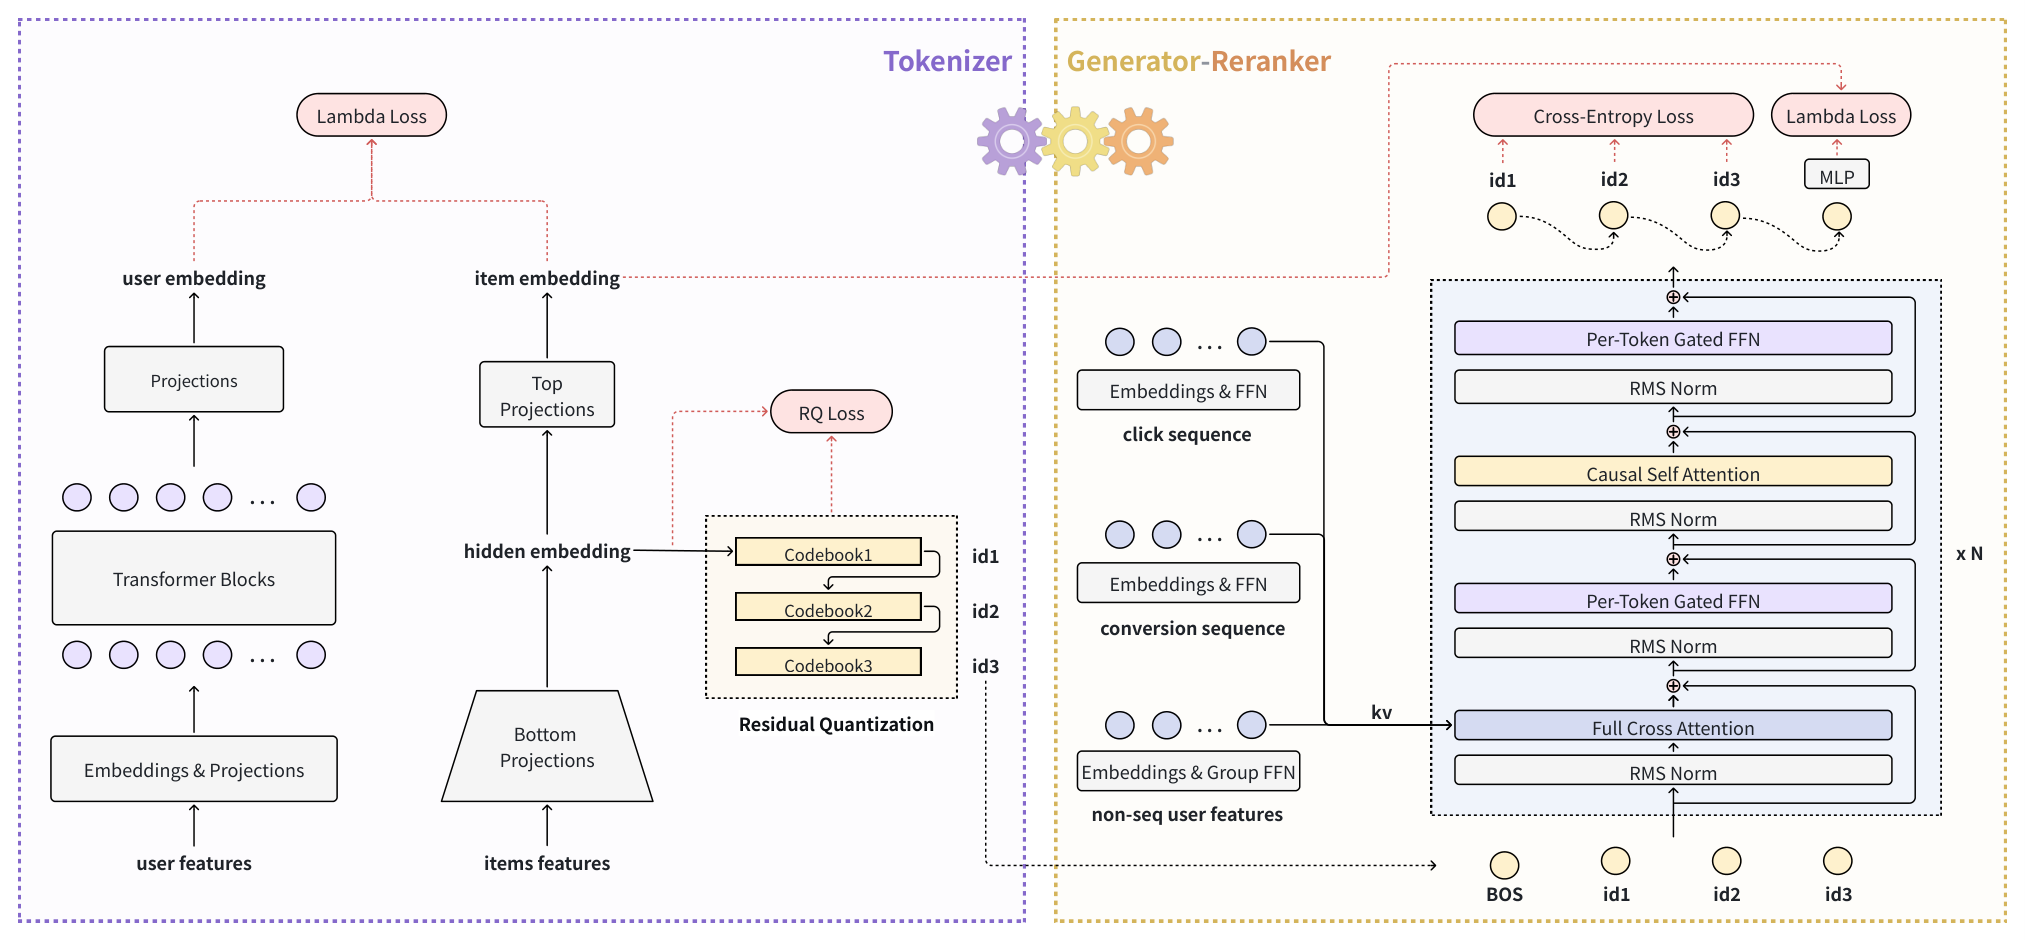
各位算法同学们,生成式召回最难受的不是模型不够大,而是码本一扩,坍缩更狠、撞码更多。抖音这篇把这两个互相拉扯的问题塞进一个端到端框架里同时解,而且已经在广告线上扛着数亿日活。
📄 Generative End-to-end Ad Retrieval at Douyin
🔧 BasisVQ:用可学习的正交基重新参数化码本,更新时等价于整个潜空间做刚性旋转。没人选中的死码也跟着一起转,不会像普通线性变换那样被拉飞、永久失活。正交基用 Newton-Schulz 迭代求,前向先按 Frobenius 范数归一,保证收敛和数值稳定。 🧩 Prefix-aware BasisRQ:在残差量化每层做前缀感知的逐元素仿射变换,用前面各层的码去查缩放和偏置。表达力上去了,渐近时间复杂度没变,比 QINCO 那类 MLP 方案轻。 ⚙️ 联合重排头:直接复用生成器的自回归隐状态,多解一步,把撞到同一 token 序列的不同 item 区分开,用 Lambda Loss 和 tokenizer、generator 一起端到端训,不用再单开一条重排链路。
📊 论文称已在抖音广告服务数亿日活用户,大规模线上 A/B 有提升,但摘要没给具体百分比,这块得翻正文或等后续版本。 📈 稳定性上,Newton-Schulz 五次迭代就够;训练额外复杂度 O(d³),跟 batch size 无关;参数只多 O(d²)。 ✅ 推理端码本可以离线预计算并缓存,作者说推理复杂度与 vanilla VQ 一致,零延迟开销。
如果你在做生成式召回、VQ 码本或端到端召回,这篇的落点比较明确:别只盯离线 Recall,要重点看码本利用率和撞码率,再对比重排头带来的线上收益能不能覆盖端到端训练的成本。最大的坑是线上分布持续漂移下的长期稳定性,论文给了收敛分析,但码本几个月后会不会再次退化,还得拿自己的流式数据验。
3. Routing Between Generative and Collaborative User Profiles: A Serving-Time Gate for Controllable Novelty
- 论文链接:AlphaXiv
- 更新时间:2026-09-30 05:53 UTC
- 机构:DePaul University / Comcast Technology AI,Comcast Technology AI
- 工业优先级:未标注
LLM画像别全量上,路由12.5%就够
各位算法同学们,LLM用户画像不是全量部署就越好。这篇在真实流媒体数据上只把12.5%的用户路由到LLM画像模型,就在5%的NDCG损失预算内把Novelty@10抬了6.5%。
📄 Routing Between Generative and Collaborative User Profiles: A Serving-Time Gate for Controllable Novelty
🔧 把“要不要用生成式画像”从离线表示问题改写成serving-time的逐用户路由:默认走协同序列模型,只有对该用户预期划算时才切到profile模型。
🧩 gate只用serving时能拿到的特征——历史长度及其对数、已消费物品的均值与中位流行度、小众内容占比、协同和语义表示的范数;训练标签是ΔNovelty>0且ΔNDCG≥0,用GBDT做二分类。
⚙️ 阈值τ可以扫,得到的是一条novelty–relevance前沿,而不是一个写死的混合策略;打分用五折out-of-fold,避免用户自己的结果泄漏进gate训练。
📊 5% NDCG-loss预算下,Novelty@10提升6.5%,只路由12.5%的用户。
📈 在相同relevance成本下,比niche启发式、短历史启发式和随机路由的novelty增益都更大。
✅ 换成非生成的Centroid语义画像也有类似收益,说明好处主要来自选择性路由,而不是LLM生成本身,这点挺反直觉。
📉 实验是1万真实流媒体用户,覆盖电影、剧集、体育;所有结果都是相对“一直走协同模型”的相对变化。
总结感想:适合已经在做画像或多路召回、想在生产里加novelty指标的团队。两个坑要留意,Novelty用的是self-information,和业务口径的“新鲜感”未必对齐;gate依赖流行度类特征,热度分布漂移时阈值得重扫。要盯的是NDCG-loss预算怎么定、路由比例是否稳定、线上novelty有没有真的动。
4. Neither Black nor White: Balancing Semantic and Collaborative Signals with Graph-Informed Semantic IDs (GrIS)
- 论文链接:AlphaXiv
- 更新时间:2026-10-01 12:08 UTC
- 机构:Huawei Ireland Research Centre
- 工业优先级:未标注
🧩语义ID不是表示学习,而是递归聚类
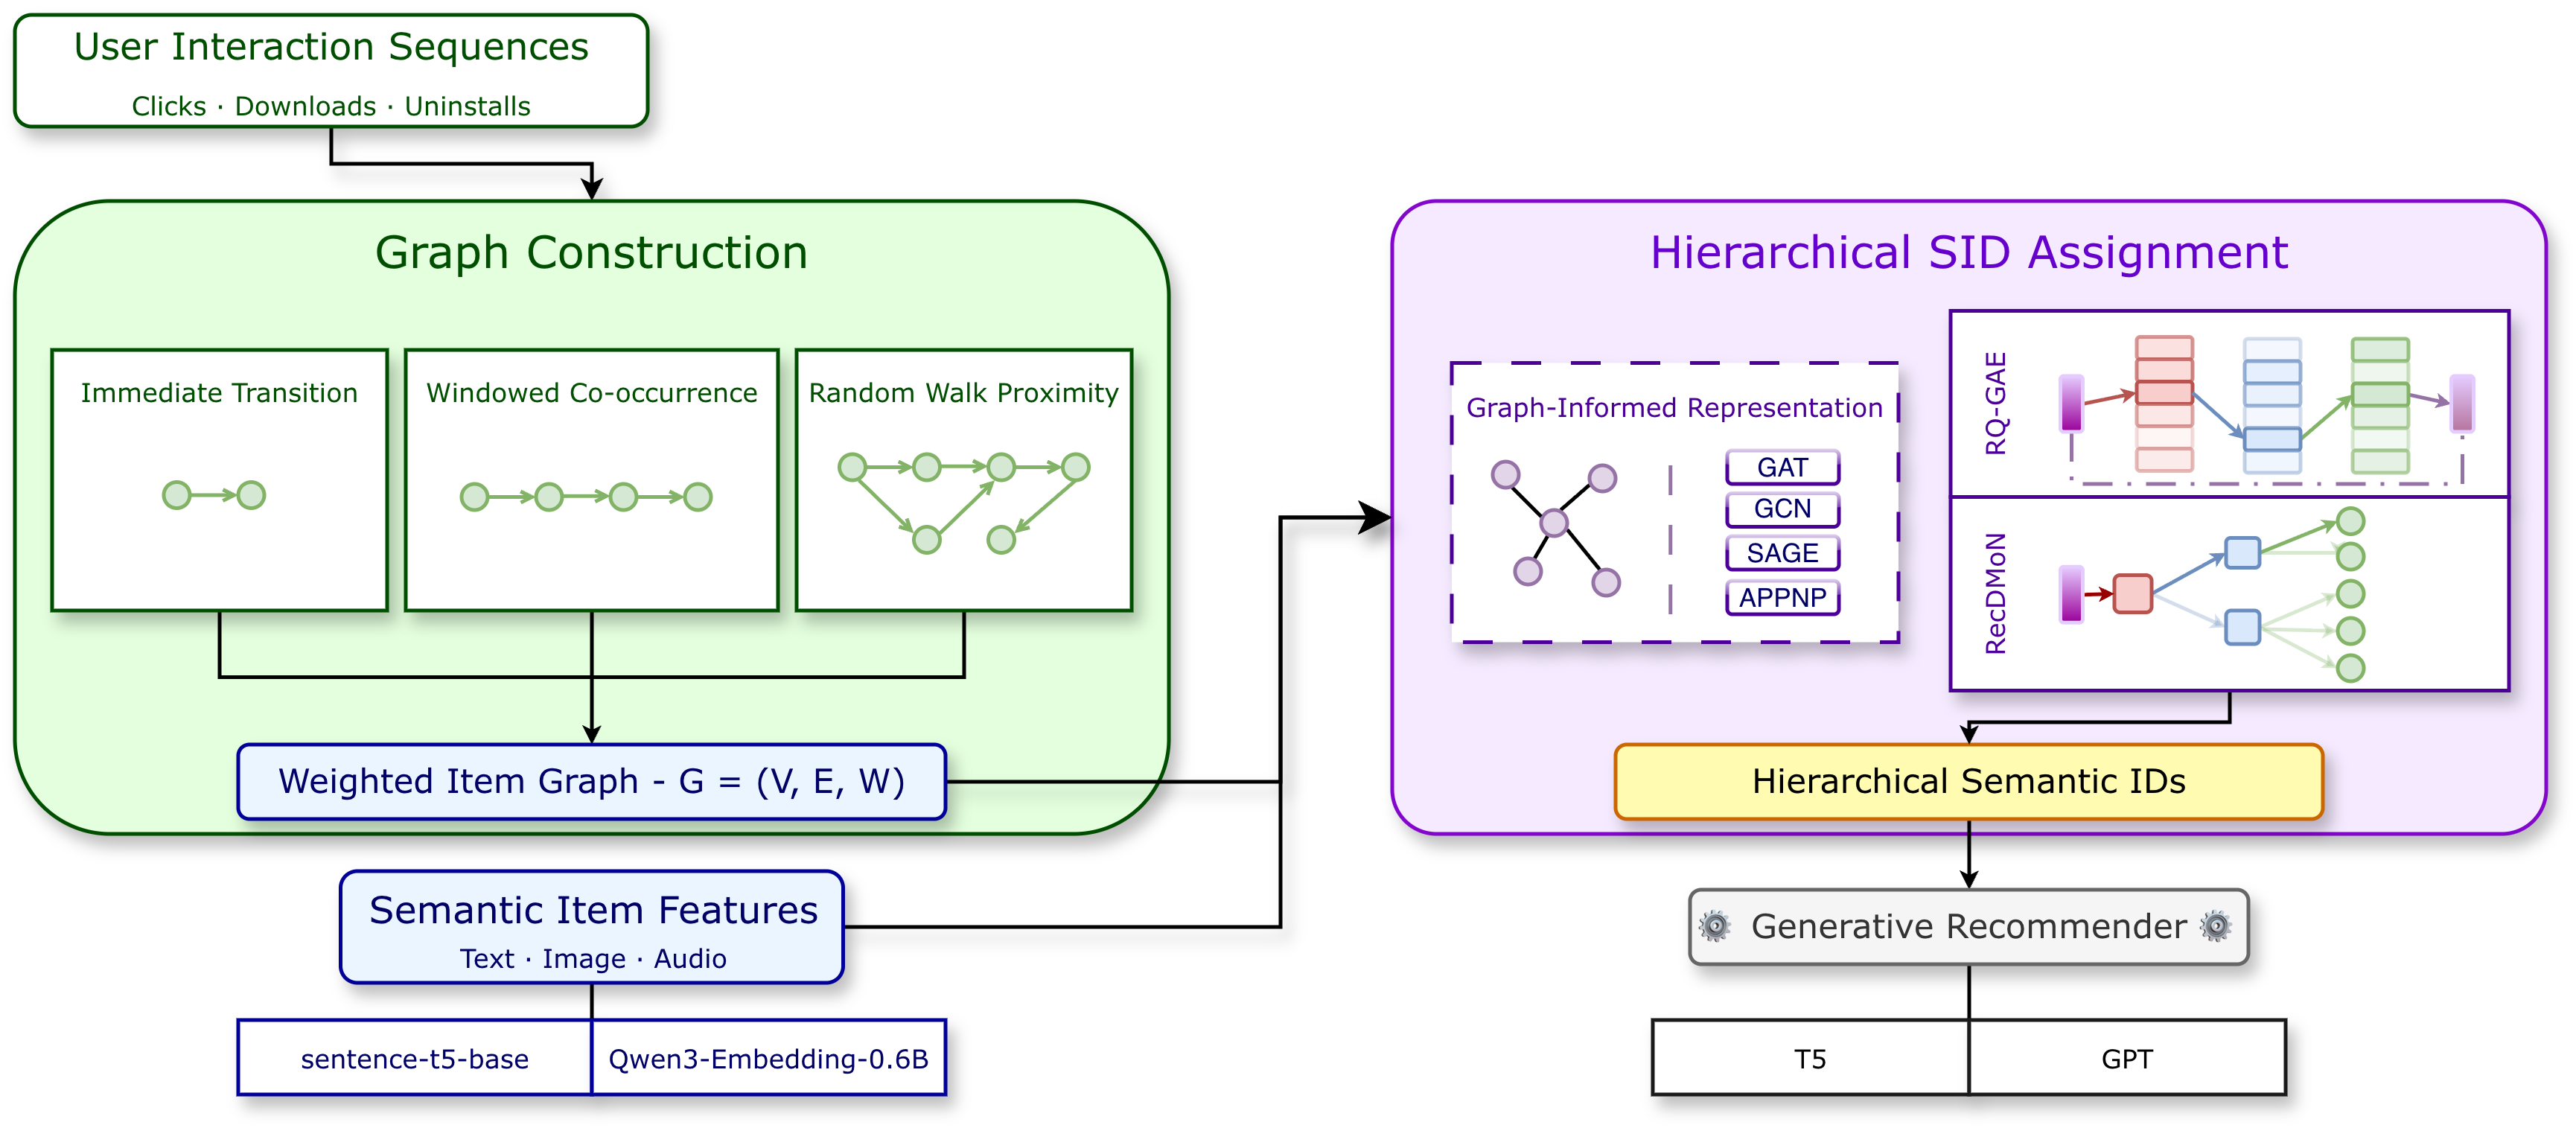
各位算法同学们,语义ID(SID)这块的默认思路一直是“把item编码成向量再量化成码”,但换个问法它其实是个递归聚类问题——要聚的不是孤立item,而是一张节点带语义、边带协同信号的图。这篇华为爱尔兰研究中心的 GrIS 把这层窗户纸捅破了,顺手把 RQ-VAE 这类主流方法收编成“图是空的”退化特例,所以它不是在推翻谁,而是把设计空间重新摊开。
📄 Neither Black nor White: Balancing Semantic and Collaborative Signals with Graph-Informed Semantic IDs (GrIS)
🔧 把 SID 构造重新定义成层次图划分:节点带内容语义,边带协同信号,分配 SID 就是递归地切这张图;内容和协同谁占主导,由图和划分算法共同决定,而不是先编码再量化时“顺便”带上。
🧩 拆出两条以前被当成一步的设计轴:图怎么建、递归怎么分。RQ-VAE、RQ-KMeans 正好落在“空图”这个角上,于是语义特征、协同图、划分器可以分别升级再组合,不用每次重写问题定义。
⚙️ 给了两个差异很大的实例:RecDMoN 用可微图池化直接学层次划分,RQ-GAE 保留残差量化骨架,加图感知的item表示和图重构目标。
📊 在多个真实数据集上,相比 CF-aware 的 SOTA 是一致提升,不是只在个别数据集上赢。
📈 最高提升 +52% Hit@10,而且用的还是文本元数据embedding,没上多模态。
✅ 图构建和划分是显式、可分别配置的模块,任一轴的改动都能单独评估、也能叠加,这点比“某个新tokenizer刷了个点”更实用。
总结:做生成式推荐 tokenizer 的同学可以跟这条线,重点盯 Hit@10、Recall 这类检索指标,同时看码本利用率、code冲突和长尾item的码分布。坑在图构建规则,共现阈值、边权、时间窗都得调;对比时要保证语义特征和下游生成器一致,否则增益可能来自特征而不是图。要是下游序列表征本来就够强,tokenizer 带来的边际收益会被吃掉一部分。
5. Residual Trajectory Distillation for Generative Retrieval
- 论文链接:AlphaXiv
- 更新时间:2026-09-30 08:59 UTC
- 机构:未披露机构
- 工业优先级:未标注
15个评测全涨,靠的是被丢掉的信息
各位算法同学们,生成式检索里有个被默许的浪费:用RQ构建语义ID时,只有最终那个硬SID被拿来当监督目标,产生它的残差轨迹训练完就扔了。ResTD这篇做的就是把这部分索引过程信息捡回来灌进检索训练,多语言电商检索ESCI上15个评测设置全线上涨,而且索引和推理流程一行没改。
📄 Residual Trajectory Distillation for Generative Retrieval
🔧 先说问题:同一个硬SID,可能来自对竞争码本完全不同的偏好。只监督最终码,等于把这些局部几何差异压成同一个目标,也丢掉了“后面几层量化会怎么选”的线索。
🧩 解法是把冻结的RQ索引器当过程老师:沿存储的SID路径重建残差诱导的码本偏好分布,再蒸馏到query条件下的SID解码状态里,共享的是同一套码本空间。
⚙️ 还做了多horizon监督:不只对齐当前层,前面几个解码状态也被后续若干层量化决策的码本偏好监督(论文展示H=4),让早期状态在SID后缀进上下文之前就编码它的信息。
📊 ESCI英语、西班牙语、日语三个语言,15个评测设置全部优于强基线。
📈 控制实验里,残差导出的目标赢过未来硬token监督、只用码本的软目标,也赢过其他item的形状匹配teacher。
✅ 表征探针显示,未来码本偏好从早期解码器状态里变得更可恢复。
📈 同一套思路扩到生成式推荐,多个数据集也一致提升。
总结:如果你在做RQ-SID的生成式检索或生成式推荐,它的切入点很实在——不动索引、不动推理,只在训练多挂一路蒸馏。坑也明确:残差邻近不等于query相关,附近码可能是别的item或无效路径,加上collision resolution会让存储SID和重建残差偏好的码不一致,直接蒸会和离散目标打架,作者是用锚定加一致性约束压住的。实际要盯的是下游召回/排序指标,对照组至少要跟“只用码本软目标”比,光看SID预测loss没意义。
6. RouteRec: Behavior-Guided Sparse Routing for Sequential Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-09-30 05:18 UTC
- 机构:Korea Advanced Institute of Science and Technology,Seoul National University
- 工业优先级:未标注
- 备注:Accepted at CIKM 2026. 12 pages, 12 figures, 7 tables
MoE路由该拿什么当信号?答案在行为里
各位算法同学们,MoE做推荐的老问题不是专家不够多,而是没人说得清该按什么把session分给专家。RouteRec给了个朴素的答案:别只看hidden state,先用session自己的行为特征当路由信号,而且这个信号预测前就能从日志里拿到。
📄 RouteRec: Behavior-Guided Sparse Routing for Sequential Recommendation(CIKM ‘26)
🔧 路由信号换成四类行为线索:Tempo取时间戳节奏,Focus取item group变化,Memory统计会话内与会话间的重复与延续,Popularity用训练集频率。都是直接算出来的,不靠额外标注。
🧩 三级路由分工清楚:macro看整段历史,mid看session级,micro细到位置级。先用线索分数选专家组,组内再用当前backbone的hidden state细化挑专家。macro和mid的线索全位置共享,micro和组内打分才跟位置走。
⚙️ 只动FFN,不动注意力:backbone还是SASRec,把三处的feed-forward换成routed expert block,其余照旧,迁移成本不高。
📊 六个公开数据集、18个dataset-metric组合里,12个第一、3个第二,平均排名1.61,次好的baseline是4.11。
📈 九个baseline对比之外还做了matched control:换掉行为线索、只留hidden state路由,SASRec和DuoRec两个backbone上都掉点,说明涨的不是多出来的参数量。
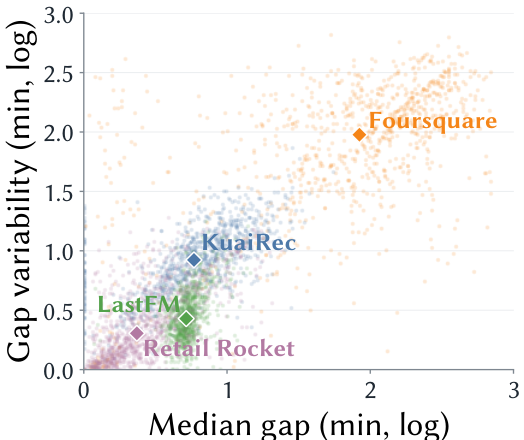
✅ KuaiRec、LastFM、Retail Rocket三个数据集上三个指标全领先,专家使用率也随行为线索变化,路由分布和观测到的行为对得上。
🧠 我的判断:如果你在做session-aware序列推荐、已经用过MoE但说不清收益来自哪里,这篇的切入点可以直接抄——先定义可观测的路由信号,再谈专家容量。要盯的是平均排名和matched control,别只看单个数据集的最好值。两个坑:Focus线索依赖数据集自带的category/genre/artist,没有就补零,此时实际只有三类线索在工作;它替换的是FFN,如果backbone不是SASRec式结构,路由点得重新设计。
7. Optimizing Effective Training Time for Large-Scale Recommendation Systems
- 论文链接:AlphaXiv
- 更新时间:2026-10-02 02:58 UTC
- 机构:未披露机构
- 工业优先级:未标注
推荐训练40%的GPU时间在空转
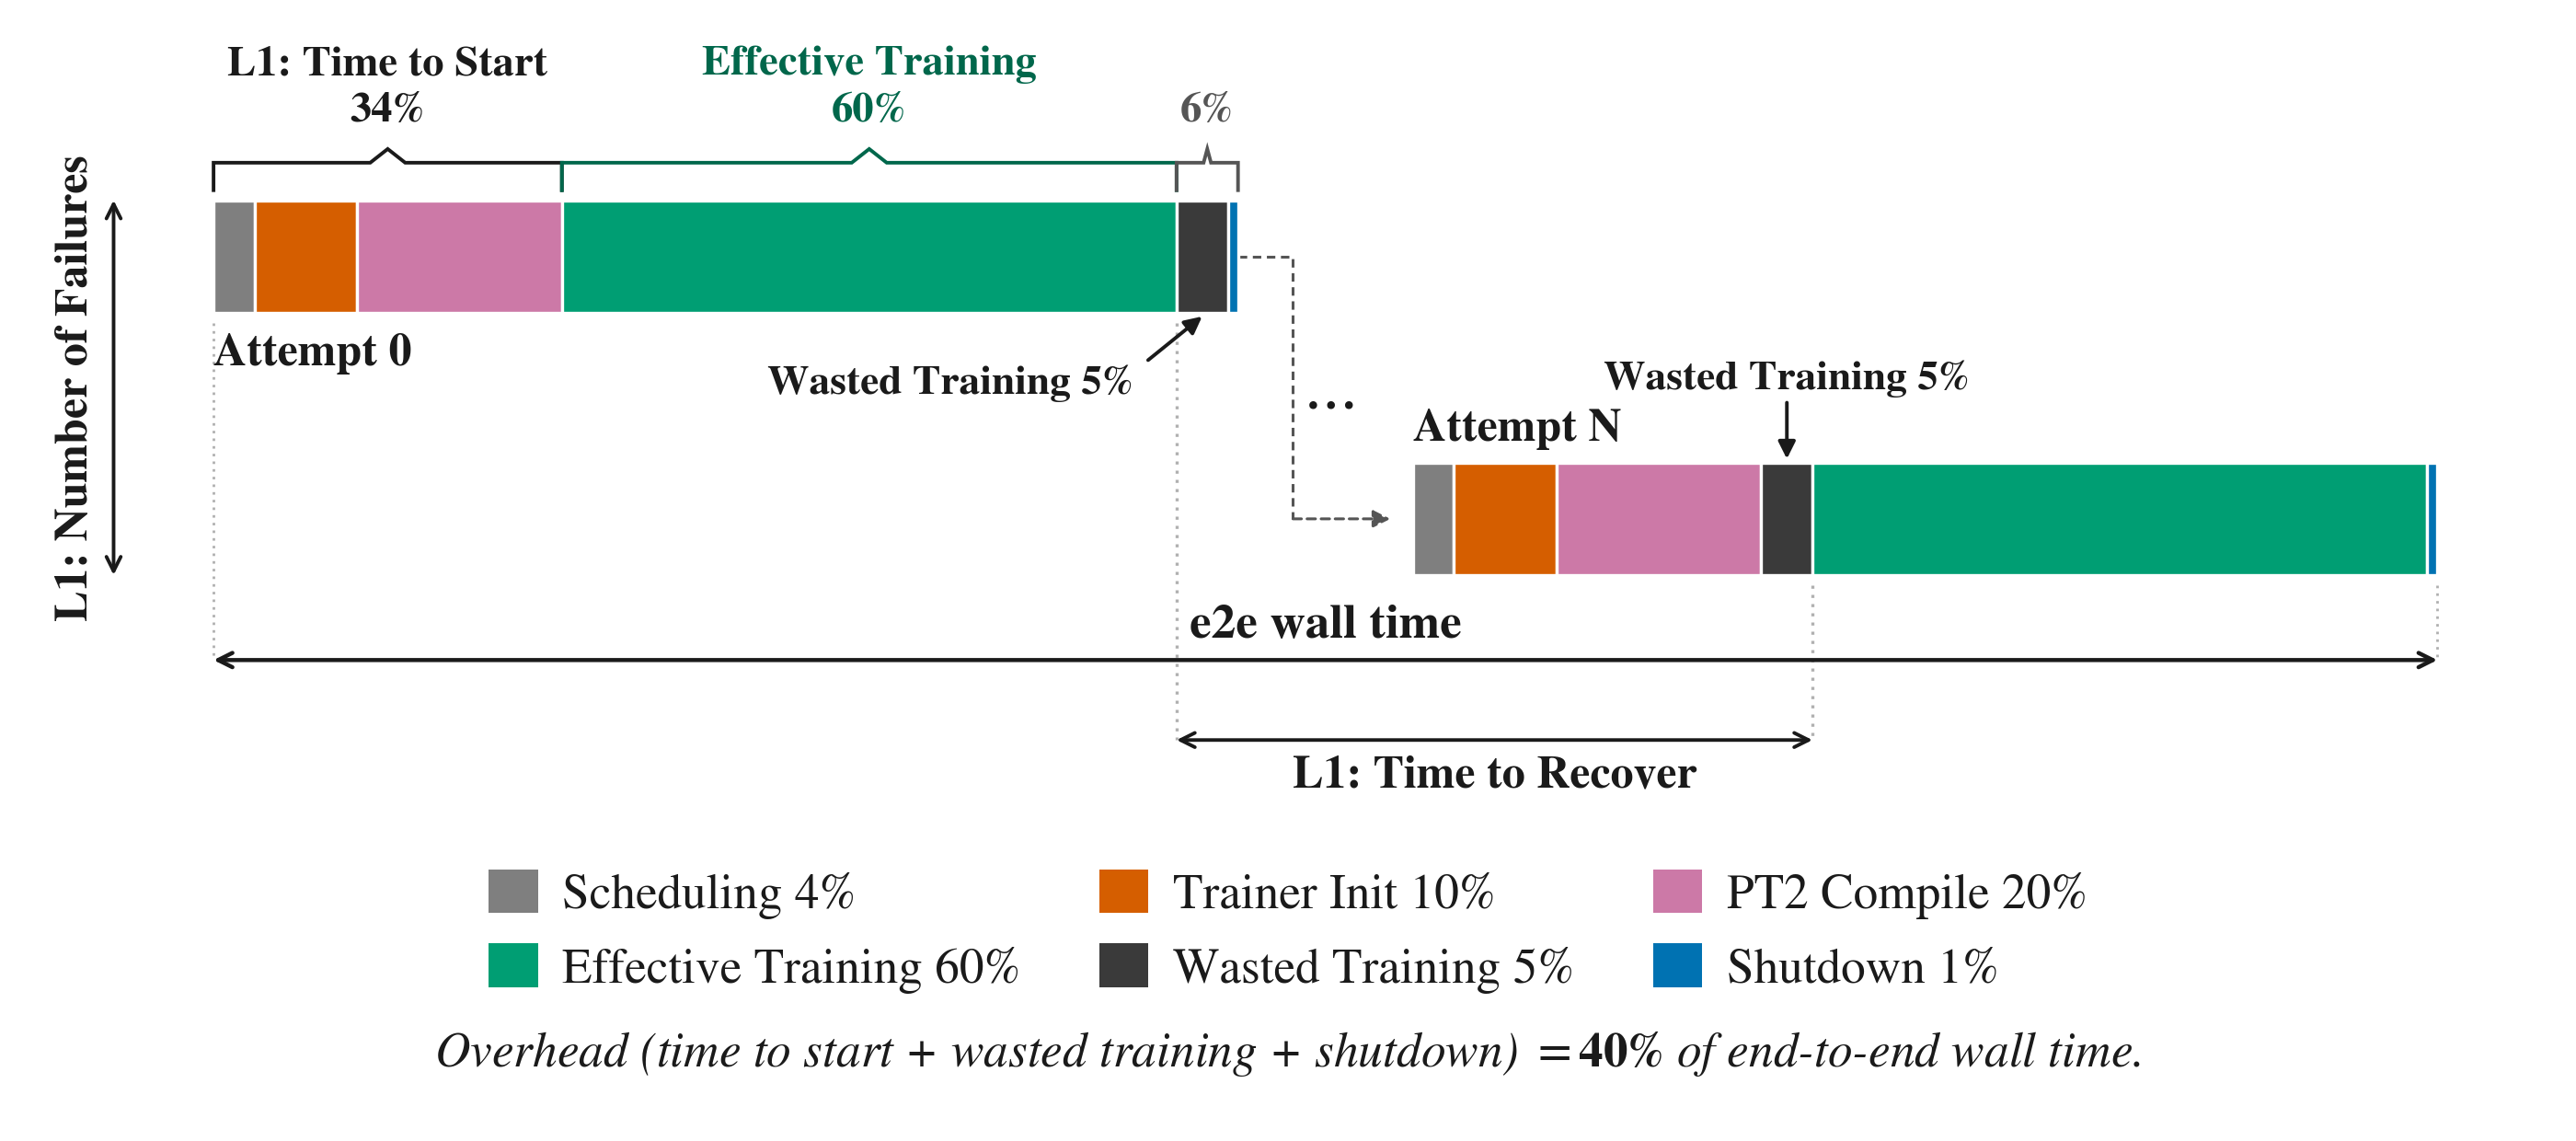
各位算法同学们,你们以为训练慢是算子没调好?Meta 广告推荐最大的训练作业,端到端墙钟里只有 50-60% 真的在吃新数据,剩下 40% 花在初始化、编译、checkpoint、故障恢复上。这篇就是把这段隐形损耗拆开、逐项优化的工作。
📄 Optimizing Effective Training Time for Large-Scale Recommendation Systems
🔧 提出 ETT%:端到端墙钟里真正推进数据 cursor 的比例,写成 1 − (TTS + NoF×TTR)/总墙钟。它比 MFU 多覆盖训练循环之外,比 Goodput 多一层归因。
🧩 两级分解:L1 是 TTS、TTR、失败次数;L2 拆成调度、Trainer 初始化、PT2 编译、有效训练、无效训练、shutdown 六项,每项绑定一个系统和一个负责团队。指标跌了以后能直接问到人。
⚙️ 优化集中在初始化(通信消除、流水线重叠)、PT2 编译(动态 shape 处理、autotune 剪枝、可复用编译缓存)、异步 checkpoint、模型独立发布和恢复降本。方法本身都是成熟货,新意在选哪个、怎么算端到端收益、怎么别把收益还回去。
📊 7 个推荐模型、H100、8 到 2000 GPU;6 组配对实验里 ETT% 平均提升 15.5 个百分点,基线 59–85% 提到 80–93%。
📈 最大的作业 ETT% 打到 85%,全集群部署后从约 80% 升到 90% 以上。
✅ 恢复路径的优化贡献了总节省时间的 58%;TTR 的下降是 TTS 下降的 1.8–8.6 倍,因为重启会重做一遍启动阶段的活。
🔍 单个 128 GPU 作业的实测分解:151.5 分钟里有效训练 90 分钟,PT2 编译独占 30 分钟,Trainer 初始化 15 分钟。
判断:值得跟的是指标怎么拆、怎么归到具体团队,不是那些优化手段本身。如果你们在做日级刷新的推荐或排序训练,作业短、重启频繁,这套账本可以直接抄。两个坑:L2 埋点必须打在准确的阶段边界上,否则归因还是会变成跨团队扯皮;另外别只盯 TTS,重启会重复启动阶段的活儿,先压 TTR 收益更大。如果你们是几周长跑的 LLM 预训练,冷启动摊薄到 0.2%,这套优先级不适用。
8. Learning Multiresolution Relevance for Hierarchical Generative Retrieval
- 论文链接:AlphaXiv
- 更新时间:2026-09-30 08:51 UTC
- 机构:未披露机构
- 工业优先级:未标注
SID监督粒度不对?这篇来对齐🔧
各位算法同学们,同一 query 的多篇相关文档,在 SID 里常常共享粗前缀、只在细粒度才分叉,但标准 full-SID 监督把它们当成互不相干的目标路径。这篇把“相关性在不同检索分辨率上如何分配”显式建模,直接补上这个监督–分辨率错位。
📄 Learning Multiresolution Relevance for Hierarchical Generative Retrieval
🔧 把文档级 relevance 投影到每层 SID,得到一致的逐层条件分布:父节点质量等于子节点质量之和,不同深度看的是同一个 query 相关性。
🧩 RARS 用共享 query 表示加 prefix-conditioned predictor,让所有带相关性的兄弟分支参与局部竞争,局部损失按到达父节点的 relevance mass 加权。
⚙️ predictor 只在训练时使用,推理仍走标准自回归解码,不改变检索规则和索引。
📊 在 ESCI 英语、西班牙语、日语三个 locale 上,相比匹配的 full-SID 训练,自回归解码下都有一致提升。
📈 同一检索规则下,超过 grouped soft-target、decoder soft-target、sampled-tree 三类监督。
✅ 换不同 SID 结构和 relevance 定义后,增益仍然存在。
做生成式检索、SID/trie 解码、多正例监督的同学适合跟。落地先看多正例比例和中间层分叉是否常见;指标盯 Recall@k 和 NDCG,同时确认训练目标是否只盯 leaf。坑在于相关性标注不完整会模糊分支分布,另外预测器千万别带进推理,否则白做。