推荐算法日报 · 2026-09-17
总览
今天这批货数量不多但质量挺顶,两篇都是能直接上手抄作业的类型,而且凑巧撞在同一个母题上——到底什么才是真正涨点的东西。快手那篇做低活用户序列增广的,思路我挺买账:别人都在协同信号里卷,它把图文多模态用 Stein kernel 对进统一空间再去做检索,越稀疏的数据集涨得越多,单模态反而掉到基线以下,这个消融基本把故事讲圆了,而且线上数亿用户跑了两周 A/B 已经上主流量,属于少数能拿业务指标背书的工作,不过它用户侧表征就是历史 item 向量平均池化、时序全丢,检索阈值怎么定、会不会把流行度偏置和兴趣同质化一起带进来,正文一个字没交代。KDD Cup 2026 UniRec 那篇更狠,第 10 名方案老老实实做 leave-one-out,结论相当反直觉:dense 特征表示栈扛了约 65% 的增益,序列建模侧那一堆花活全落在种子噪声带里等于没干活,还不藏着掖着地告诉你验证 AUC 被 iid 划分系统性抬高、抗记忆改动会符号反转——这种负结果和评估陷阱的密度,比排名本身值钱得多。所以今天的主线就一条:别急着堆结构,先搞清楚增益到底来自哪一层,两篇一个给正面样本一个给反面教材,配着读刚好。真要我挑,今天优先看 KDD Cup 那篇的消融和评估分析,再回头看快手的多模态对齐检索,一个治思路一个给方法,性价比最高。
论文列表
1. MARS: Modality-Aligned Retrieval for Sequence Augmented CTR Prediction
- 论文链接:AlphaXiv
- 更新时间:2026-09-17 06:20 UTC
- 机构:未披露机构
- 工业优先级:强
低活用户CTR差?用图文对齐捞相似序列
各位算法同学们:快手上大约35%的用户一个月行为不到1000条,而CTR模型的建模长度已经从10的3次方卷到10的6次方——序列越长,这批低活用户越吃亏。这篇KDD’25的工作换了个思路:行为不够,就从别的模态里借。
📄 MARS: Modality-Aligned Retrieval for Sequence Augmented CTR Prediction
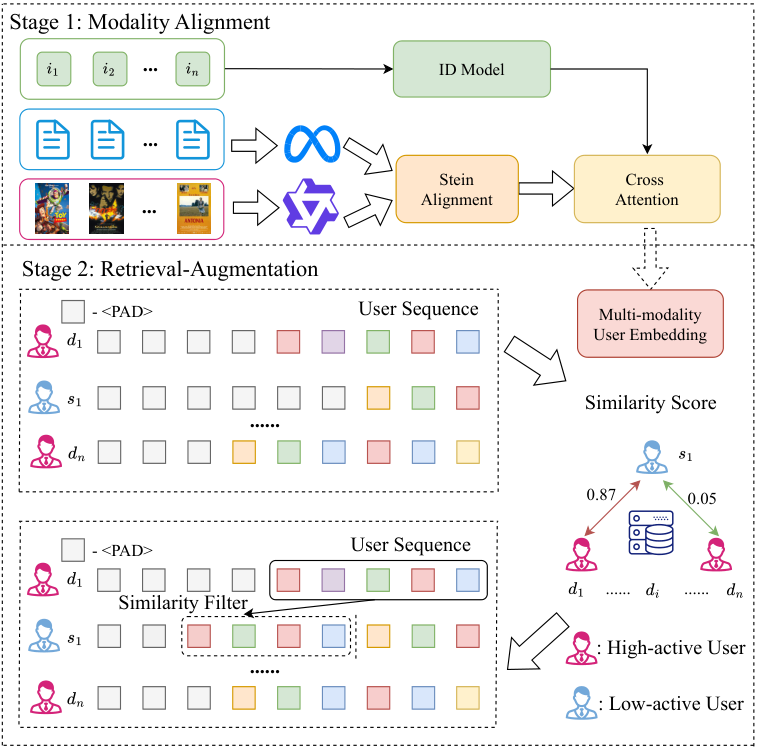
🔧 增强不再只吃协同信号。物品文本用LLaMA编码、图像用ViT编码,再通过Stein核做跨模态分布对齐,把图文压进同一个语义空间,好处是不依赖负采样和大batch,训练更稳。
🧩 增强方式很直接:用对齐后的多模态用户embedding,给每个低活用户检索最相似的高活用户,再按item-user相似度过滤,最后把对方的序列拼进低活用户的历史里。
⚙️ 对齐损失里加了熵正则,防止embedding空间塌缩,保证检索出来的邻居有区分度,而不是一锅端。
📊 快手线上A/B中核心业务指标有增长,已上线服务数亿用户的主流量。
📈 论文给的分布数据是35%用户一个月行为少于1000条,这正说明长序列模型的红利覆盖不到这部分人。
✅ KDD’25,代码匿名开源,仓库 github.com/wangshukuan/MARS,可以自己跑。
总结:这套方法对做低活、稀疏场景排序和召回的团队有直接参考价值,本质是把多模态对齐当成检索的底座。要盯的指标是检索过滤后的序列噪声比例,以及多一路检索加过滤带来的线上延迟;坑在于把高活用户的序列塞进低活用户历史,容易引入语义漂移,过滤阈值设松了会反噬。
2. Dense Feature Representation over Sequence Modeling: A Solution to the KDD Cup 2026 UniRec Challenge
- 论文链接:AlphaXiv
- 更新时间:2026-09-17 06:52 UTC
- 机构:Z Lab
- 工业优先级:中
- 备注:6 pages, 1 figure, 4 tables. KDD Cup 2026 Tencent UniRec Challenge Workshop
CVR涨点靠dense表示不靠序列建模
各位算法同学们,KDD Cup 2026 UniRec 这道 CVR 赛题里,把 AUC 从 0.813237 拉到 0.828535 的,并不是更精细的序列建模。作者用 leave-one-out 的方式逐个拆模块,看排名分掉多少,结论有点反直觉——真正扛收益的是 dense 特征表示和优化器,序列侧组件几乎没边际贡献。
📄 Dense Feature Representation over Sequence Modeling: A Solution to the KDD Cup 2026 UniRec Challenge
🔧 dense 表示栈:把池化的用户 dense 字段拆成 5 个子组 token,对重尾列(量级能到 1e9)做 log1p,再补上对齐配对投影、item 侧拆分和原始统计通道。
🧩 合并单流序列:所有行为域合成一条按时间排序的流,用递减 top-k 压缩编码(LONGER 思路),再接入 TAPF 的目标条件极性通道,用零初始化极性 bias 加一个 gate 把正负行为分开。
⚙️ 优化器这块:dense 参数用 AMUSE(Muon 家族,正交化更新)配 EMA 选模型;稀疏 embedding 用 Adagrad 加自适应正则,专门压制稀有 ID 的记忆。
📊 15 步单变量链把 test AUC 从 0.813237 提到 0.827816,最终提交 0.828535,排第 10。
📉 拆掉 dense 表示栈掉 0.0095 AUC,拆掉正交化优化器掉 0.0028,两处基本就是全部增益。
✅ 反过来,合并单流 backbone、极性通道、辅助头、per-token FFN 这些序列侧组件,单独拆掉都不到 0.0005,落在 ±0.0004 的种子波动带里。
⚠️ 还有个坑:按 row group 切分的验证集和 leaderboard 共用一个时间窗,validation AUC 比榜上高约 0.014,防记忆和高基数 ID 的改动甚至会反号。
这篇更像一份“哪一步真的有用”的实证报告,不是新结构。做工业 CVR 的话,先动 dense 侧的特征拆分、log1p 和优化器,比堆序列长度划算;同时别信共时间窗的验证集,决策必须看留出榜。序列建模在这个数据规模上,边际收益是真的小。