推荐算法日报 · 2026-09-18
总览
今天这批货整体成色相当高,工业味浓、负结果报得也实在,读下来最强烈的感受是:序列化建模还在扩张,但它的边界和隐藏成本第一次被讲得这么清楚。主线大致有两条,一条是序列模型继续吃特征工程——LinkedIn 那篇用真刀真枪三个多月的线上 A/B 证明砍掉八成手工特征还能涨,但也坦白 LLM-Ranker 从没打赢过原生产模型、pre-LN 不到位 AUC 直接崩到 0.5;另一条是「谁的收益到底来自哪」这件事开始被认真对待,KDD Cup UniRec 那篇用 leave-one-out 拆出来序列侧几乎零贡献、dense 特征栈才是大头,还顺手揭了验证集比榜单系统性高 0.014 的伤疤,这种文章比涨点文值钱得多。序列增广、序列与特征交叉统一 block、生成式广告检索这几篇各有亮点,多模态对齐防坍缩和把硬过滤提前到解码里这两个设计都挺巧,但基本都卡在「离线很美、线上只报业务指标、延迟成本一字不提」或者收益量级要靠长期攒。最值得细读的是 LinkedIn 那篇和 KDD Cup 那篇,一个给落地坑位清单,一个给评估方法论和负结果;AURA 那篇关于成本结构和「诊断可信、修复未验证」的坦诚也值得扫一遍。今天就优先看领英那篇和 KDD Cup 那篇,其余的按你手上的方向挑着看即可。
论文列表
1. An Industrial-Scale Sequential Recommender for LinkedIn Feed Ranking
- 论文链接:AlphaXiv
- 更新时间:2026-09-16 03:17 UTC
- 机构:LinkedIn
- 工业优先级:强
LinkedIn 排序换掉 DCNv2,时长 +2.1% 📈
各位算法同学们,一个排序模型先在线上扛了三个多月流量才发论文,通常说明它真能扛,而不是赶着刷榜。LinkedIn 把 Feed 排序的老 backbone DCNv2 换成了序列 Transformer,A/B 里人均时长涨了 2.10%。
📄 An Industrial-Scale Sequential Recommender for LinkedIn Feed Ranking
🔧 主线是系统-模型协同设计:CPU/GPU 分离部署,shared-context batching 一次给同一请求的几百个候选打分,Arrow 到 tensor 零拷贝传输,还写了自研 Flash-Attention kernel SRMIS,比 PyTorch SDPA 快约 2 倍。
🧩 特征走 late fusion:把一部分 context 特征(主要是 item 热度和 viewer-author 亲和度这类数值信号)从 transformer 前面挪到输出之后拼接。离线 Long Dwell AUC 只掉 0.04%,训练 step 时间少 12%,线上 top-line 指标打平。
⚙️ 两个细节挺反直觉:用 LLM 派生出的会员画像 embedding 补稀疏历史;用 within-session randomization 处理同一次会话内 label 相关性造成的 train-serve skew。另外 attention 用 Softmax 反而比 Sigmoid、SiLU、ReLU 好。
📊 线上 A/B:time spent +2.10%,点赞/评论/转发 +3.52%,baseline 就是生产环境里跑的 DCNv2 ranker。
✅ 覆盖 12 亿会员,已承接 LinkedIn Feed 大部分流量超过三个月,不是小流量试水。
📈 等算力(10^17 FLOPs)下把 transformer block 换成 HSTU 层,Long Dwell AUC 掉 0.21%。
🧩 late fusion 是拿 0.04% 的 AUC 换 12% 的训练提速,线上打平,这笔账划不划算取决于你的训练成本。
总的说,如果你在做工业推荐、被延迟和吞吐卡着上不了长序列模型,这篇的 serving 部分比模型结构该先看。要盯三样:线上时长和互动率、训练 step 时间、train-serve skew 有没有被 within-session 那类设计按住。坑是 1000 条历史是配合 0.1 负采样调出来的,换业务得重调历史长度和采样,别直接搬。
2. MARS: Modality-Aligned Retrieval for Sequence Augmented CTR Prediction
- 论文链接:AlphaXiv
- 更新时间:2026-09-17 06:20 UTC
- 机构:未披露机构
- 工业优先级:强
低活用户CTR差?用图文对齐捞相似序列
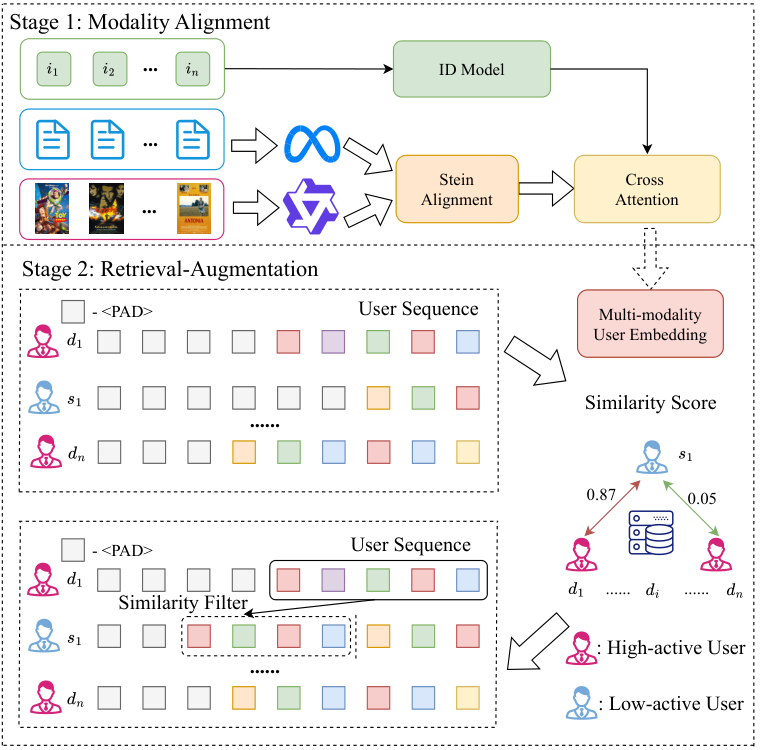
各位算法同学们:快手上大约35%的用户一个月行为不到1000条,而CTR模型的建模长度已经从10的3次方卷到10的6次方——序列越长,这批低活用户越吃亏。这篇KDD’25的工作换了个思路:行为不够,就从别的模态里借。
📄 MARS: Modality-Aligned Retrieval for Sequence Augmented CTR Prediction
🔧 增强不再只吃协同信号。物品文本用LLaMA编码、图像用ViT编码,再通过Stein核做跨模态分布对齐,把图文压进同一个语义空间,好处是不依赖负采样和大batch,训练更稳。
🧩 增强方式很直接:用对齐后的多模态用户embedding,给每个低活用户检索最相似的高活用户,再按item-user相似度过滤,最后把对方的序列拼进低活用户的历史里。
⚙️ 对齐损失里加了熵正则,防止embedding空间塌缩,保证检索出来的邻居有区分度,而不是一锅端。
📊 快手线上A/B中核心业务指标有增长,已上线服务数亿用户的主流量。
📈 论文给的分布数据是35%用户一个月行为少于1000条,这正说明长序列模型的红利覆盖不到这部分人。
✅ KDD’25,代码匿名开源,仓库 github.com/wangshukuan/MARS,可以自己跑。
总结:这套方法对做低活、稀疏场景排序和召回的团队有直接参考价值,本质是把多模态对齐当成检索的底座。要盯的指标是检索过滤后的序列噪声比例,以及多一路检索加过滤带来的线上延迟;坑在于把高活用户的序列塞进低活用户历史,容易引入语义漂移,过滤阈值设松了会反噬。
3. Bumblebee: Interleaved Mixed-Layer Building Blocks for Large-Scale Recommendation Systems
- 论文链接:AlphaXiv
- 更新时间:2026-09-15 22:17 UTC
- 机构:未披露机构
- 工业优先级:强
推荐系统:把序列和特征交叉交错起来🐝
各位算法同学们,推荐模型一直在两条路上各走各的:序列建模管用户历史,特征交叉管上下文特征,但很少有人让它们在同一个块里反复混合。Bumblebee 这篇就是把这两条路交错起来,而且消融显示交错的组合方式本身才是涨点主因。
📄 Bumblebee: Interleaved Mixed-Layer Building Blocks for Large-Scale Recommendation Systems
🔧 交错混合层块:每个 block 内部把序列个性化、注意力编码、目标感知过滤注意力、跨注意力融合和特征交叉串成一个自包含微流水线,而不是先序列后特征、或先特征后序列。 🧩 跨模态残差通路:块与块之间的残差连接不再只传单模态信息,而是同时搬运序列和特征交互信号。消融里这个机制单独贡献 0.25% NE,且不增加额外参数。 ⚙️ 可配置组件丢弃:块内组件可以按需丢掉,用来在质量和吞吐之间做权衡,也支持把多个块堆起来做迭代精炼。
📊 消融实验:跨模块残差信息流单独带来 0.25% NE 提升,参数没多。 📈 在多个分类和回归任务上,Bumblebee 相比可比基线模型取得一致提升,但论文没有给出具体相对增益。 ✅ 大规模工业数据评估显示,交错组合本身是主要提升来源,而不是简单加深堆叠。
总结一下,如果你在做大规模推荐,且序列模型和特征交叉还是两套分开的 pipeline,这篇的思路值得跟。要盯的指标是 NE 和吞吐的 trade-off,坑在于组件可丢弃会放大调参空间,0.25% NE 是消融单因素收益,端到端线上收益得看你的基线和数据规模;和 DHEN 比它补了 UIH 处理,和 HSTU 比它在注意力前后都保留了上下文注入。
4. AURA: Agentic Diagnosis and Refinement for Production Recommender Systems at Scale
- 论文链接:AlphaXiv
- 更新时间:2026-09-15 04:38 UTC
- 机构:未披露机构
- 工业优先级:中
- 备注:14 pages, 1 figure, 6 tables. Accepted at GenAIECommerce’26: The Third Workshop on Agentic and Generative AI for E-Commerce, co-located with RecSys 2026, September 28, 2026, Minneapolis, MN, USA
推荐指标涨了,用户却在踩坑?
各位算法同学们,NDCG涨了就等于推荐变好了吗?这篇来自迪士尼团队的工作说:不一定。它用LLM agent把成千上万条线上session读成失败案例库,再顺藤摸瓜改到推荐系统自己的代码里。
📄 AURA: Agentic Diagnosis and Refinement for Production Recommender Systems at Scale
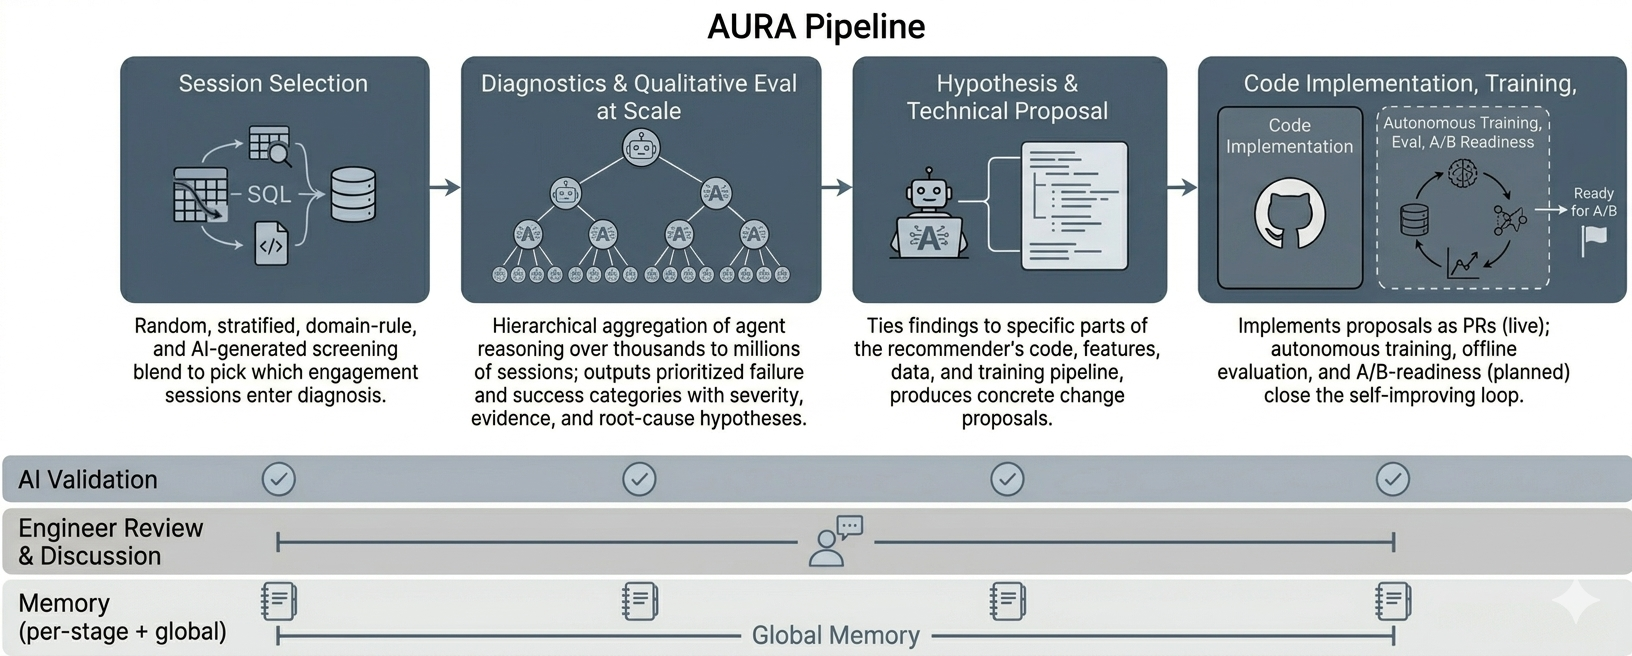
🔧 把“人肉看case”做成流水线:四个阶段——选session、规模化定性诊断、生成根因假设和技术提案、落到代码PR,中间穿插AI校验、工程师review和记忆日志。 🧩 诊断不止给结论,还带证据:每个失败或成功类别附严重度、session证据和根因假设,再从推荐系统自己的代码、特征和训练管线里找可改点。 ⚙️ 换平台靠配置不靠改代码:数据源、列映射、分群定义、prompt覆盖都走配置层,已经在两个消费平台之间迁移过,并给出电商和零售推荐的映射。
📊 阶段级rubric分数:Platform A从15/25提到23/25,Platform B从17/25提到24/25。 📈 成本:Platform A的96,801条session花321美元,Platform B的101,594条session花250美元,大头在上游逐session判断,下游聚合只占小部分。 ✅ 分类词表收敛后:Platform A从12个涌现tag合并成8类,没有诊断损失;Platform B只剩一次重命名,零合并。
总结感想:如果你在做线上推荐、又苦于指标掉了但不知道谁被坑,这套思路可以拆开抄:先固定失败类别词表,再让agent给证据,最后才碰代码。坑也明显:成本随session量线性涨,且它现在主要产出人类review的PR,不是全自动闭环;真要落地,先盯诊断阶段的证据可信度和人工否决率,别一上来就接自动训练。
5. Dense Feature Representation over Sequence Modeling: A Solution to the KDD Cup 2026 UniRec Challenge
- 论文链接:AlphaXiv
- 更新时间:2026-09-17 06:52 UTC
- 机构:Z Lab
- 工业优先级:中
- 备注:6 pages, 1 figure, 4 tables. KDD Cup 2026 Tencent UniRec Challenge Workshop
CVR涨点靠dense表示不靠序列建模
各位算法同学们,KDD Cup 2026 UniRec 这道 CVR 赛题里,把 AUC 从 0.813237 拉到 0.828535 的,并不是更精细的序列建模。作者用 leave-one-out 的方式逐个拆模块,看排名分掉多少,结论有点反直觉——真正扛收益的是 dense 特征表示和优化器,序列侧组件几乎没边际贡献。
📄 Dense Feature Representation over Sequence Modeling: A Solution to the KDD Cup 2026 UniRec Challenge
🔧 dense 表示栈:把池化的用户 dense 字段拆成 5 个子组 token,对重尾列(量级能到 1e9)做 log1p,再补上对齐配对投影、item 侧拆分和原始统计通道。
🧩 合并单流序列:所有行为域合成一条按时间排序的流,用递减 top-k 压缩编码(LONGER 思路),再接入 TAPF 的目标条件极性通道,用零初始化极性 bias 加一个 gate 把正负行为分开。
⚙️ 优化器这块:dense 参数用 AMUSE(Muon 家族,正交化更新)配 EMA 选模型;稀疏 embedding 用 Adagrad 加自适应正则,专门压制稀有 ID 的记忆。
📊 15 步单变量链把 test AUC 从 0.813237 提到 0.827816,最终提交 0.828535,排第 10。
📉 拆掉 dense 表示栈掉 0.0095 AUC,拆掉正交化优化器掉 0.0028,两处基本就是全部增益。
✅ 反过来,合并单流 backbone、极性通道、辅助头、per-token FFN 这些序列侧组件,单独拆掉都不到 0.0005,落在 ±0.0004 的种子波动带里。
⚠️ 还有个坑:按 row group 切分的验证集和 leaderboard 共用一个时间窗,validation AUC 比榜上高约 0.014,防记忆和高基数 ID 的改动甚至会反号。
这篇更像一份“哪一步真的有用”的实证报告,不是新结构。做工业 CVR 的话,先动 dense 侧的特征拆分、log1p 和优化器,比堆序列长度划算;同时别信共时间窗的验证集,决策必须看留出榜。序列建模在这个数据规模上,边际收益是真的小。
6. One-Step Retrieval Framework for Real-Time Sponsored Search Ads Using Hierarchical Text Representations
- 论文链接:AlphaXiv
- 更新时间:2026-09-16 08:18 UTC
- 机构:未披露机构
- 工业优先级:未标注
🔍广告检索不用SID了?ANGLE这么干
各位算法同学们,广告检索线上消费 +1.81%、GMV +2.16%,但更狠的是它把相关性评估和预排序直接砍了,生成完候选就送进最终排序。
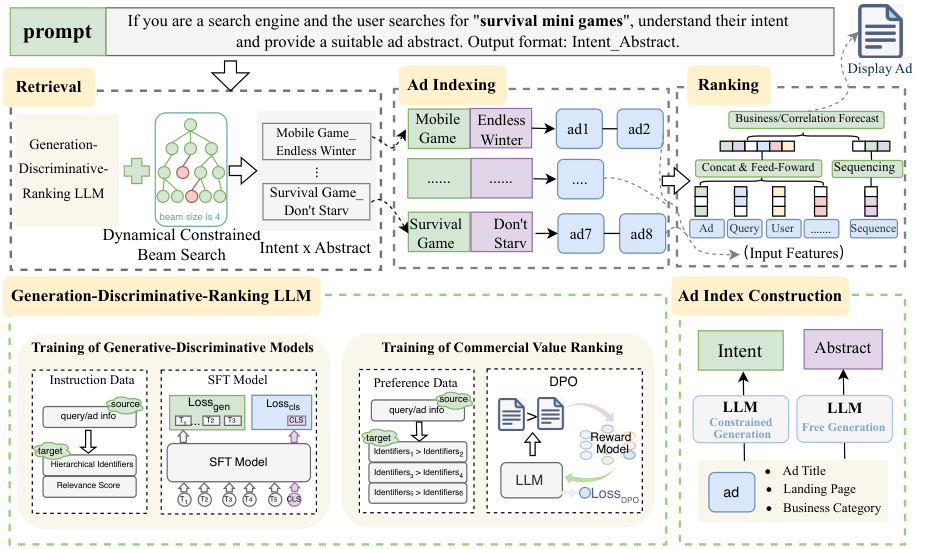
这篇要解决的是传统多级级联架构里各模块目标不一致、高潜广告被提前筛掉的问题,以及 SID 生成式方法要背大量映射、泛化差、解码效率低。它给出的 ANGLE 框架,用分层文本表示替代离散 SID,还把生成、判别、排序合进一个 LLM。
📄 One-Step Retrieval Framework for Real-Time Sponsored Search Ads Using Hierarchical Text Representations
🔧 广告表示换成 intent + abstract 的分层文本。intent 给高层商业意图概览,abstract 给细粒度广告细节,直接由 LLM 生成。新广告不用重建 SID 映射,从广告文本生成 int-abs 对就行,泛化更好,也更可解释。
🧩 训练一个 GDR-LLM,把生成、判别、排序能力塞进同一个基座。检索时先生成 query 对应的 intent-abstract,再用倒排索引找回广告,检索结果跳过 relevance 和 pre-ranking,直接进 ranking。
⚙️ 解码用动态约束 beam search,beam size 是 4,保证生成的 intent-abstract 能命中广告索引,不是自由发挥。这个细节挺工程,直接关系到线上能不能实时出候选。
📊 线上 A/B 实验:消费 +1.81%,GMV +2.16%,点击 +1.5%,来自真实搜索广告场景。
📈 离线对比 7 个 baseline,在 HR、MAP、ACR 这几个关键指标上 ANGLE 都最好。
✅ 论文提到框架在千万级规模的生产环境验证,不是纯离线玩具。
总结一下,做搜索广告或生成式检索的同学可以跟,重点看它怎么用文本表示替代 SID、怎么平衡生成和排序。要盯的指标除线上 GMV 和消费,还有离线 HR/ACR 以及索引覆盖率。坑也明显:int-abs 表示质量依赖 LLM,广告库更新和倒排索引维护成本、约束解码的命中率、跳过 relevance 后 ranking 的压力,都得看线上长期表现。和 MCA 比它链路更短,和 SID 生成式方法比它泛化和可解释性更好,但大规模广告库下能不能稳住,是后续要观察的点。