推荐算法日报 · 2026-09-16
总览
今天这批论文工业味很重,三篇里两篇是实打实的线上落地复盘,读起来比刷一堆离线刷榜的论文舒服,但别指望有什么颠覆性方法论——本质都是把已有模型和已有调参流程搬到更靠前的链路去解题。一条主线是「试新和复购怎么平衡」,配送场景那篇把序列模型的输出直接降格成单个标量特征喂给 GBDT,再把多目标约束翻译成样本权重和 label smoothing 去搜 Pareto 前沿,最值钱的其实是它自己坦白的那个结论:离线单目标 MRR 涨了,核心线上指标可能纹丝不动,甚至六个国家里五个倒退。另一条主线是「多样性别等排序阶段再管」,Marketplace 那篇把个性化 cap 压到检索的多源多分片链路上,熵分桶加自动调参流程,额外延迟不到 1ms,最有意思的是 edge-heavy——个性化只在偏好两端有价值,中间那批平均用户纯属白折腾;第三篇讲大规模检索里 swing 计算的高效实现,偏基础工程向,跟前面两篇的叙事不是一路。两篇落地文的毛病也很像:绝对涨幅都是千分位,词表和分桶设计要么是 transductive 要么是拍死的,冷启动和全量重训的运维代价被轻描淡写带过,所以看的时候重点盯实验设计和那些「不显著」的结果,别被标题里的正号骗了。今天优先看前两篇,尤其要细读线上 A/B 的分层结论和作者主动交代的负向结果,第三篇当工具向的补充扫一遍就行。
论文列表
1. Balancing Trial and Reorder: A Hybrid Sequential Transformer-GBDT Ranker for On-Demand Delivery
- 论文链接:AlphaXiv
- 更新时间:2026-09-14 22:25 UTC
- 机构:Wolt (DoorDash, Inc.)
- 工业优先级:强
- 备注:10 pages, 4 figures, 5 tables
外卖排序怎么平衡尝鲜和复购🔍
各位算法同学们,先来个反差点:一个排序模型把尝鲜MRR拉高12%到30%,代价是6个国家里5个复购MRR回退,但上线核心指标Global CVR统计上基本没动。Wolt这篇的看点在于,它把探索/利用这个老问题,在本地即时配送的硬约束下做成了可调、可上线的生产系统,还连做了三场A/B。
📄 Balancing Trial and Reorder: A Hybrid Sequential Transformer-GBDT Ranker for On-Demand Delivery
🔧 双阶段结构:双向Transformer编码器做用户序列建模,输出原始logit,再作为单特征喂给GBDT排序器,融合上下文、用户和门店特征;推理时再套本地配送约束。
🧩 不按品类拆模型:一个国家、全门店、跨餐厅和零售共享一套store词表,UVR直接替掉原来3个餐厅加1个零售共4个排序模型。
⚙️ 把试新/复购写成可调权重:目标端只mask最近一次购买,配合标签平滑和trial偏置样本加权,让尝鲜与复购的权衡能直接调,而不是靠拍脑袋换目标。
📊 离线尝鲜MRR相对生产模型提升+12%到+30%,但6个国家中5个复购MRR回退;混合试新和复购的Global CVR统计上不变。
📈 A/B:V1相对上一版生产排序器 +5.5% Merchant Trial Rate、+0.16% Global CVR。
✅ V2在V1基础上再加+0.45% Merchant Trial Rate;V3跨餐厅和零售统一后再加+1.31% Retail Merchant Trial Rate,三场A/B依次覆盖最大市场、全部运营国家和两个域。
总结感想:这篇对做本地生活、即时零售排序的人更有用,尤其是候选集受距离和运力约束、又背着多目标权重的团队。要盯的不是单一离线MRR,而是能同时混合试新和复购的核心CVR,以及分城市、分域的复购回退;坑在于trial偏置权重是经验调的,换市场或品类得重新校准,否则很容易用复购换尝鲜。
2. PCap: Personalized Retrieval-Stage Diversity Capping in Facebook Marketplace
- 论文链接:AlphaXiv
- 更新时间:2026-09-15 00:16 UTC
- 机构:Meta
- 工业优先级:强
- 备注:5 pages, 2 figures, 3 tables
召回阶段做多样性,VPV只涨0.3%?
各位算法同学们,多样性这件事,很多团队默认放排序阶段做重排最划算,Meta这篇偏把约束往前挪,直接卡在召回。反常识的点是:召回阶段做个性化多样性,既没伤召回量也没拖延迟,线上VPV还涨了0.3088%。这数字单看小得容易被忽略,放在Marketplace这种量级上已经是统计显著的正向。
📄 PCap: Personalized Retrieval-Stage Diversity Capping in Facebook Marketplace
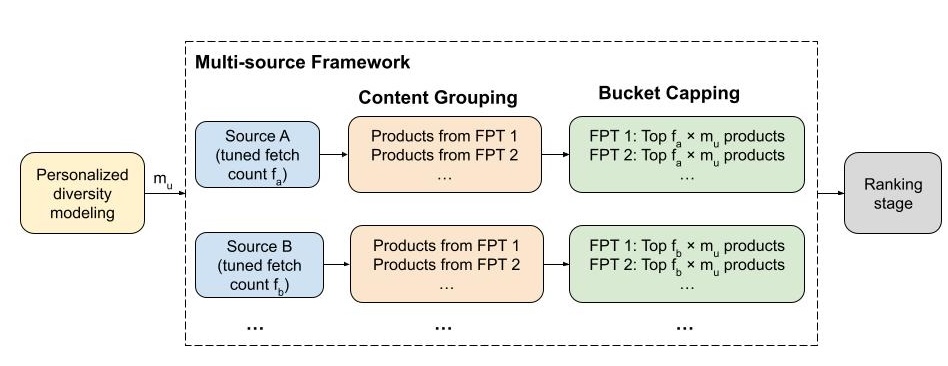
🔧 用Shannon熵给每个用户算多样性偏好分,归一化后切成6个桶,桶1最窄、桶6最杂。这里没选连续分数而是固定桶数,是为了桶内稳定、线上行为可预测、计算开销低。
🧩 用Facebook商品品类FPT做分组键,在每个桶上设个性化上限:上限 = 召回源拉取量 × 源级乘子f_k × 用户桶乘子m_u。偏好窄的用户给松cap,偏好杂的给紧cap。机制同时作用在索引分片扫描和聚合两层,防止单一品类霸占候选集。
⚙️ 每个桶的乘子属于高维参数,靠Parameter Tuning Sequence做在线自动调参,替掉人工网格搜索,能长期跑在生产环境里。
📊 Phase 1对比无cap基线,VPV +0.3088%,说明召回阶段加品类cap确实能让用户看到更杂的内容。
📈 Phase 2对比统一cap(只按买家/非买家分层),衡量个性化带来的增量,结论是个性化多样性主要惠及偏好两端的用户,中间段用户收益有限。
✅ 全程只用线上A/B,没做离线baseline:召回改候选池会引发排序的二阶变化,离线指标测不出来。MMR、DPP这类方法需要全局相关性分数和固定候选集,跟分片召回的形态不兼容。
总结感想:如果你在做召回层的候选池治理,这篇的工程拆解比算法本身更有参考价值——分片加聚合双层cap、桶数固定、在线调参,都是能直接抄的结构。要盯的指标是VPV、PDP、MLI和HHI,同时确认PF延迟没被cap拖累。坑有两个:桶化会牺牲一部分个性化粒度,短活跃用户容易被噪声带偏;另外Phase 2的具体涨幅在可见摘要里没给全,想复现得自己调m_u和各源乘子。
3. Efficient Swing Computation for Retrieval in Large-Scale Recommender Systems
- 论文链接:AlphaXiv
- 更新时间:2026-09-15 08:42 UTC
- 机构:Hong Kong Baptist University
- 工业优先级:未标注
- 备注:23 pages. The technical report for the paper titled “Efficient Swing Computation for Retrieval in Large-Scale Recommender Systems” in SIGMOD 2027
Swing检索提速千倍,只要近似
各位算法同学们,先甩个数字:十亿边的图做 top-100 Swing 查询,精确方法要 8.5 秒,这篇 K-ASC 只要 1.5 毫秒,平均精度还超过 99.9%。Swing 是阿里、快手、Shopee 都在用的 i2i 召回相似度,但它的计算复杂度是查询物品度数的平方,热门物品挂几万个用户,一次查询就要枚举上亿对用户,这篇工作就是来拆这个开销的。
📄 Efficient Swing Computation for Retrieval in Large-Scale Recommender Systems
🔧 把问题重定义成 (ε, λ) 近似 Swing 查询:Swing 值高于阈值 λ 时给相对误差 ε,低于 λ 只要求 ε·λ 的绝对误差,不是所有目标物品都要算准,误差边界写得很清楚。 🧩 ASC 把 GNS 和 USS 两个随机估计器拼到一起:GNS 用分组去掉重复的用户对交集,USS 干脆不做交集、只估基数,再按代价模型自适应地给高/低度数查询物品选估计器。 ⚙️ K-ASC 走 filter-refinement:先用一部分采样预算粗估候选、维护上下界,挑出 top-K 候选和边界物品,再把剩余预算全砸在边界物品上细化排序,配合位图剪枝。
📊 8 个真实数据集上,达到同样的 (ε, λ) 近似保证或相当的 top-K 排名精度时,ASC 和 K-ASC 的计算时间比精确法和 Monte-Carlo 基线快几个数量级。 📈 最大的 MAG 图上,K-ASC 做 top-100 查询平均精度超过 99.9%,耗时 1.5 毫秒,精确方法要 8.5 秒。 ✅ 亿级边的 Yambda 和 MAG 上 K-ASC 仍然跑得动,不只是中等规模图上的结果。
总结感想:如果你的 i2i 召回就是 Swing,被热门物品的度数卡住,或者现在靠截断用户数硬扛,这篇的误差定义和 filter-refinement 可以直接对标,重点看你在意的 λ 处精度掉多少、P99 延迟能压到哪。坑有两个:一是它给的是概率误差保证,ε、λ、δ 得跟着线上召回质量调;二是 GNS/USS 的切换依赖代价模型里的经验参数 ρ,换数据集先校准,不然自适应可能选错估计器。