推荐算法日报 · 2026-09-13
总览
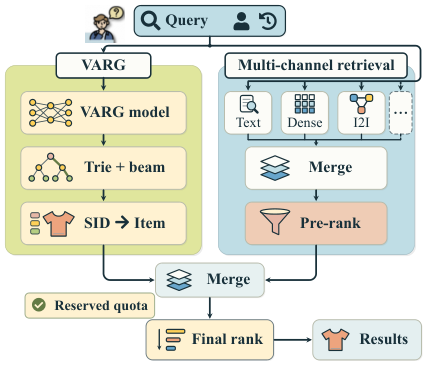
今天这批只有两篇,量少但主题出奇地集中,都在啃生成式召回这条线,而且都指向同一个焦虑:生成出来的东西到底能不能信。最值得细读的是那篇电商搜索的 VARG,它不是实验室里的玩具,是天猫搜索真上线的通道,生成候选直接拿预留配额绕过粗排塞进最终排序器,14 天 20% 流量的 A/B 拿到 GMV +1.45%,这个涨幅在电商搜索里相当能打。它真正有意思的地方不在模型结构,而在那套 SID 设计——第三层不靠聚类、直接按经验贝叶斯平滑后的转化率排序,等于把商业价值先验焊进了语义 ID,后面的序数监督和 prefix 加权 GRPO 都是在给这个价值排序兜底。另一篇讲 retriever 需要 verifier、做通用生成式重排的,其实是同一个问题的另一面:光有强生成不够,还得有人验,两篇放一起读能凑出一套完整的「生成—校验」视角,可惜这篇我这边摘要信息不全,只能先记个位置。要挑刺的话,VARG 那堆手调的系数和层级权重、以及直接拿生产精排分数当 advantage 的奖励设计,长期有把自己喂成回声室的风险,增量时共享 SID 在服务端展开也会让候选膨胀、映射出现歧义。所以今天优先看 VARG 那篇,重点抠它的 SID 构造和增量方案,再把第二篇的 verifier 思路顺带补上。
论文列表
1. VARG: Value-Aware and Ranking-Aligned Generative Retrieval for Dynamic E-commerce Search
- 论文链接:AlphaXiv
- 更新时间:2026-09-13 12:59 UTC
- 机构:未披露机构
- 工业优先级:强
- 备注:11 pages, 4 figures, 7 tables
天猫搜索跳过粗排,生成式召回涨GMV
各位算法同学们,生成式召回不一定只能待在召回层——VARG 把生成的 item 直接塞进天猫现有精排,跳过 item 级粗排,14 天线上 A/B 把 GMV 拉高了 1.45%。粗排漏掉的商品精排是救不回来的,所以这篇真正动的是「候选配额」这件事。
📄 VARG: Value-Aware and Ranking-Aligned Generative Retrieval for Dynamic E-commerce Search
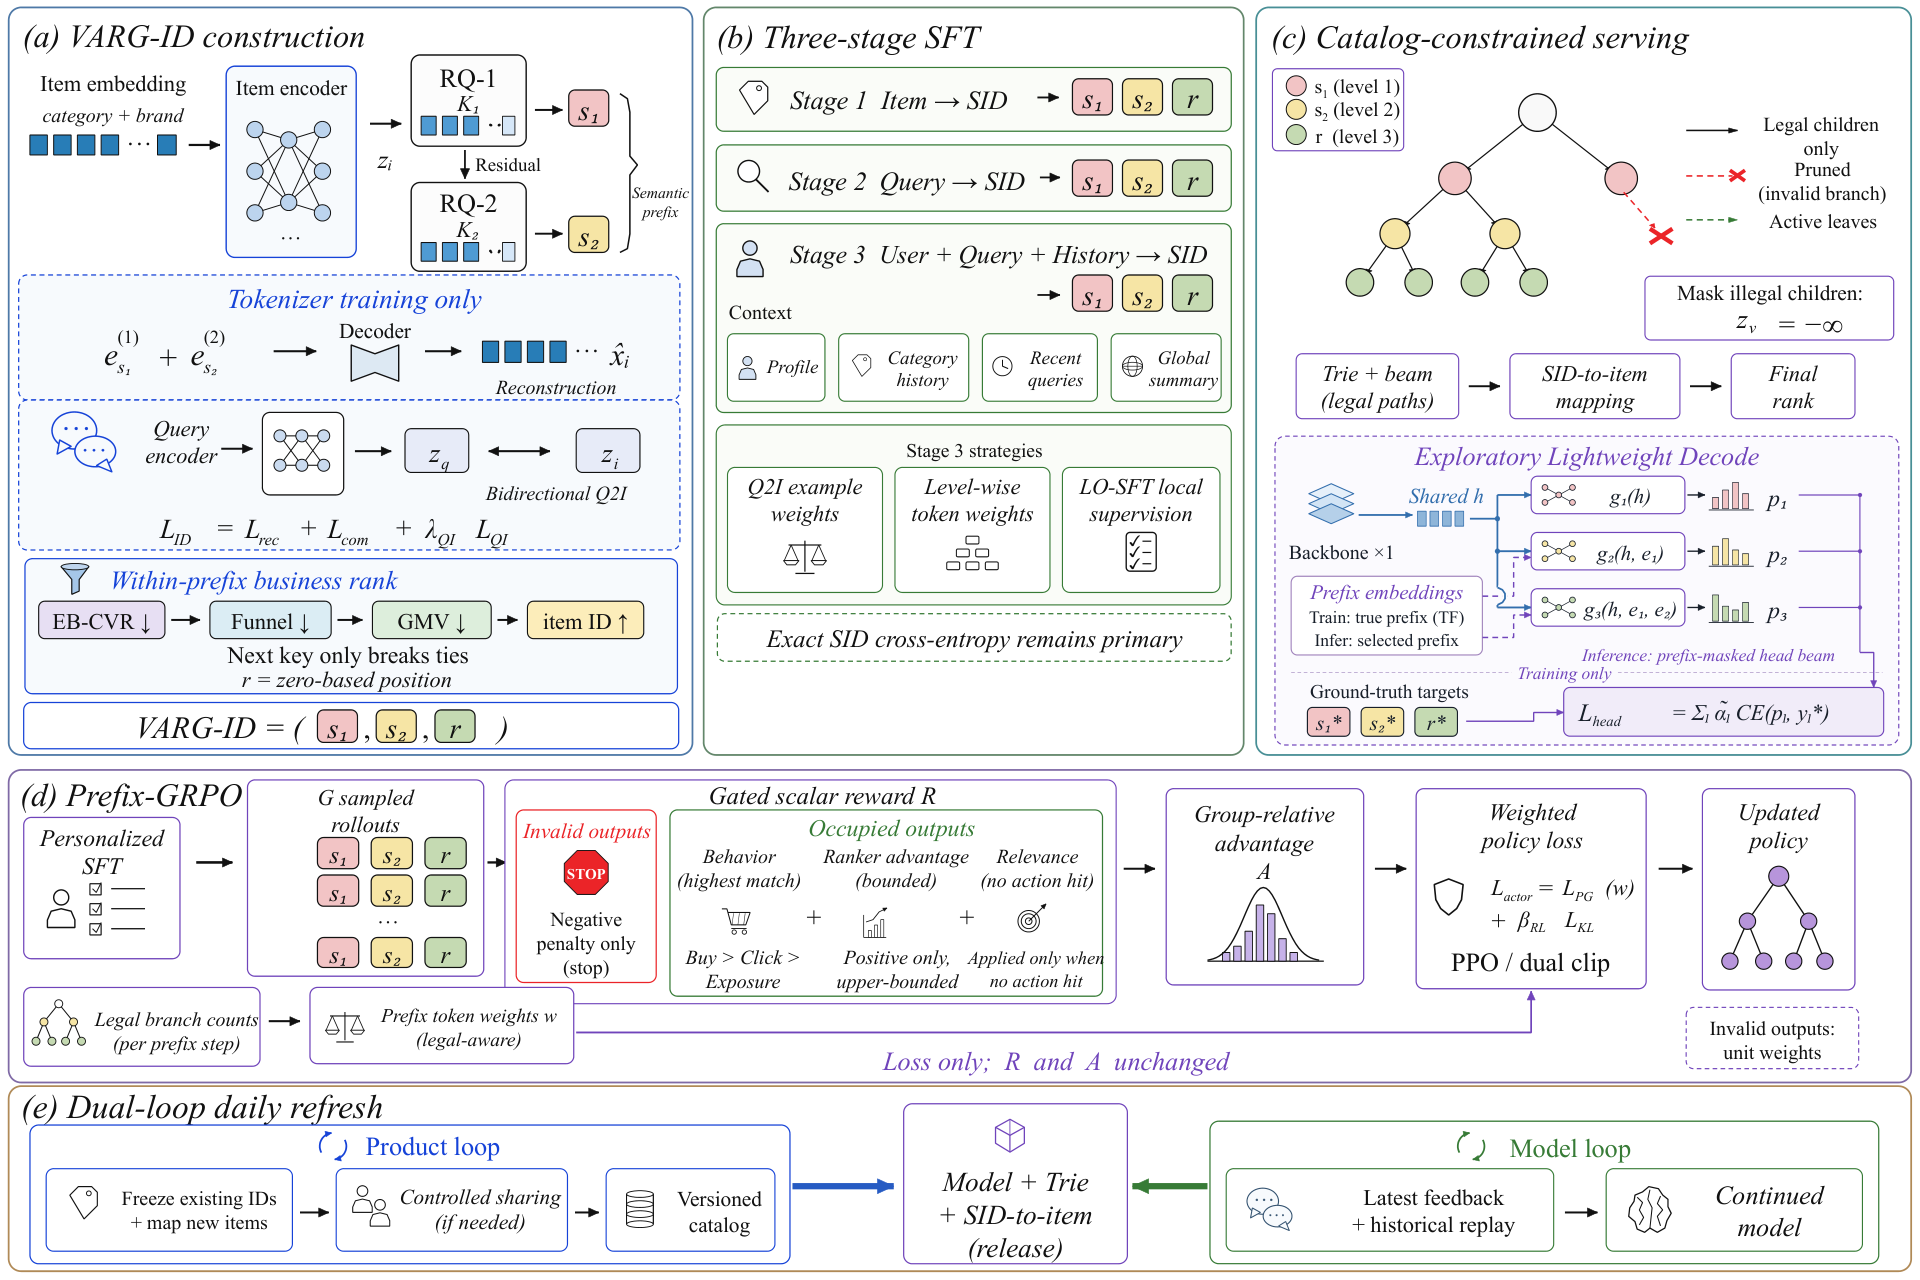
🔧 VARG-ID 用 RQ-VAE 造语义前缀,再用双向 query-item 对比学习把搜索相关性灌进前缀;第三个 token 用经验贝叶斯 CVR 做价值排序,但只用来打破同簇平局,item 地址不会随每天的统计波动漂移。
🧩 三阶段 SFT 从 item→SID、query→SID 一路走到个性化,叠加 Q2I value 加权、SID level-wise 监督和扩展用户上下文,再用 LO-SFT 显式学第三个 token 编码的簇内序。
⚙️ Prefix-GRPO 把 SID 合法性、用户行为、ranker advantage、搜索相关性做成门控奖励,非法输出只吃负分,再配 prefix-aware token 权重;工程上商品侧冻结旧 ID、只映射新商品,模型侧做行为回放,日更不打断已学到的地址关系。
📊 离线在千万级商品上验证了标识稳定性,SFT 和 Prefix-GRPO 相对各自 baseline 在召回质量、头部价值召回上均有提升。
📈 线上 14 天、覆盖 20% 搜索流量的 A/B:GMV +1.45%,人均 IPV +0.22%,PCTR +0.31%。
✅ 导购类 query 上,用更小的候选配额也保持了有竞争力的相关性。
我的判断:适合已经跑通 SID 召回、精排够强、还敢给生成通道留固定配额的团队;如果精排本身对长尾价值不敏感,收益会打折。要盯的是头部价值召回和非法 SID 输出率,不是生成准确率——配额被低价值 item 占满,GMV 立刻掉。跟 CQ-SID、CRID 这类工作比,差异点在第三 token 的稳定性设计,以及把 ranker advantage 直接写进奖励。
2. Recommendation Retrievers Need Verifiers: Universal Generative Reranking for Sequential Recommendations
- 论文链接:AlphaXiv
- 更新时间:2026-09-10 22:56 UTC
- 机构:未披露机构
- 工业优先级:未标注
🧩冻结召回器,加个验证器就能涨召回
各位算法同学们,召回模型一冻结、什么都不重训,Recall@10 反而涨了——靠的不是调参玄学,而是给第一级后面挂了一个轻量生成式验证器。这篇来自 Meta MRS 的工作,把”draft-then-verify”从 LLM 解码搬到了推荐召回,最省事的地方在于它不碰你的索引。
📄 Recommendation Retrievers Need Verifiers: Universal Generative Reranking for Sequential Recommendations
🔧 结构上借了投机解码的壳:召回器当 drafter 完全冻结,只训一个小型生成式 verifier,用候选 item 的 identifier token 自回归似然打分,再和召回分数做 RRF 融合,召回器原顺序兜住尾部。
🧩 训练目标就是 next-token 交叉熵,teacher forcing 下每个前缀都贡献监督(O(BT) 条),不需要采样负样本、不需要候选池,因此没有对比学习那种对 batch 和 pool 大小的敏感。
⚙️ 接口刻意收窄:只吃冻结召回状态经 stop-gradient 投影后的 conditioning,加上 top-K 池和固定 token 化。不做特征 join、不做候选间交互、不重建索引,语义 ID 和 hash ID 可插拔,换 tokenizer 不用改这套 draft-verify 接口。
📊 Amazon 商品推荐和 YaMBDa 音乐推荐上,同一套 verifier 配方让 SASRec、GRU4Rec、NextItNet、MiniOneRec 的 Recall@10 全线提升。
📈 YaMBDa 在 50M、500M、5B 三个交互规模上每个 drafter 都涨,而且目录越大相对提升越明显。
✅ 消融里的 content control 很关键:把同样的内容表征直接喂给召回器,复现不出这个增益,说明涨点来自输出侧的生成式验证,而不是简单灌内容特征。
总结一下判断:对已经在跑多级架构、又不想动召回模型和索引的团队,这是成本可控的一招。但收益只体现在小截断的前缀覆盖率上,盯的是 Recall@10 这类小 k 指标,别指望它改善全库召回。坑在于验证器只能从 top-K 池里挑人,池子里没有的相关 item 它救不回来,K 设小就直接封顶;另外 RRF 的融合权重和 verifier 容量得跟着目录规模调。