推荐算法日报 · 2026-09-14
总览
今天这两篇都是很典型的工业界问题,一篇啃超长用户序列怎么塞进排序模型,一篇啃电商 query 到品牌实体的映射,共同点是都没什么花哨的新架构,全靠对场景的理解硬抠工程细节。ChronicleRec 是今天最值得细读的一篇,它接着 VISTA 那套「历史压一次、所有候选复用」的 target-independent 路线往下走,但把 query token 按时间锚点插进序列做因果编码,再配一个 mask-and-predict 的对齐预训练,硬是把跟 Full-Attn 的 GAUC 差距压到 0.002 上下;这个幅度的增益说实话得反复跑才能确认不是噪声,好在消融给得够诚实,能看清真正干活的是对齐预训练和因果交错这两块,而不是那套多粒度合并的包装。Amazon 那篇品牌实体链接更偏落地,经典两段式和端到端极端多分类两条路都试了,最有意思的是拿 query 品类去跟品牌历史曝光品类做匹配消歧、收敛不了就干脆不预测——这个 precision-first 的取舍很电商,但离线数字漂亮归漂亮,线上 engagement 和利润的增益薄得几乎可以忽略,属于方向对、收益慢的活。所以我的判断是:想学序列建模怎么在成本和效果之间找平衡的,去看 ChronicleRec 的消融和预训练目标设计;做电商搜索的,重点翻品牌链接那篇的错误分析,73% 的错集中在缩写和隐式引用上,这个结论比模型本身更有用。今天优先看 ChronicleRec,品牌链接那篇当工程参考扫一遍就够了。
论文列表
1. ChronicleRec: Pre-training Temporally Anchored Tokens for Lifelong User Modeling
- 论文链接:AlphaXiv
- 更新时间:2026-09-11 02:47 UTC
- 机构:未披露机构
- 工业优先级:强
超长用户序列压成可缓存token 🧩
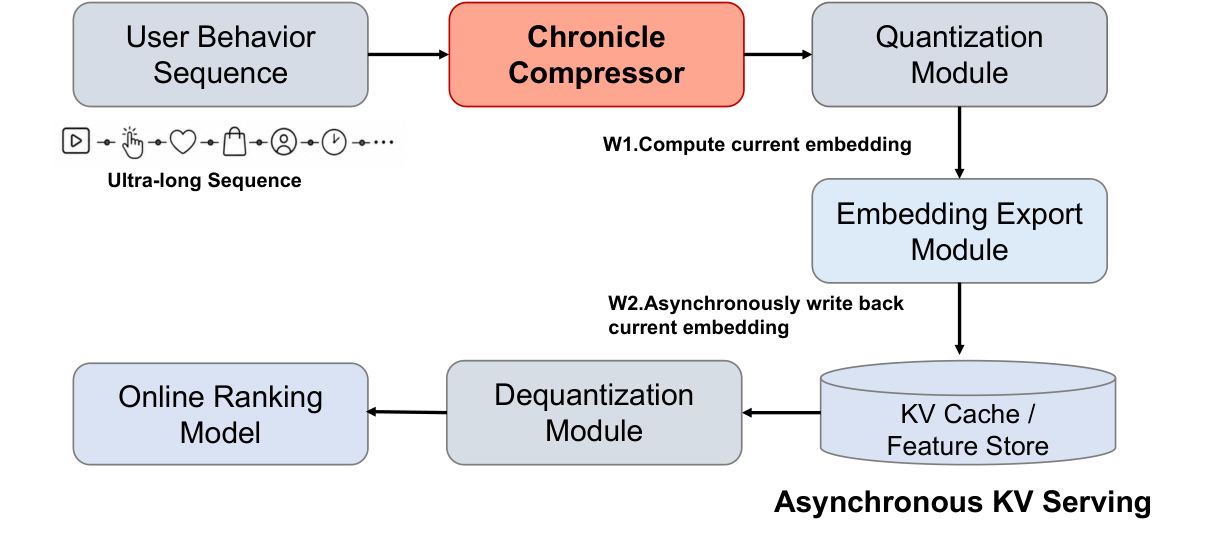
各位算法同学们,把用户上万条历史直接喂进排序模型,延迟扛不住;截断到最近几百条,又悄悄把长周期兴趣丢了。这篇的做法是离线把超长行为序列压成一串可缓存的token,线上按候选打分时不再碰原始长序列。
📄 ChronicleRec: Pre-training Temporally Anchored Tokens for Lifelong User Modeling
🔧 不走SIM那套「按候选检索」:token是target-independent的,一个用户算一次就能缓存复用,长序列编码和候选打分彻底解耦,线上走异步KV,当前embedding异步算、异步写回。
🧩 关键差别在压缩姿势。不是把query token全堆在序列尾部再双向读一遍,而是把query token按时间位置插进行为序列,用因果encoder让每个token只总结它锚点之前的历史;输出本身就是一条按时间排好的短token序列,不是一袋无序摘要。
⚙️ 粒度上做recency-aware多粒度merge:近端细、远端粗,按递增步长池化;再加multi-horizon多分支,每个分支遮掉不同长度的近期窗口,逼不同分支负责不同时间尺度。预训练用mask-and-predict,把最近行为挖掉、只用压缩后的远期历史去重建,让历史表示对齐当下意图。
📊 离线在KuaiRand和Tencent AdLive上,稳定优于recent-window和single-pass compression基线,同时逼近full-attention的表现。
📈 token层面的分析显示表示是按时间组织且互补的,不是冗余一团。
✅ 线上跑了7天A/B,论文称生产指标有显著提升。
总结感想:这套思路最适合做工业推荐/广告排序、长序列特征已经卡在延迟上的人。要盯三个点:压缩token数量和延迟的trade-off、离线逼近full-attention还差多少(这个差距就是信息损失上限)、缓存过期和异步回写的一致性。和SIM、VISTA比,它换的是「不按候选检索」加「有序因果摘要」,代价是预训练多一层对齐阶段,缓存刷新策略得自己设计。
2. Query Brand Entity Linking in E-Commerce Search
- 论文链接:AlphaXiv
- 更新时间:2026-09-09 08:14 UTC
- 机构:Amazon
- 工业优先级:强
- 备注:Accepted by CIKM
电商搜品牌,字符串匹配不够用了🔍
各位算法同学们,电商搜索里 query 平均只有三到四个词,品牌却有几十万个,靠字符串匹配认品牌,碰上缩写、跨语言写法、父子品牌就开始翻车。亚马逊这篇把它当成品牌实体链接来做,关键是两套方案都上了线,不是纯离线刷分。
📄 Query Brand Entity Linking in E-Commerce Search
🔧 两阶段级联:先用 MetaTS-NER 做序列标注抽出品牌 mention,再拿候选去品牌知识库匹配消歧,中间用 query 预测出的 product type 做过滤,在几十万品牌空间里把候选收窄。
🧩 端到端极端多分类:干脆跳过 mention 检测,用 PECOS 直接把 query 映射到品牌 ID,把链接写成百万级标签的分类问题,靠层级聚类和稀疏结构把推理压下来。
⚙️ 融合:两路互补,级联保精度,端到端补召回,最后作为一个 fused 方案部署。
📊 离线在 11 种语言上做了评测,多语言泛化是重点考察项,不是只测英语。
📈 线上做了受控 A/B:brand recall 明显提升,precision 维持在较高水平,customer engagement 有可测增益。具体涨幅论文没披露,只有定性表述,这点得注意。
✅ PECOS 在 1 亿类别空间下单 query 推理低于 5ms,这是它能上线的关键前提。
想跟的话:做电商 query 理解、属性抽取的可以精读,重点看它怎么用 product type 约束消歧。要盯的指标是 recall 涨了多少、precision 有没有掉,以及新增长尾品牌能不能被覆盖。坑在于两套方案都吃内部 NER 模型和品牌知识库,这部分论文里没有,复现门槛主要卡在数据和标注,不在模型结构。