推荐算法日报 · 2026-09-12
总览
今天这批五篇基本压在两条主线上:一条是想办法把外部信号更聪明地塞进推荐模型,另一条是生成式推荐真正落地时的推理效率。前一条里,联邦推荐那篇和知识图谱自适应融合那篇其实是同源的思路——都在质疑「所有客户端、所有节点一视同仁地聚合」这件事,一个换聚合对象、一个给节点打门控,方向都站得住,但前者涨点普遍只有 1~3 个点、所谓 utility 本质还是重建误差的负梯度,后者的实验数字在正文里根本没给全,读的时候得多留个心眼。P3Rec 是这批里设计最巧的一篇,prior/posterior 双路蒸馏再加门控监督那条链路很干净,但消融也把话说透了:LLM 推理是锦上添花,协同行为信号才是地基,别指望它单独救场。真正让我眼前一亮的是 OneLA,它不追新范式,就死磕大 beam 解码时线性注意力状态膨胀这个具体到不能再具体的 serving 痛点,projection replay 把状态读写从矩阵级压到向量级的观察很漂亮,加速和显存数据也实在,问题是它成立的前提就是输出只有 3~7 个 token,序列一长优势就被 replay 深度吃掉,而且全程没有线上验证。跨阶段多任务融合那篇目前只看到标题和出处,内容先挂着,整体看今天属于「稳中偏工程」,没有颠覆性工作但有几篇值得动手复现。建议优先精读 OneLA,其次 P3Rec,KG 融合那篇快速扫一遍思路就够了。
论文列表
1. FedHUR: Learning Hierarchical Utility-Guided Client Relations for Personalized Federated Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-09-10 14:42 UTC
- 机构:Fudan University,Microsoft Research Asia,Independent
- 工业优先级:中
联邦推荐还在算相似度?这篇换了思路 🔧
各位算法同学们,联邦推荐里聚合权重这件事,主流做法是算 client 之间的参数相似度,像就多聚合。但 FedHUR 这篇提了个挺直接的质疑:相似的 client 未必对你有用,而且拿一个全局关系去描述两个用户,本身就概括不了他们在不同品类上的关系。
📄 FedHUR: Learning Hierarchical Utility-Guided Client Relations for Personalized Federated Recommendation
🔧 聚合对象换成 item-item filter。不比整个参数空间,而是在 item 图上做滤波,从滤波结果反推哪些 item 还缺外部信息,把关系构建和聚合统一到同一个对象上。
🧩 关系做成层级。先把 item 聚成粗粒度组算 coarse filter,再在每组内切细粒度算 fine filter,细粒度关系继承粗粒度的信息。好处是避免在只有少数用户交互过的稀疏 item 上硬算关系,减少噪声和冲突。
⚙️ 权重由 utility 决定,不由预定义假设决定。client 上传 utility signal,server 据此召回候选再训 scorer 打分,归一化成聚合权重,衡量的是聚合后预测能不能变好。作者也强调这样不用反复做聚合加验证,省计算和通信。
📊 实验覆盖 5 个真实数据集,FedHUR 一致优于现有联邦推荐 baseline,没有哪个数据集掉点。
📈 摘要只给了 consistently outperforms 这种结论,逐数据集的涨幅在正文实验表里,我看到的版本被截断了,具体数字得自己去论文里核。
✅ 跟 FedCA 的相似加互补、FedRAP 的共享加个性化分解比,差别在于关系不是先验给的,是拿聚合后的效用反推出来的。
总结:如果你在做 personalized federated recommendation,尤其是还在用参数相似度定权重,这篇可以直接拿来当对比基线。要盯两个指标,一是逐 client 的个体指标而不是全局平均,二是候选检索和 scorer 训练带来的额外开销。坑在于层级粒度怎么切是超参,层数和组大小换数据集大概率要重调;另外 server 端多了一个 scorer 要训,权重分布稳不稳得自己验。
2. P3Rec: Distilling Prior–Posterior Preference Reasoning for LLM-based Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-09-12 15:10 UTC
- 机构:Chongqing University of Technology,Peking University,Chongqing University
- 工业优先级:中
先验后验都蒸,推荐才不偏科
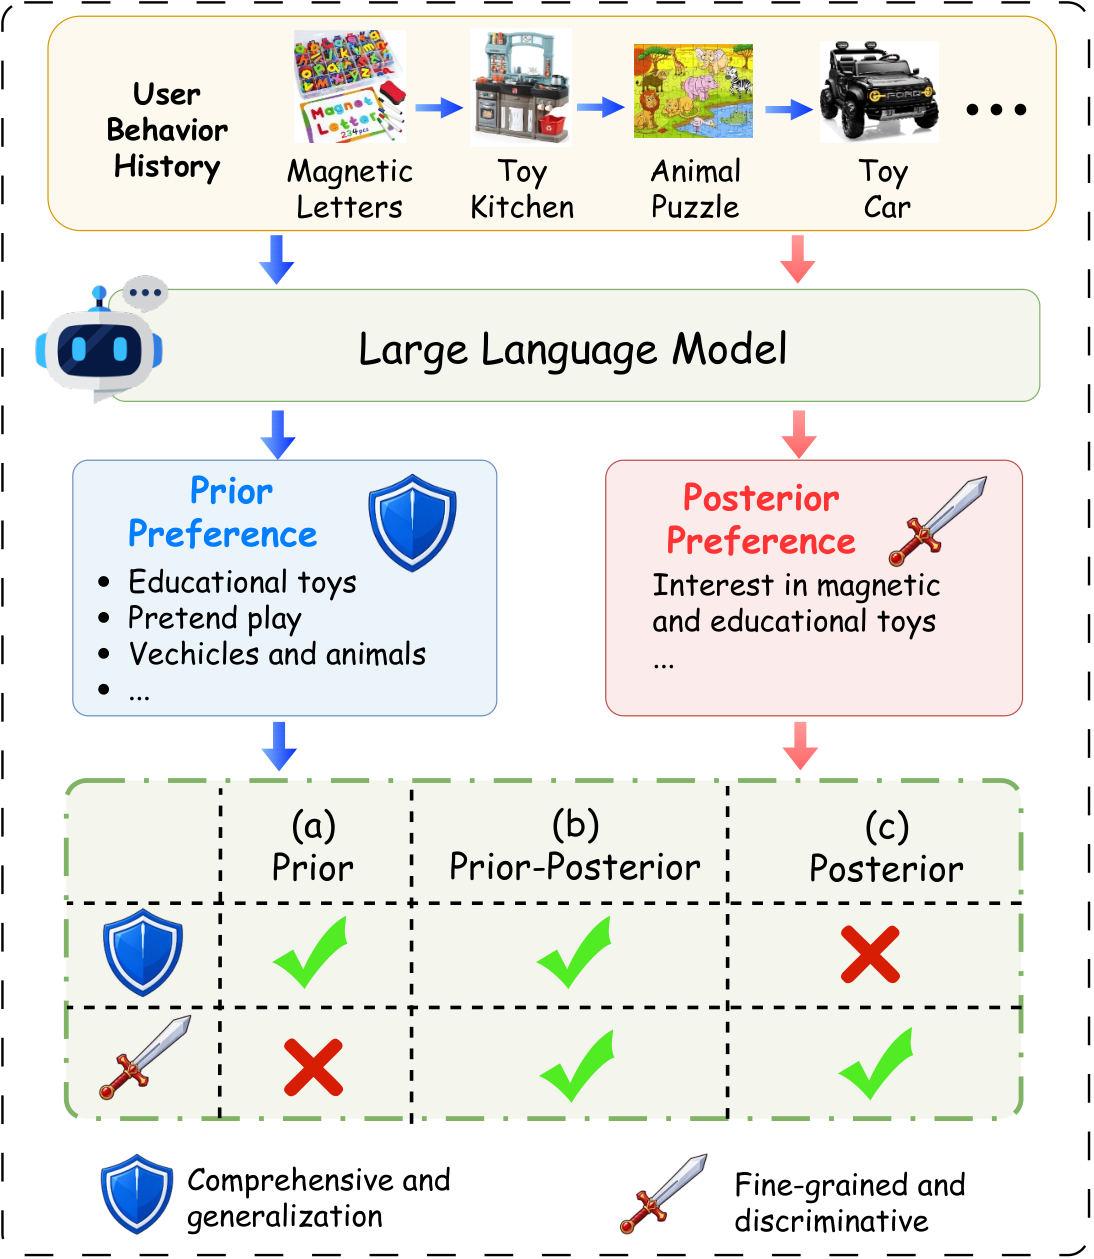
各位算法同学们,只蒸馏一种偏好,学生模型就永远学不全老师的推理——这篇的出发点就这一句。现有 LLM-as-Enhancer 要么只做 target-agnostic 先验(稳定但指导不了当前决策),要么只做 target-conditioned 后验(细粒度但容易靠 target 抄近路),P3Rec 干脆把两边一起蒸。
📄 P3Rec: Distilling Prior–Posterior Preference Reasoning for LLM-based Recommendation
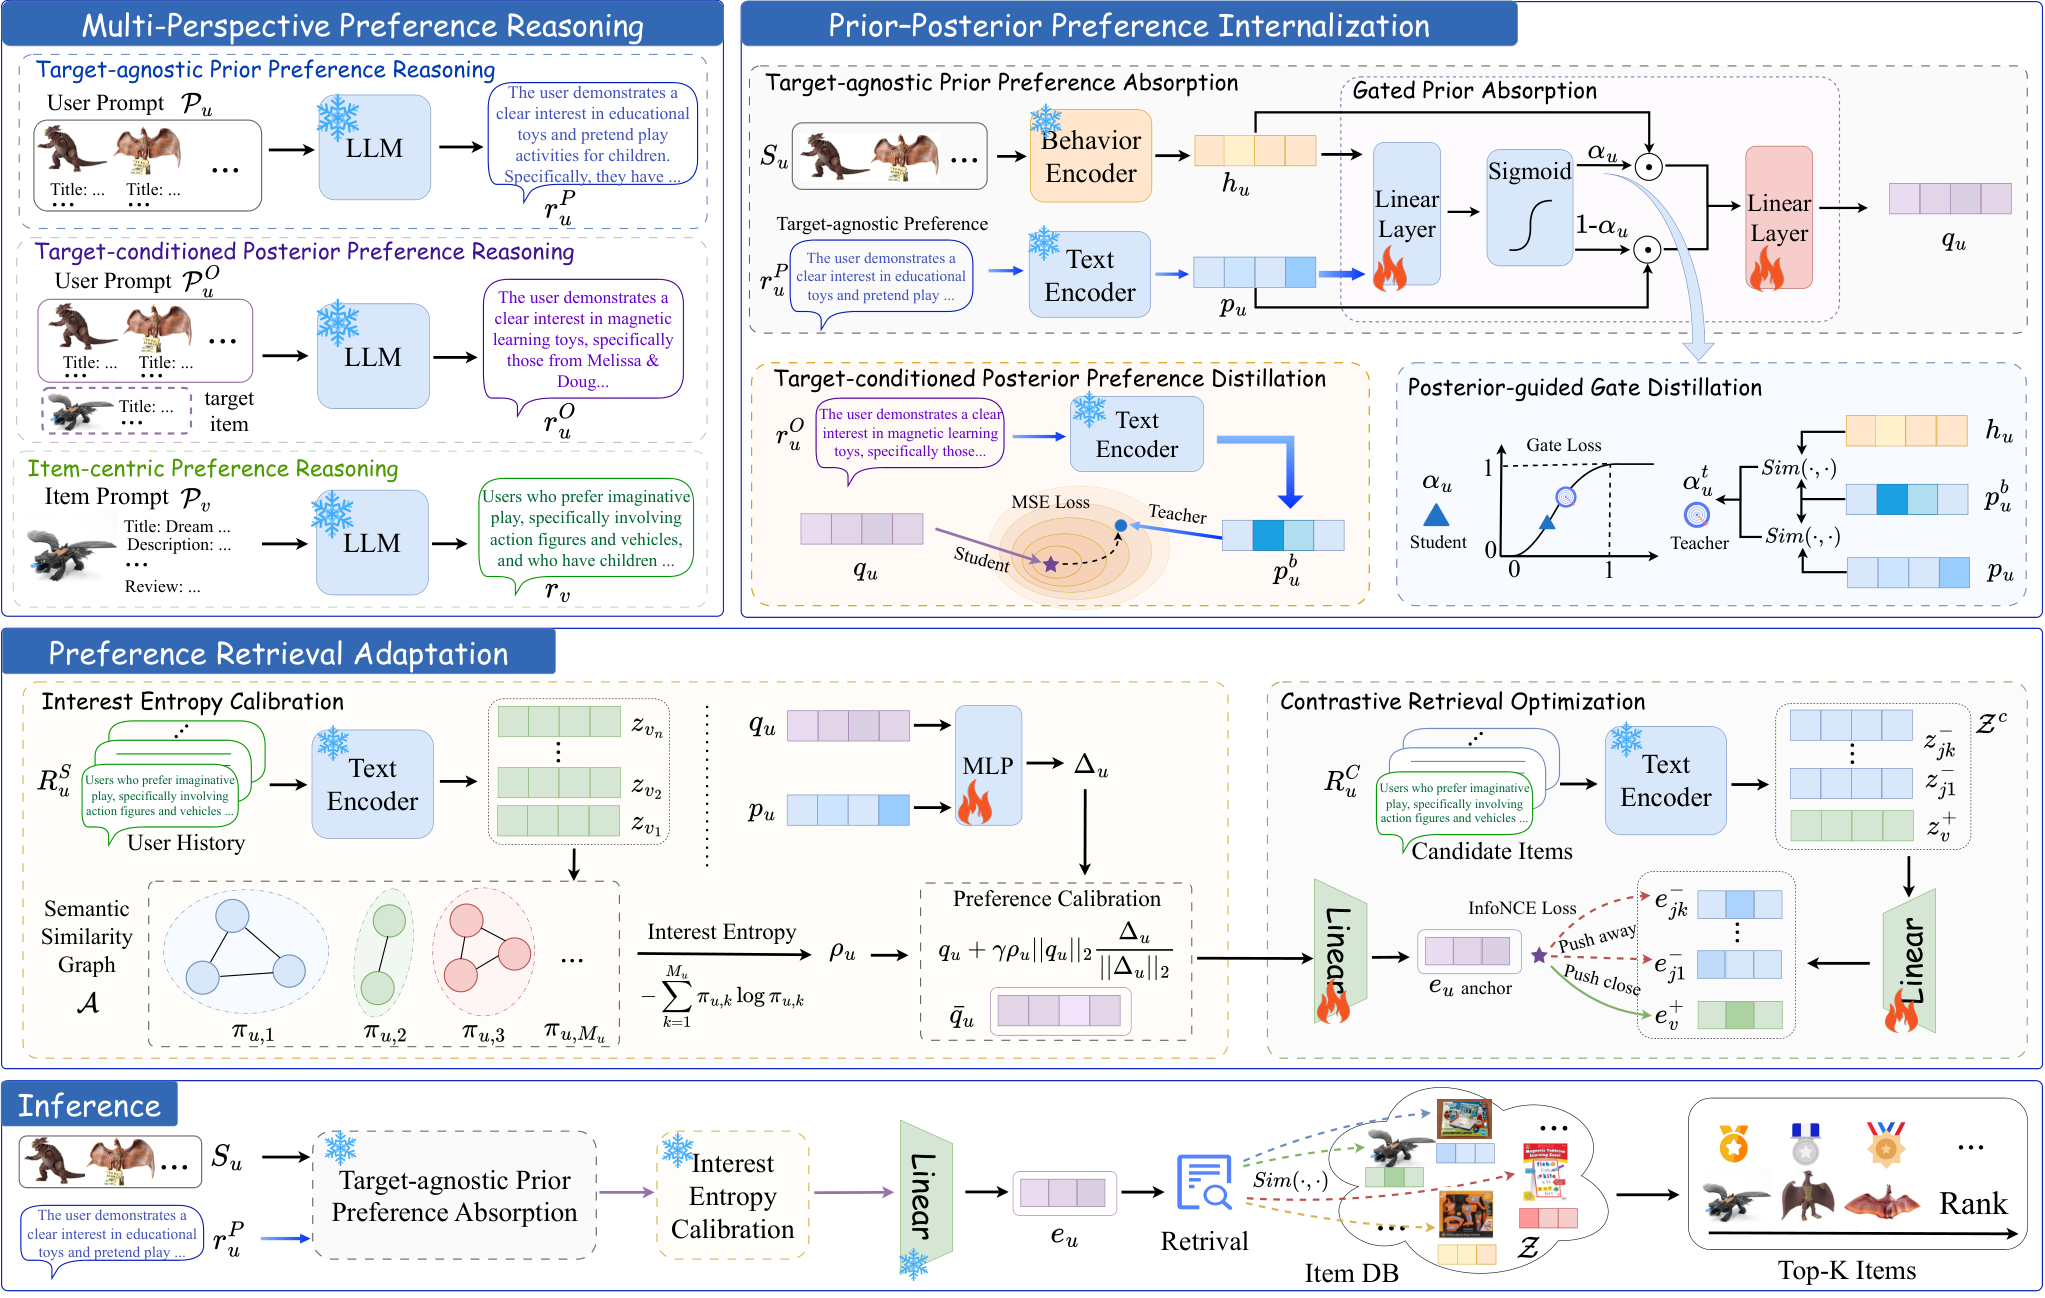
🔧 多视角偏好推理:用户侧同时抽 target-agnostic 先验和 target-conditioned 后验,再从 item 语义加前驱交互里抽 item 侧偏好表示,补上物品端视角。
🧩 渐进式内化:先从行为表征里选择性吸收先验,再用后验去指导这个吸收过程,最后把 target 相关的偏好蒸进用户表征,让行为和偏好知识同时保留。
⚙️ 兴趣熵校准:综合表征不一定指向一个明确的检索方向,历史兴趣越分散越明显;论文用 interest entropy 刻画分散度,自适应控制一个可学习残差来校准用户表示,再做对比检索优化。
📊 多个公开数据集上一致超过现有 SOTA,对比的基线覆盖 RLMRec、LLM-ESR、R2END 这类 LLM-as-Enhancer 路线。
📈 全程离线蒸馏,线上依然是轻量推荐器,不引入在线 LLM 推理开销,这点对落地比涨点更关键。
✅ 我看到的版本实验表格被截断,具体提升幅度没法写死;读的时候先盯 NDCG@10、HR@10,以及和 R2END 的逐数据集差值。
总结感想:做 LLM-as-Enhancer 和蒸馏方向的同学可以直接跟。要留意的坑有两个,一是后验偏好用到了 ground-truth next item,训练时很容易退化成 target shortcut,得看消融能不能证明它不是在泄露标签;二是 interest entropy 的校准到底贡献多少,复现时建议单独关掉这一路验证。如果只挑一个指标看,先看长尾和兴趣分散用户切片上的 NDCG。
3. OneLA: Scaling Linear-Attention Decoding to Large Beams in Generative Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-09-11 03:41 UTC
- 机构:The University of Hong Kong,Kuaishou Technology,Peking University
- 工业优先级:中
🚀大beam解码别再逐个存状态
各位算法同学们,beam width 涨到几百之后,线性注意力省下来的显存又被吃回去了——每个beam一份完整递归状态,每步解码还要整体读写一遍。OneLA 想说的是:这些状态本来就是冗余的。
📄 OneLA: Scaling Linear-Attention Decoding to Large Beams in Generative Recommendation
🔧 一个请求只保留一份 prompt prefill 后的共享状态 S_ctx,beam 之间的差异用 append-only 的 GDN Transition Records(GTR)紧凑记录,不再为每个 beam 物化完整的递归矩阵。
🧩 解码时不做状态重建,只把 GTR replay 到当前 step 真正用到的两个投影上,开销从矩阵级降到向量级,也没有 per-beam 状态写回。
⚙️ 用轻量 ancestry index 把 beam 的逻辑演化和记录的物理位置解耦:beam 选择只改引用、不改记录;再加一个 fused shared-context GPU kernel,在片上复用共享状态完成 replay。
📊 在快手工业 GR 负载上,端到端 decode 相比现有 GDN 执行路径加速 1.54–2.46×。
📈 recurrent-state 显存占用和数据搬运量同时下降,而这两项正是大 beam 场景的主要瓶颈。
✅ replay 深度被 SID 序列长度 bound 住,GR 里 prompt 长度和 beam 宽度都远大于 SID 长度,这个置换是划算的。
总结:最直接受益的是做 GR 推理、上 GDN 这类线性注意力加大 beam 解码的团队。要盯的不是吞吐峰值,而是 beam 拉宽后的端到端延迟和显存曲线,对比基线就是 vLLM 的 FullState 和 ReplaySSM 两条路。坑在于它依赖 prompt 共享、后缀短这个前提,如果 beam 之间前缀分歧出现得很早,或者你要跨请求复用状态,收益会打折。
4. Do All Nodes Benefit Equally from Knowledge Graphs? Adaptive Node-Aware KG Fusion for Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-09-05 06:03 UTC
- 机构:Soongsil University
- 工业优先级:中
- 备注:12 pages, Accepted at CIKM 2026
所有节点都该吃知识图谱吗🤔
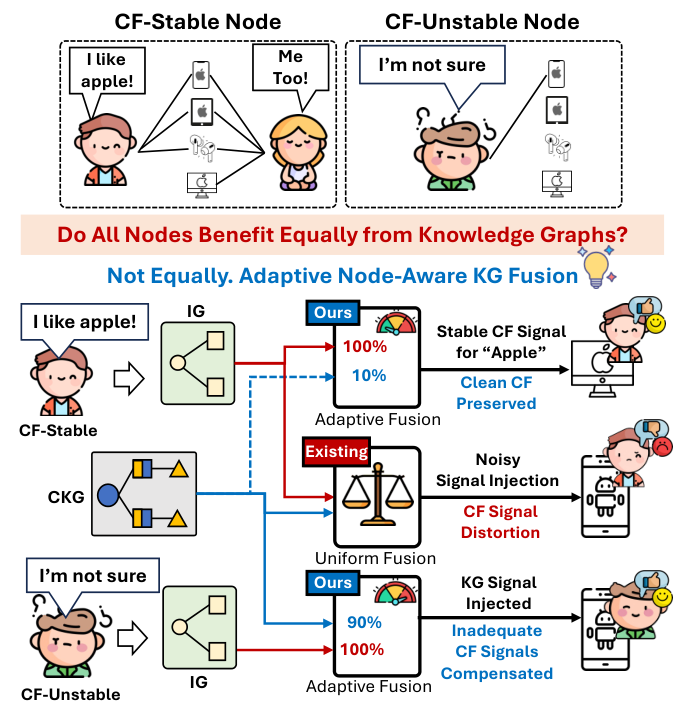
各位算法同学们,知识图谱不是加得越多越好:对CF信号本来就靠谱的节点,硬塞KG反而是在给它添乱。这篇来自Soongsil University、挂在CIKM ‘26的工作,把“每个节点到底该吃多少知识”变成了一个可量化的问题,思路比常见的“用注意力挑邻居”更靠上一层。
📄 Do All Nodes Benefit Equally from Knowledge Graphs? Adaptive Node-Aware KG Fusion for Recommendation
🔧 双视图分开编码:IG和KG各用一套编码器,不让KG在传播过程中顺手动到协同过滤信号,这是它和KGAT一类在CKG上统一传消息的做法最本质的差别。
🧩 用“稳定性”决定KG权重:对每个节点的CF表示做小幅对抗扰动,看它稳不稳;越不稳说明CF证据越不足,就分配越大的KG贡献,而不是简单按交互度数或长尾与否来切。
⚙️ 先对齐再融合:把IG和KG嵌入投到共享空间做自适应对齐,再按节点级依赖度加权融合,融合强度是逐节点的,不是全局一个超参。
📊 论文在四个真实数据集上和主流KG-aware方法做了对比,结论是整体表现更优。
📈 消融单独验证了“节点级自适应融合”这一策略本身有效,而不是靠编码器或对齐模块蹭出来的增益。
✅ 代码和数据集已开源在GitHub(ssu-dmlab/AdaKG),复现路径比较清楚。
⚠️ 摘要只给了定性强结论,没放具体提升数字。想看它比KGAT、KGIN、KGCL这些强多少,得直接翻正文表格,重点看按度数分层之后的结果。
总结:这篇适合正在做KG推荐、又隐约觉得“uniform fusion”不太对的同学,冷启动和长尾场景优先看。判断它管不管用,别只盯整体Recall/NDCG,要看尾部节点涨了多少,同时确认CF本来就稳的那批节点指标有没有掉——掉了就说明扰动估计出来的稳定性打分没分对。落地前还要算笔账:对抗扰动估计是额外开销,扰动率和节点权重的校准方式,是这套方法最容易翻车的地方。
5. UniRec: Cross-stage Multi-Task Fusion with Preference Alignment for Cascaded Recommender Systems
- 论文链接:AlphaXiv
- 更新时间:2026-09-10 03:54 UTC
- 机构:Kuaishou Technology
- 工业优先级:未标注
粗排把精排喜欢的筛掉了😅
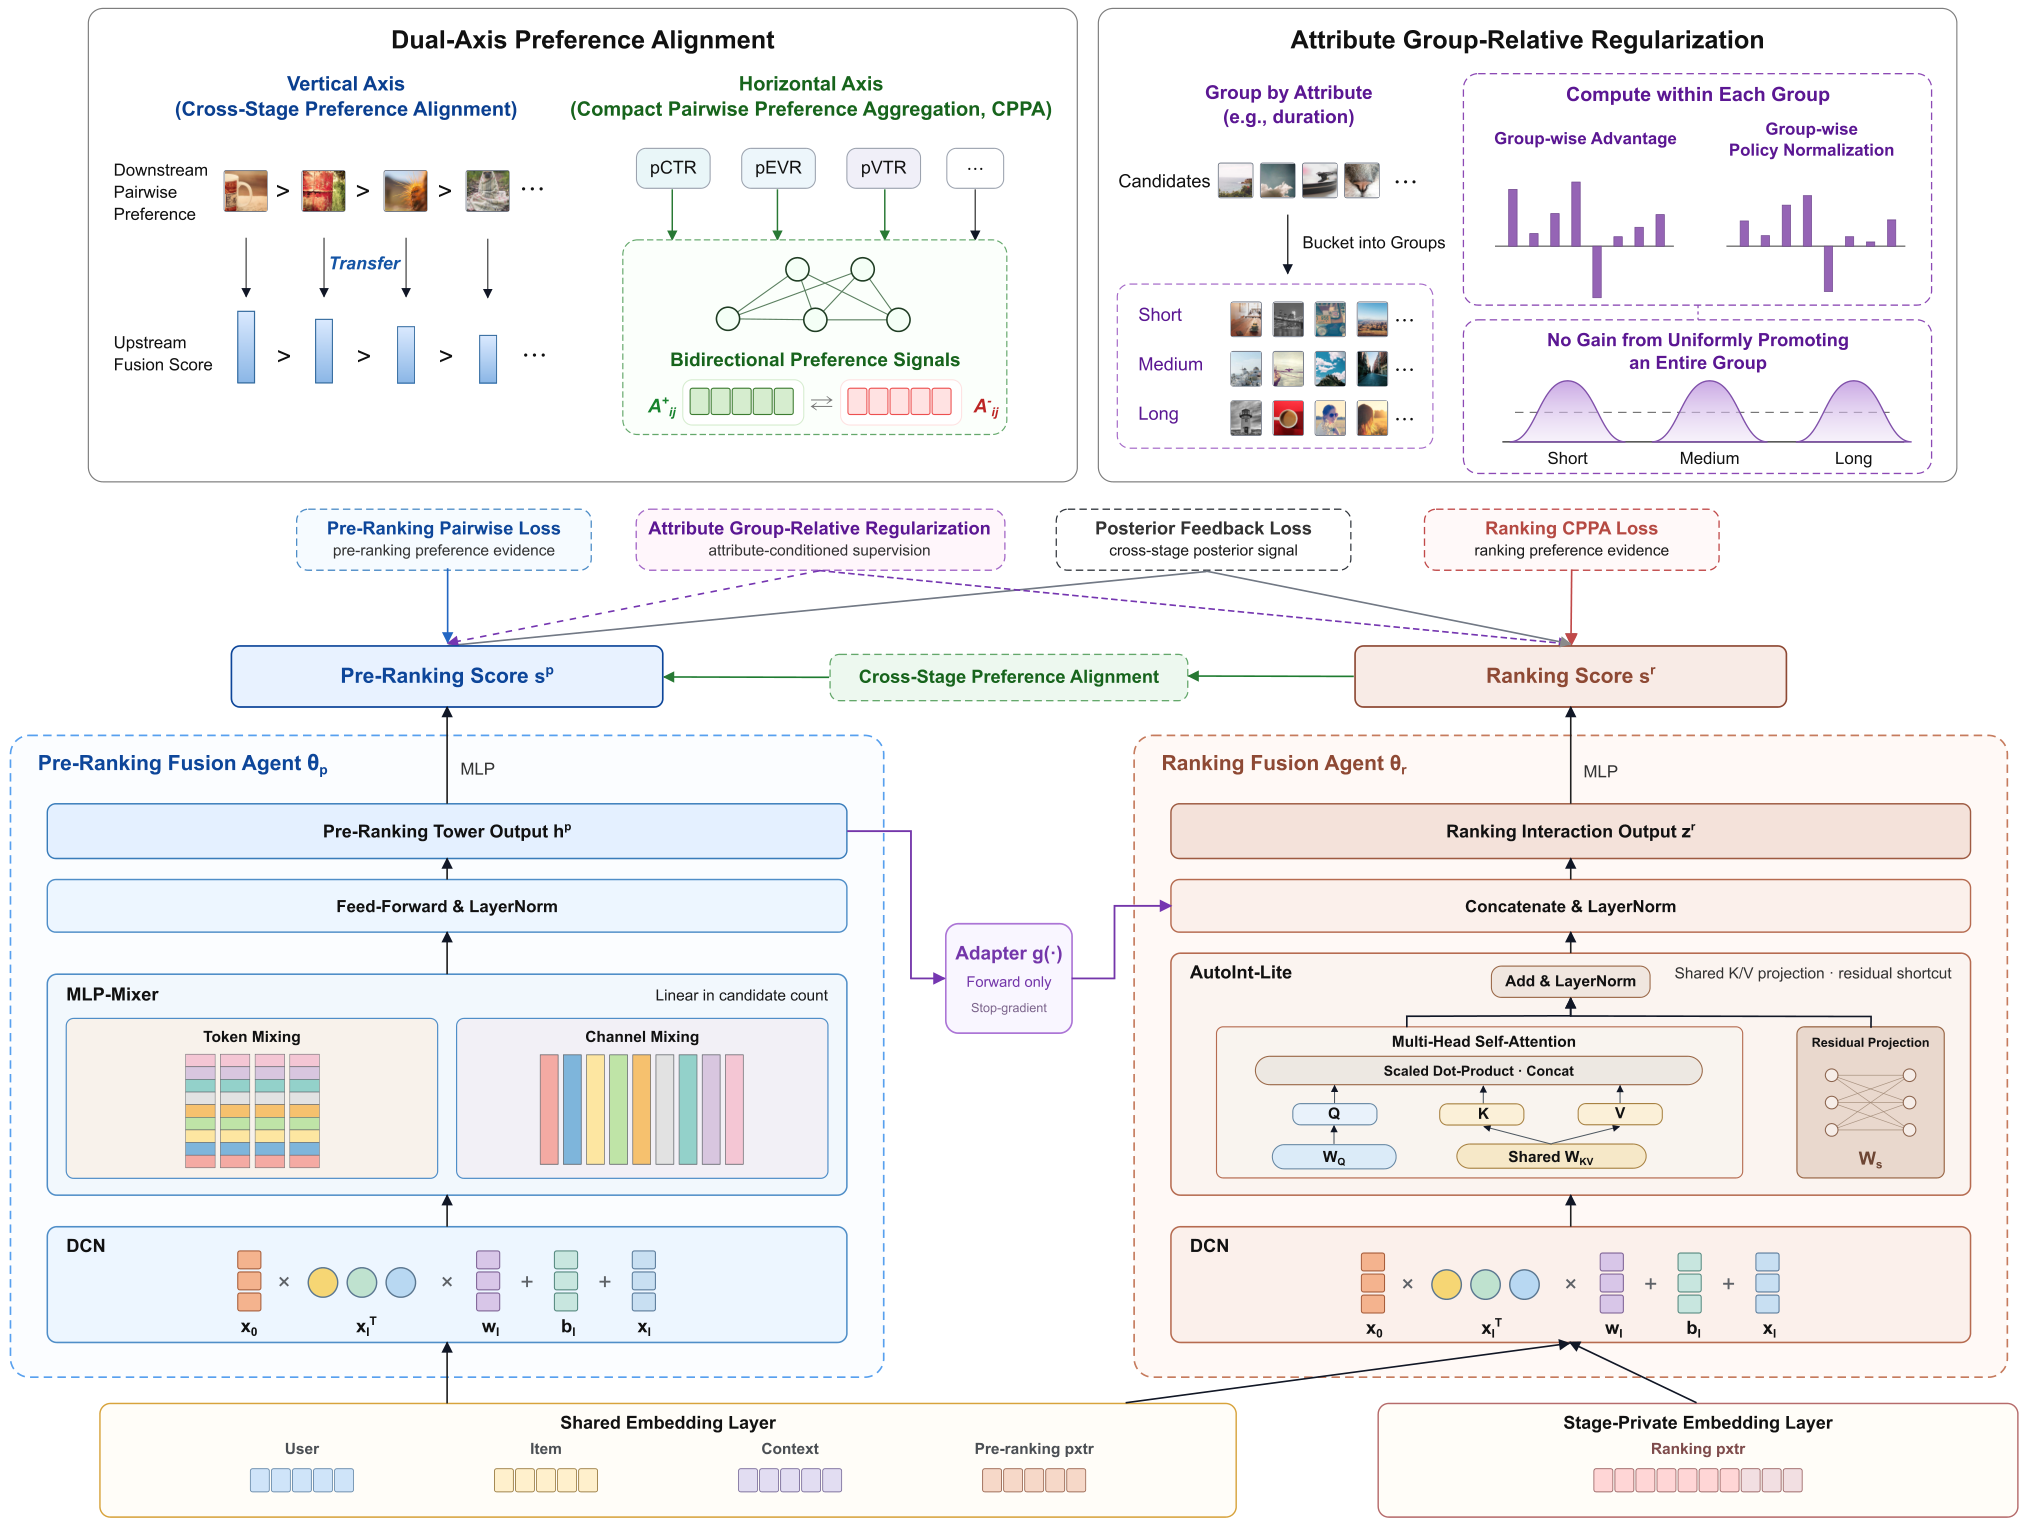
各位算法同学们,精排喜欢的内容,粗排可能早就把它扔了——这就是级联推荐里典型的跨阶段不一致。UniRec 的切入点不是只调粗排打分模型,而是把粗排和精排的多任务融合模块放进同一张计算图里联合优化。
📄 UniRec: Cross-stage Multi-Task Fusion with Preference Alignment for Cascaded Recommender Systems
🔧 两个融合 agent 部分共享输入 embedding,在单个计算图里训练,梯度能从任一阶段流回去影响另一端;adapter 还把粗排表示显式喂给精排融合模块。不是单向蒸馏,是双向适配。
🧩 双轴偏好对齐:纵轴把精排的 pairwise preference 传到粗排融合分,横轴把几十个异构先验信号上的 pairwise 目标压成双向偏好证据,降低多目标融合的扩展成本。
⚙️ AGRR 属性组相对正则:借鉴 GRPO 的分组思路,优势计算和策略归一化都放在同属性组内做。整组高奖励属性被统一抬高不会带来优化增益,避免端到端优化只偏向高回报属性区域。
📊 离线评估里,UniRec 稳定超过单阶段融合和跨阶段协调 baseline,论文没给具体点数,别把这个当绝对提升。
📈 线上 A/B 显示 app 使用时长 +0.616%。这个数字在生产系统里不算大,但方向一致且已全量部署。
✅ 已在快手平台全量部署,说明延迟和工程约束这关过了。
如果你在做级联推荐、粗排精排融合或多任务权重优化,这篇的抓手是“别只对齐打分,要对齐融合模块”。要盯的坑是 AGRR 属性分组怎么划,划太粗可能没约束,划太细又回到单目标;线上也别只看使用时长,最好同时看生态和多样性指标是否被牺牲。和 COPR、HCCP 这类跨阶段协调比,它多动的是融合层,不是上游打分。