小红书精读:Latent Residual Reasoning for Ranking in Generative Recommendation
别急着一次打分,让模型多想几步🔧
各位算法同学们,排序模型现在基本都是“快思考”:一次前向直接吐分。这篇偏要问一句——多算几步,能不能把候选的分打得更细?而且它没重训线上模型,只挂 LoRA,这点才是它真正有意思的地方。
📄 Latent Residual Reasoning for Ranking in Generative Recommendation(CIKM ‘26,USTC / 美团 / 人大 / 港理工等)
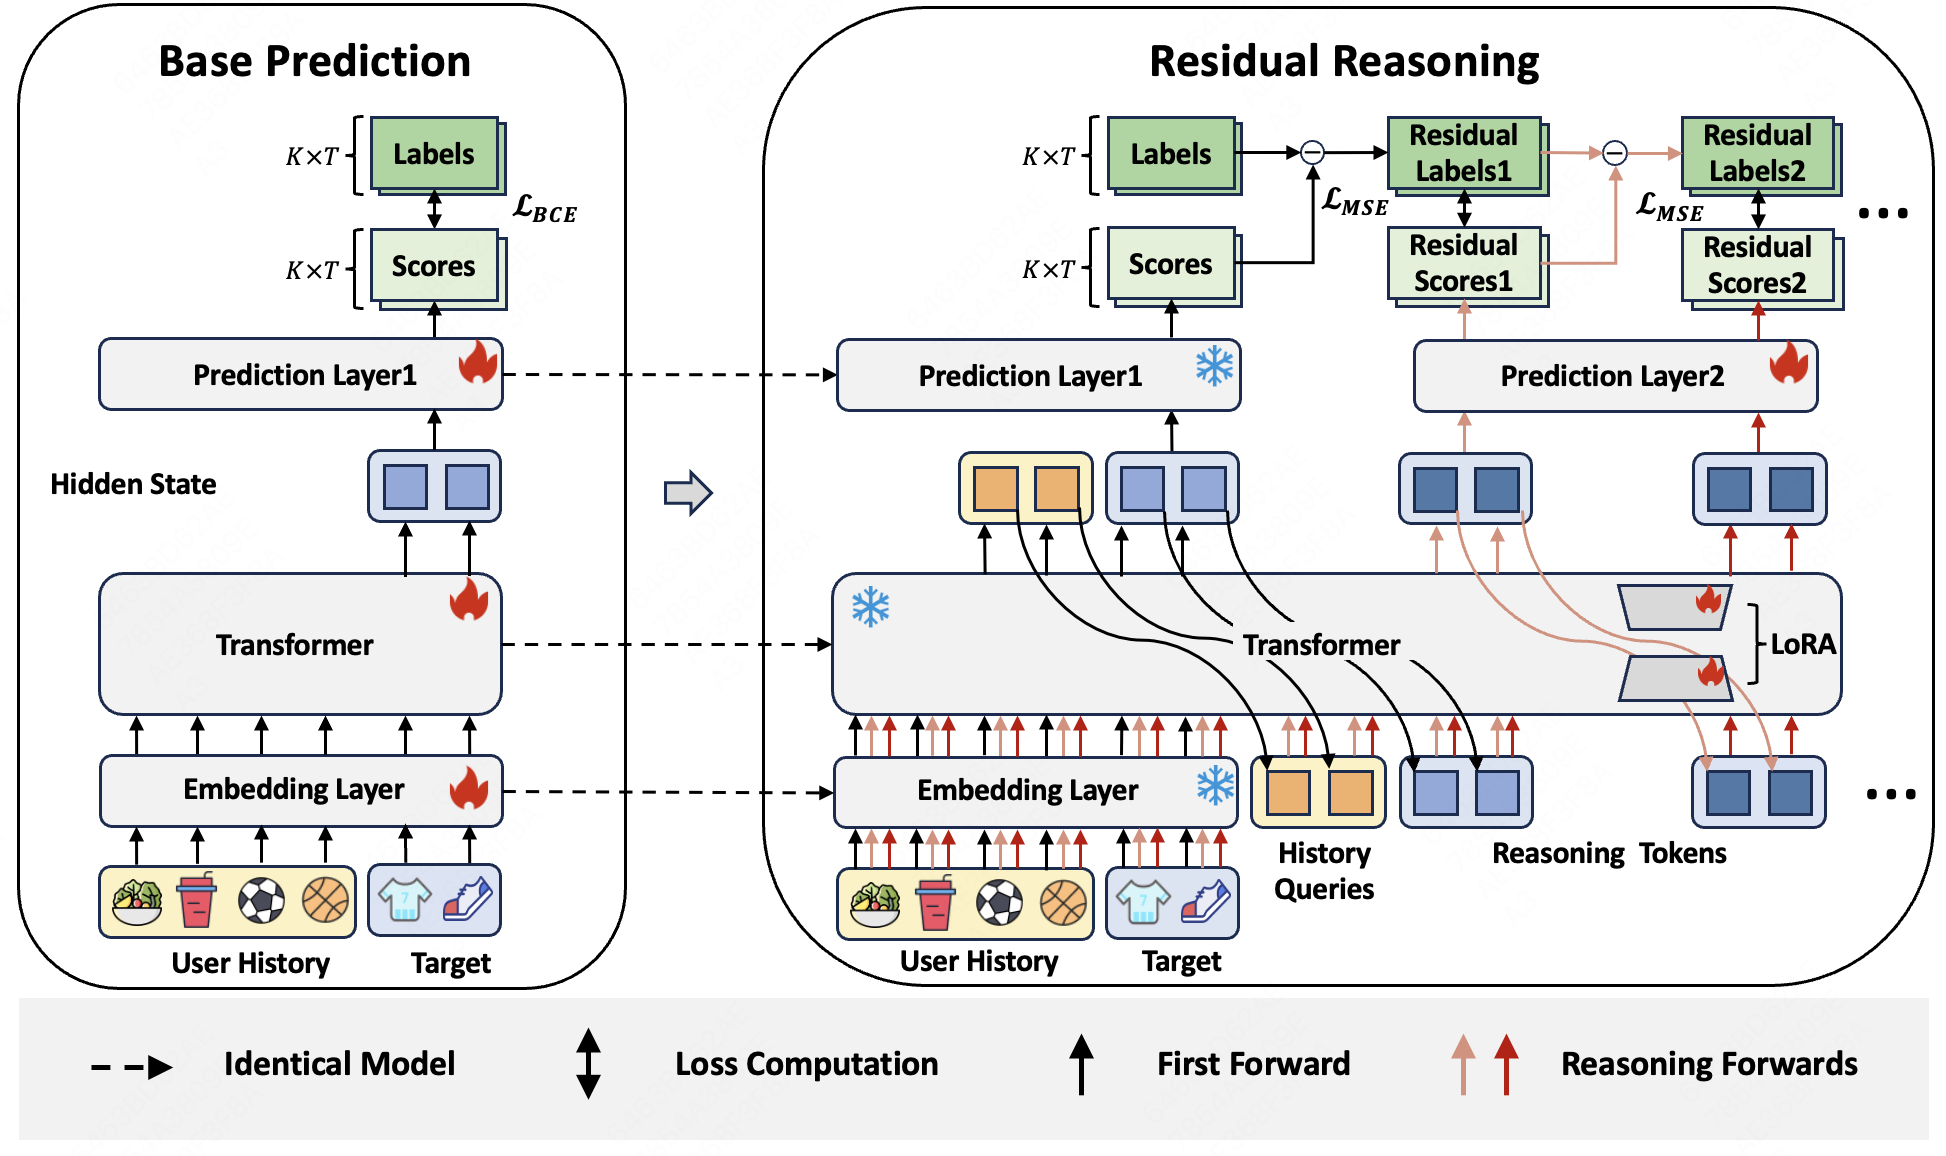
🔧 残差式潜空间推理:不在每一步重新预测完整分数,而是让第 r 步只学“对上一步的加性修正”,逐步累加。这样一来,每步的监督信号天然对齐排序目标,而不是语义 ID 生成那套目标。
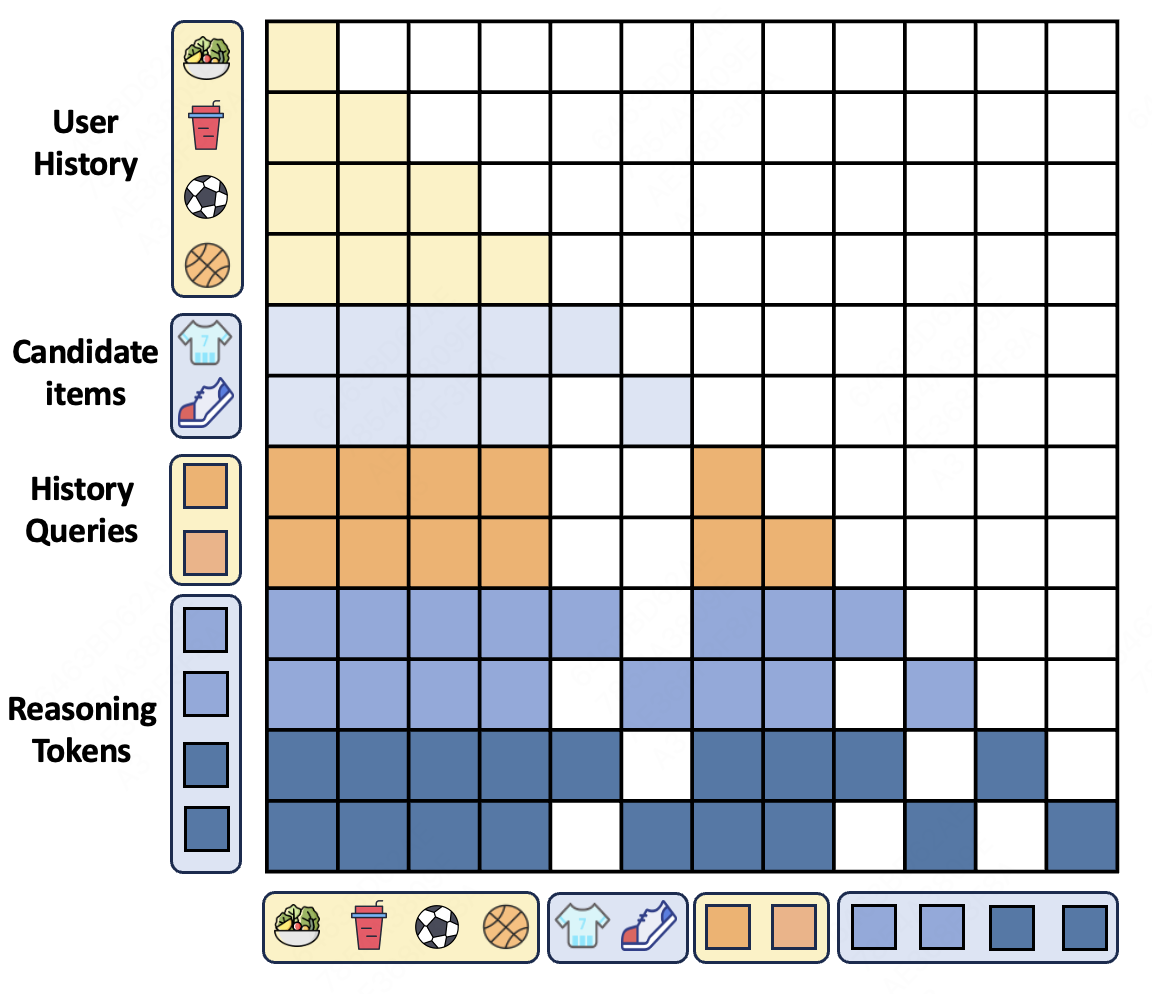
🧩 history queries:候选并行打分时,每个候选各带自己的 reasoning token,容易丢掉全局用户信息。作者从用户行为序列里压出一组 history query,给候选特定推理补一个全局视角。
⚙️ 冻结底座加 LoRA 加独立推理预测层:不改主干、不换在线模型,只做参数高效适配。对工业团队来说,这决定了它是“能上线”还是“只能发论文”。
📊 验证覆盖 2 个公开 benchmark、1 个大规模离线工业数据集、1 次线上 A/B,三个层面都做过,不是只在小数据集上刷点。
📈 落在 2 个排序模型上跑,其中包含线上在部署的 MTGR,说明不是挑了个好欺�负的底座。
✅ 作者点名的增益场景是冷启动物品和长序列、行为复杂的用户——这两类恰好是直接预测最容易欠拟合的地方。具体涨点数字在正文表格里,摘要没给,别信二手转述的百分比。
总结:做生成式排序、又不想动线上主模型的团队可以看,思路是“用推理步数换分数精度”,路径比端到端重训温和得多。要盯三件事:一是离线 AUC 涨了之后 CTCVR 和冷启分桶是否同步涨,二是推理步数与延迟的收益曲线在哪一步开始变平,三是 LoRA 分支和主模型版本的同步维护成本。坑在这儿:多步推理是实打实的算力开销,如果只在小流量场景试,收益很容易被延迟抵消掉。
原文:AlphaXiv