小红书精读:KL-MOPD: Discrepancy-Aware Multi-Objective On-Policy Distillation for Generative Recommendation
多目标蒸馏:难教的teacher会换人
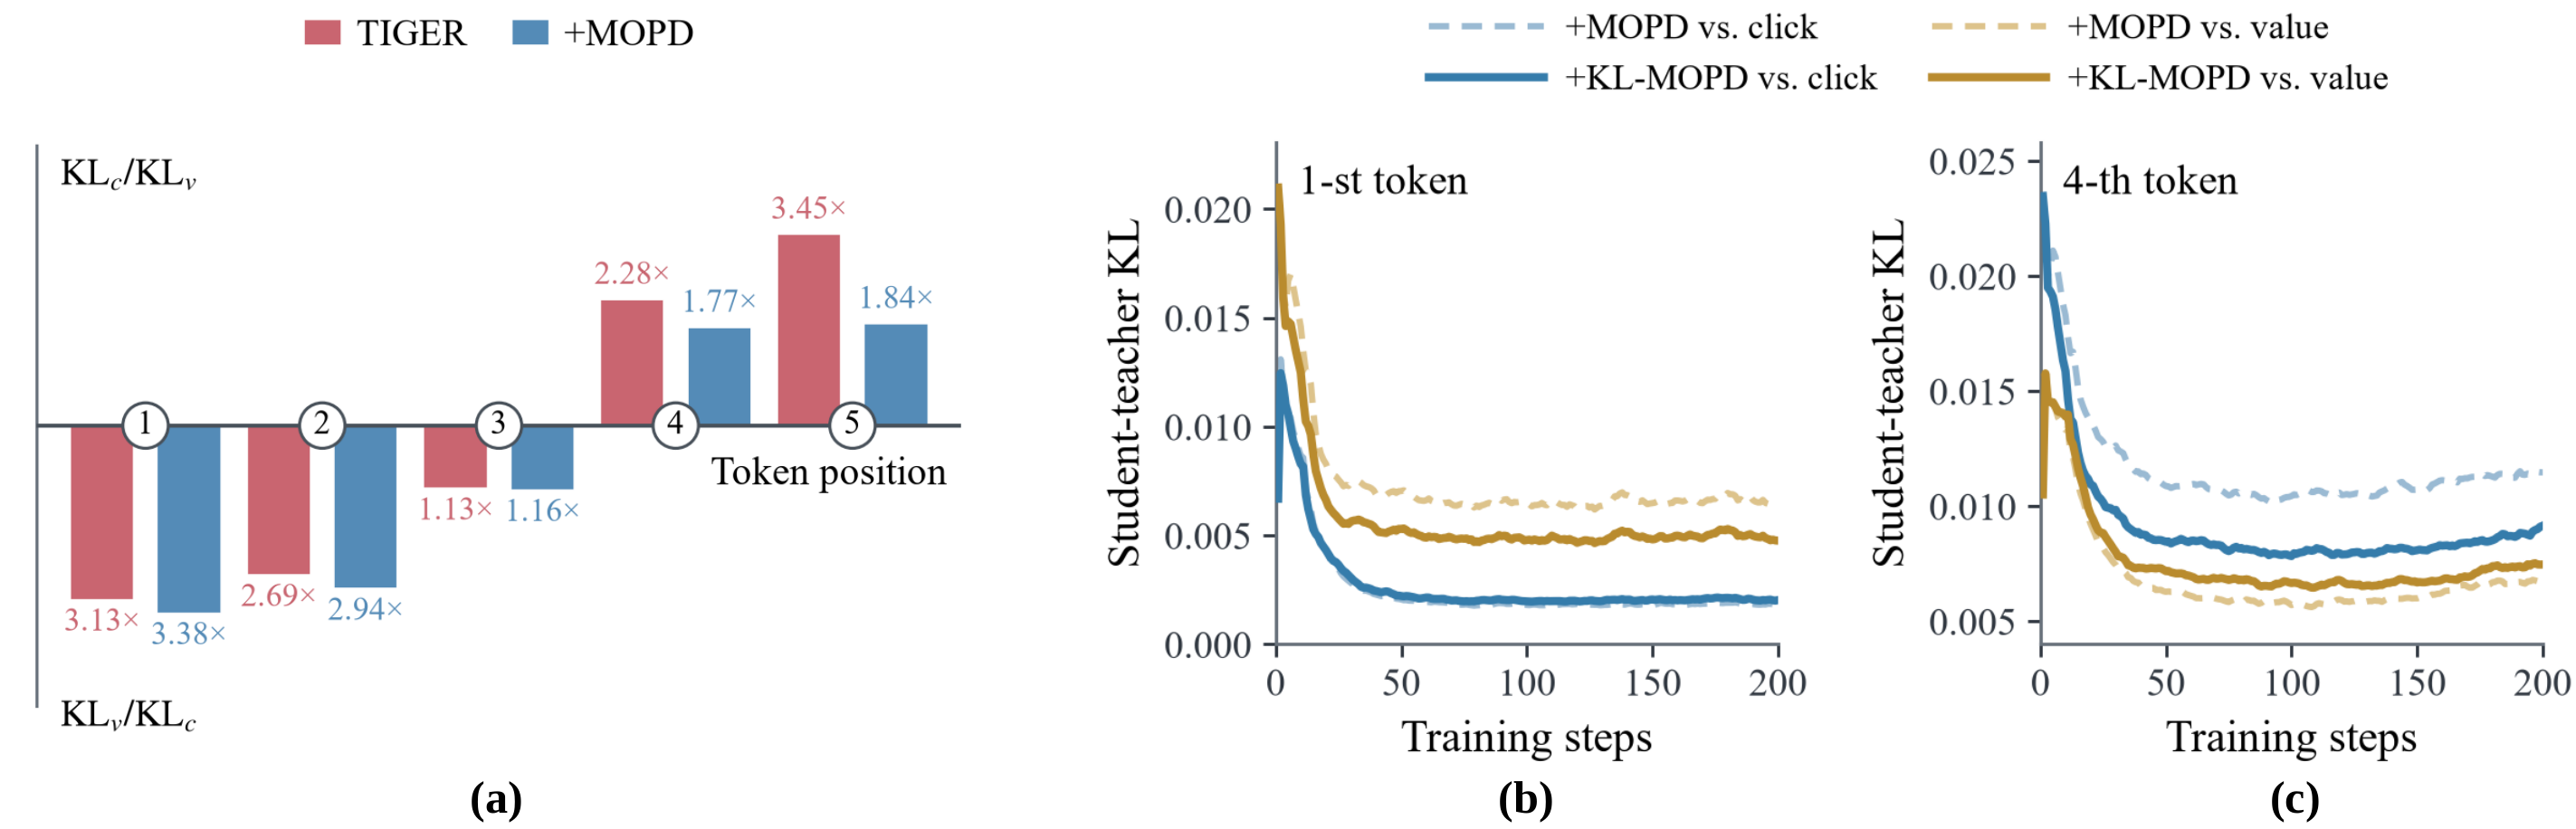
各位算法同学们,在同一个 token 上,初始 student 到 value teacher 的 KL 是到 click teacher 的 3.13 倍;到了第 4 个 token,难教的那个换成了 click teacher。等权多 teacher 蒸馏就会在每一步都欠拟合一个目标。
📄 KL-MOPD: Discrepancy-Aware Multi-Objective On-Policy Distillation for Generative Recommendation
🔧 把多目标 on-policy 蒸馏方法 MOPD 搬进生成式推荐:item 级多目标方法只看整条物品,但生成式推荐(GR)要每个 token 都选对才能召回正样本,所以改成在 student 自己采样的轨迹上,逐 token 对齐两个单目标 teacher 的 next-token 分布。
🧩 指出 vanilla MOPD 的两个问题:token 级不平衡,每步两个 teacher 难度不同;跨 token 不一致,难教的那个会沿解码步切换。等权设置对这两点都没反应。
⚙️ 解法很轻:按初始 student 到各 teacher 的 token-wise KL 比例,分配该 token 上的 teacher 权重,难教的那一方多给监督;权重在训练前一次性算好,不增加前向计算,即插即用,并证明在双目标加性联合目标下严格优于 vanilla MOPD。
📊 三个公开 benchmark、八个 baseline,多数是 2026 年新工作:单目标平均提升 4.91%,联合目标平均提升 4.12%,也超过最强单目标 teacher 本身。
📈 到两个 teacher 的平均 item-wise KL 降了 13.70%,不是靠牺牲一个目标换另一个。
✅ 十亿级工业数据(49M 用户、158M 广告)离线联合指标提升 3.19%;10% 流量线上 A/B 广告收入提升 1.63%、GMV 提升 2.20%。
判断:做多 teacher 蒸馏或多目标 GR 的同学可以先试,改动只在 loss 权重,不碰模型结构,能在已有 MOPD 管线上快速验证。重点看每个 token 上两个 teacher 的 KL 比值有没有收敛,以及联合指标是否超过单目标 teacher;只涨单目标、联合不动,说明权重没起效。风险是权重依赖初始 student,换初始化、换 teacher、加第三个目标都要重新计算并重新验证,理论保证也只覆盖双目标加性形式。
原文:AlphaXiv