小红书精读:Retail Product Search: A Practical Approach at Target
混合检索上线,CTR涨0.97%🔍
各位算法同学们,纯关键词检索换成混合检索后,零结果查询直接砍了一半。Target 这篇把线上 A/B 的每一步都写清楚了,做电商检索或垂类搜索的话,能直接对照自己的链路找差距。
📄 Retail Product Search: A Practical Approach at Target
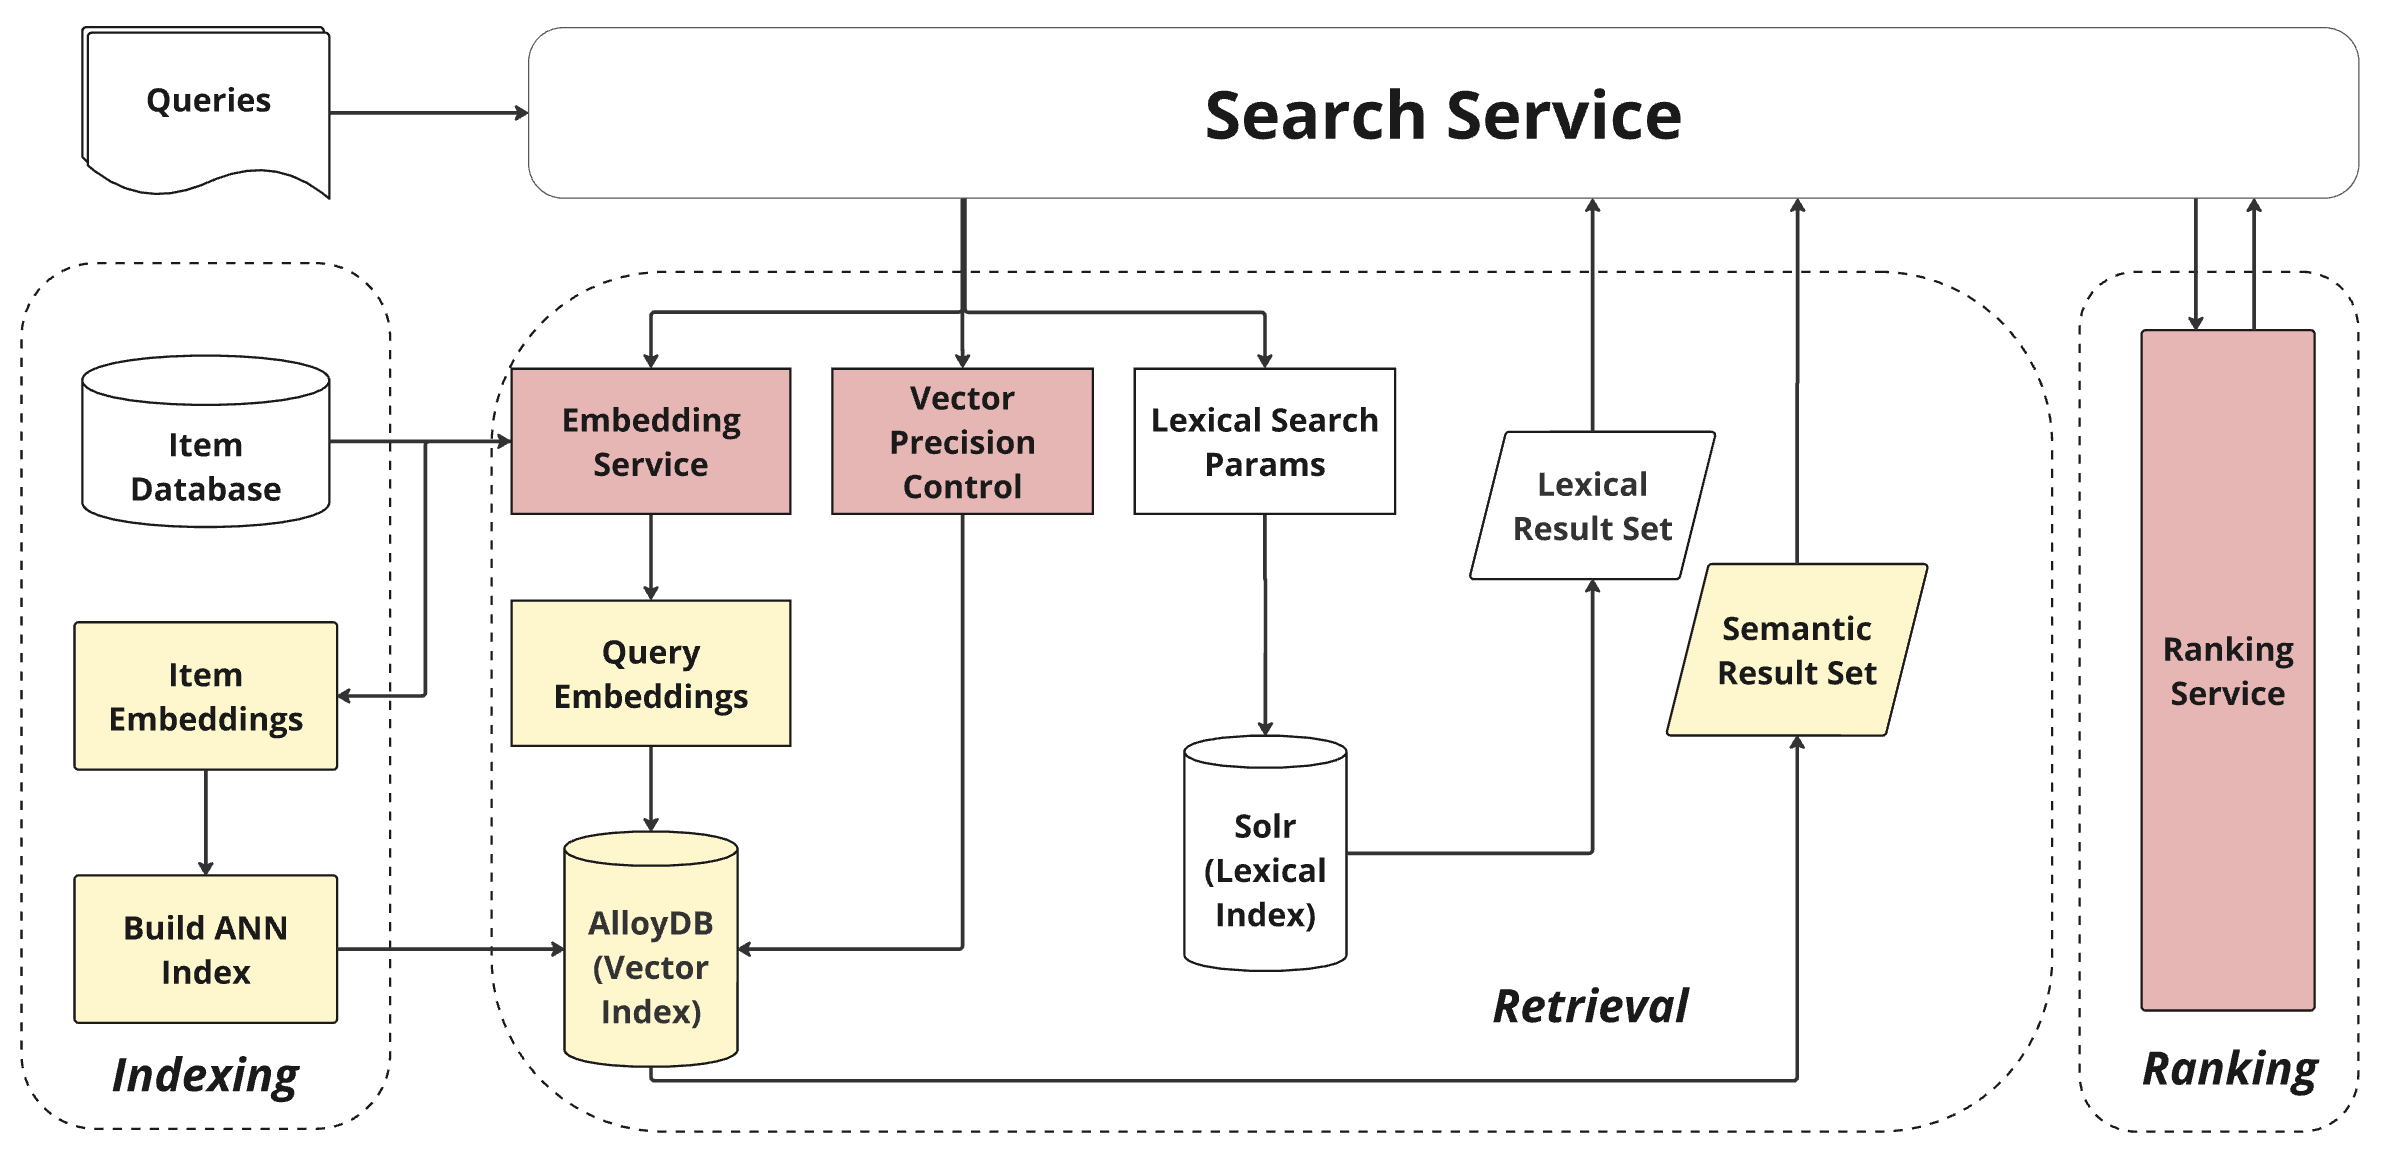
🔧 双通道并行召回:Solr 倒排索引和微调双塔向量模型同时跑,向量侧用 AlloyDB 上的 ScaNN 做 ANN,索引覆盖百万级商品向量,文本不一致的同义、缩写、拼写错误都能兜住。
🧩 标签完全来自行为日志:点击、加购、转化聚合成约 2000 万 query-商品对,按类目和 query 频次分层采样,避免头部 query 淹没长尾,还构造了两类难负样本做对比学习。
⚙️ 精度控制加融合策略:先用 query 里出现或预测出的属性过滤向量候选,再对比 RRF 和加权交错,线上测试最终选了加权交错,权重靠 A/B 调。
📊 4 周线上 A/B 对比纯关键词检索:CTR 提升 0.97%,订单转化提升 0.98%,人均需求提升 1.10%。
✅ 零结果搜索大约减半,系统已全量部署,每天服务数百万用户。
📈 离线指标也有提升,但论文强调真正做决策的是线上转化和参与度,不是通用相关性榜单。
我的判断:做电商搜索、内容检索或任何 query 意图跨度大的团队,可以重点看它的标签构造和精度控制,这两块比模型结构更影响落地效果。坑也很明显,加权交错的权重会随类目和流量变化漂移,得持续用 A/B 盯;向量通道不加过滤,低精度结果会直接进候选池。如果要对照,先看自己的零结果率、CTR、转化和 P99 延迟,再看离线召回指标。
原文:AlphaXiv