小红书精读:PEAR: Progressive Evidence-Based AutoResearch for Industrial Search Systems
工业搜索AutoResearch新解🔍
各位算法同学们,工业搜索里让 agent 自己迭代调策略,最大的坑不是模型不够强,而是把短暂流量波动当成永久提升。PEAR 这篇把“证据”和“置信度”拆开设计,适合正在做搜索/推荐策略自动优化的人看。
📄 PEAR: Progressive Evidence-Based AutoResearch for Industrial Search Systems
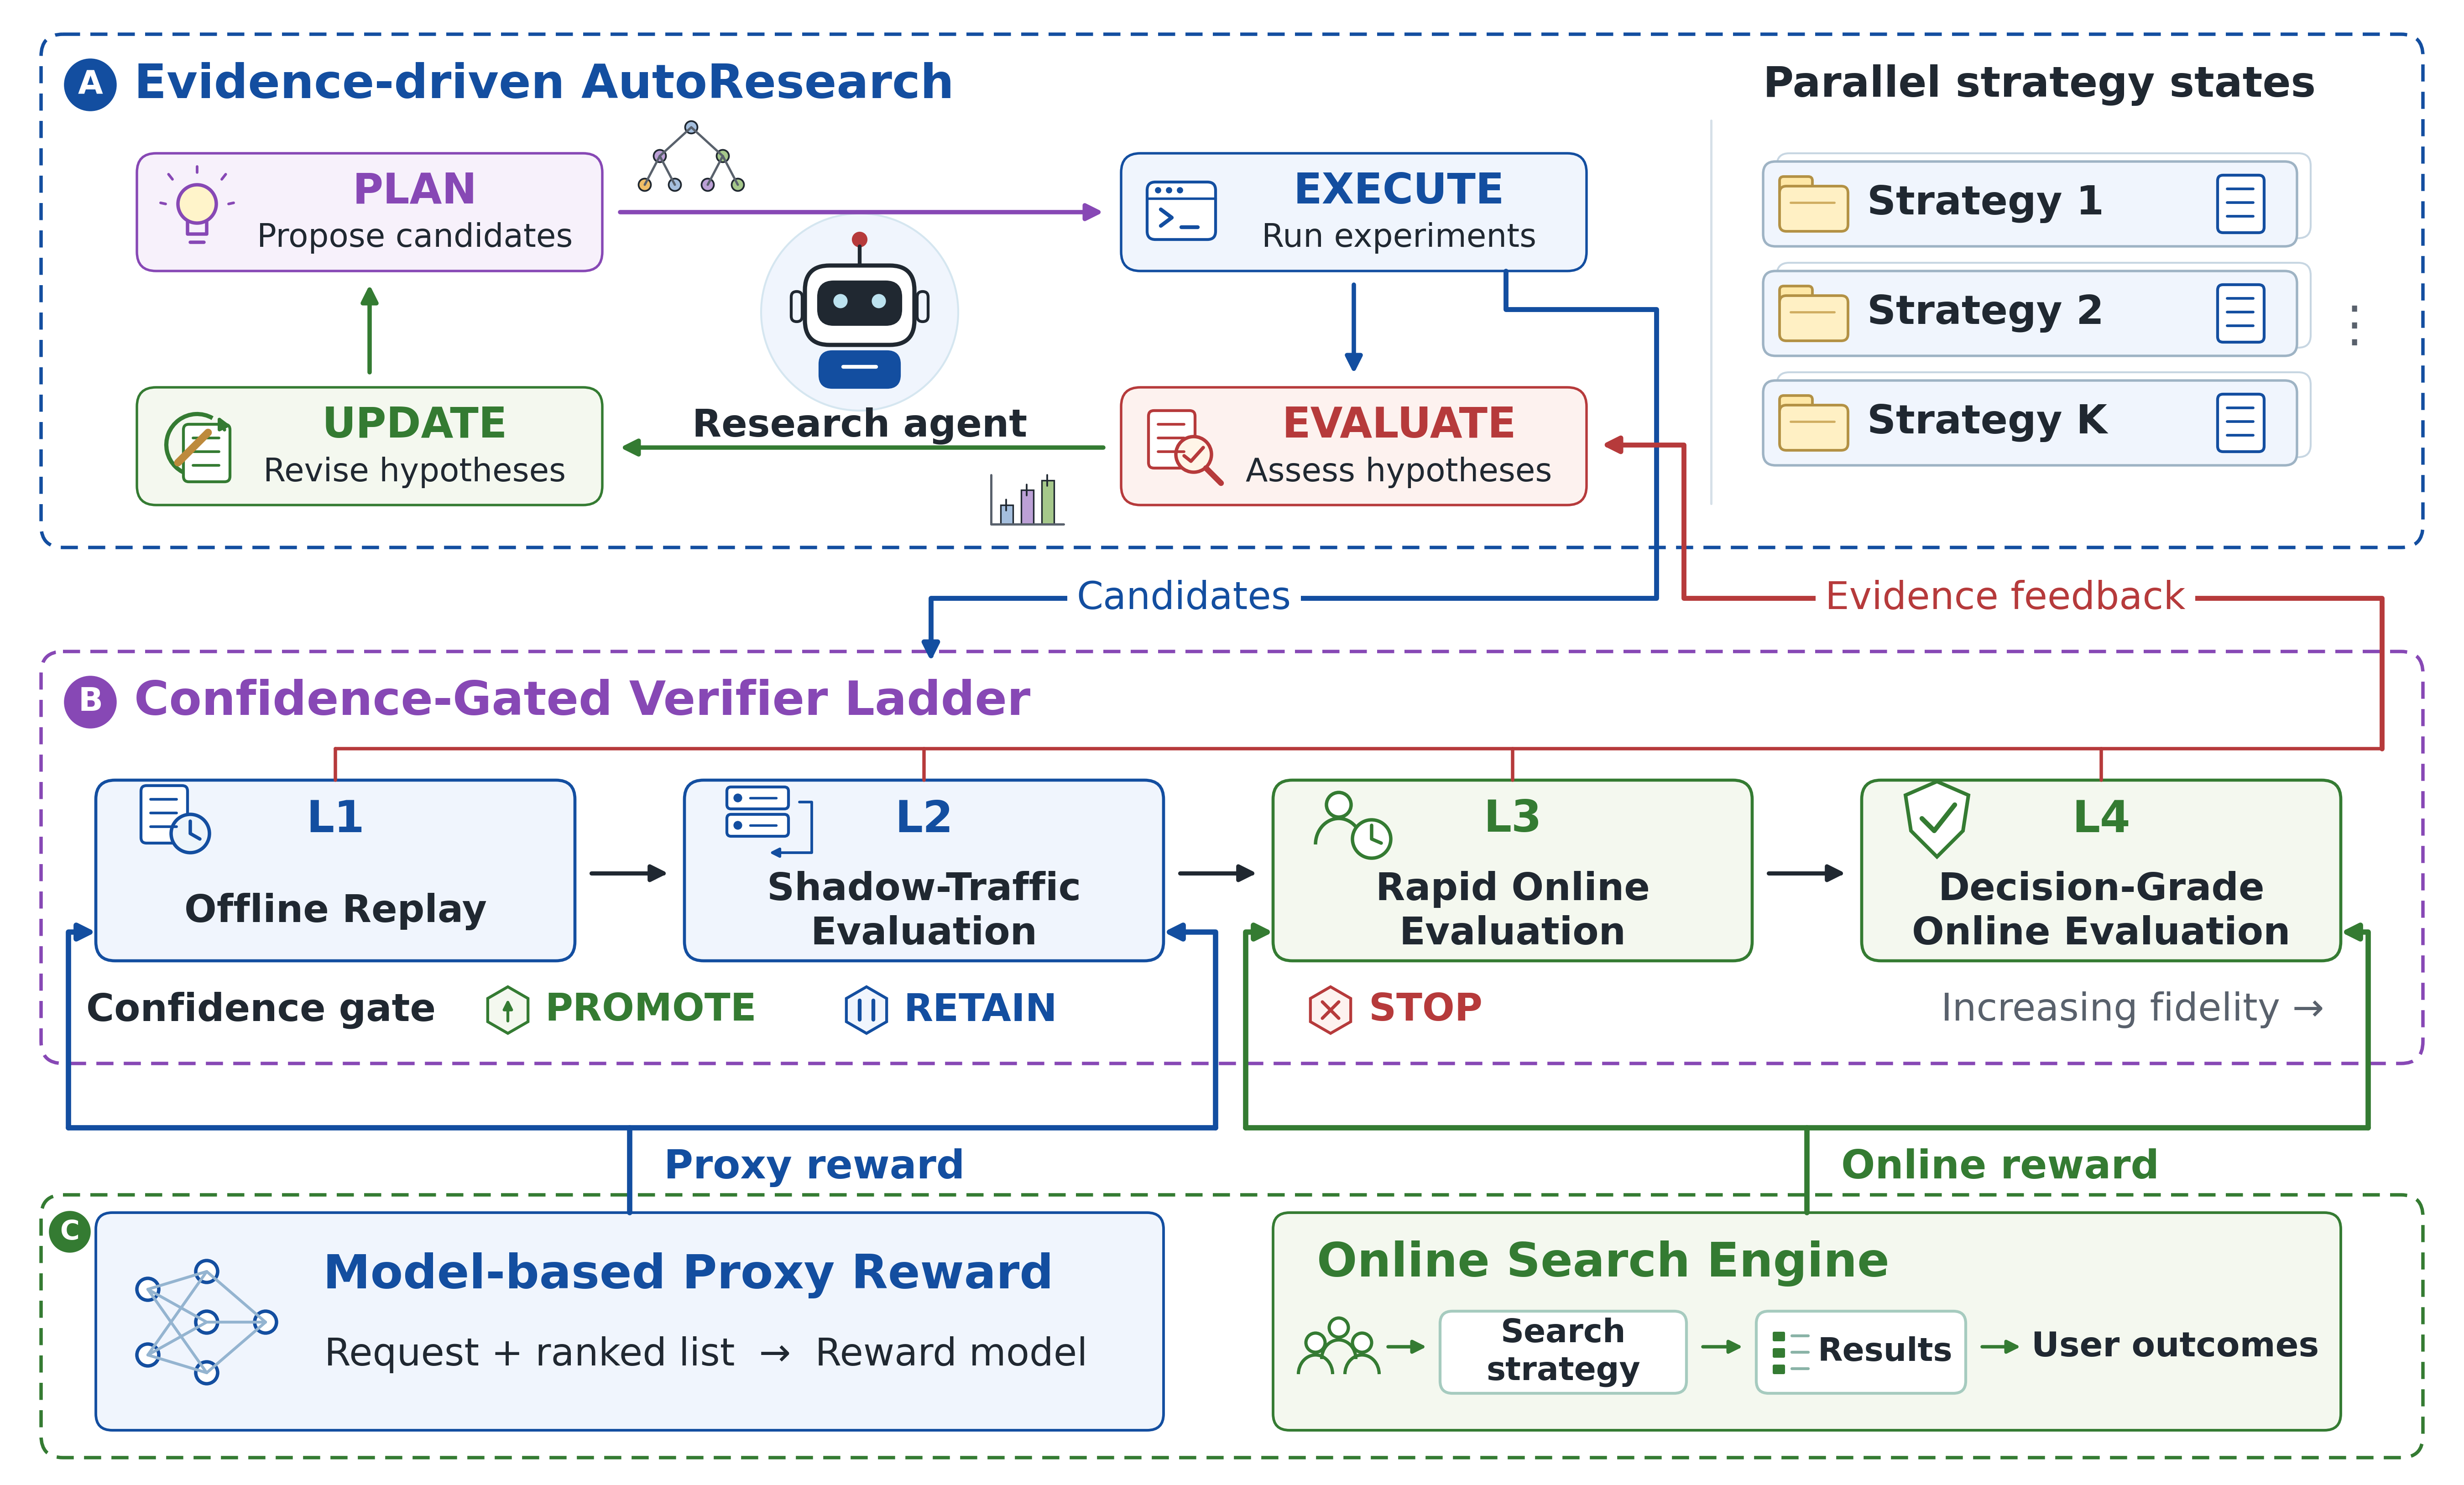
🔧 用 Evidence-driven AutoResearch 给每个策略任务维护独立研究状态,把假设、候选干预、实验结果和流量上下文绑在一起,不再用一个全局分数串所有轮次。
🧩 Plan–Execute–Evaluate–Update 循环里加入贝叶斯优化式推理:既细化已有证据支持的区间,也探索没试过的区域;不同流量上下文里的分数不会被直接比较。
⚙️ Confidence-Gated Verifier Ladder 把评估分成四层:Offline Replay、Shadow-Traffic Evaluation、Rapid Online Evaluation、Decision-Grade Online Evaluation。统一置信度门只让统计显著正向的候选往上走,便宜评估负责宽探索,贵的线上实验留给被 promote 的候选。
📊 真实工业搜索系统,三个策略任务上跑,两个被 promote 的候选从 Shadow-Traffic 到 Decision-Grade Online 方向一致为正。
📈 两个 Decision-Grade Online A/B 实验里,Main Order/DAU 分别相对各自 baseline 提升 2.7336% 和 3.2957%。
✅ 这是线上主单和 DAU 指标,不是离线 proxy;提升幅度在成熟工业系统里不算小,但论文没给置信区间和实验时长,复现时要盯显著性和流量平稳性。
总结感想:如果你在做搜索/推荐策略的 AutoResearch,PEAR 的主要价值是把 keep-if-better 换成带上下文和置信度的证据管理,并给了一个分层评估的工程模板。落地坑在于四层阶梯依赖 Shadow 流量和快速在线实验平台;没这套基建,先做研究状态和置信度门性价比更高,对比对象也建议先用 keep-if-better 基线加单层离线筛选。
原文:AlphaXiv