小红书精读:LIGE-GR: A Smooth Leap from Ranking to Generative Recommendation in the LLM Era
把排序变生成,线上只涨1.14% 🤔
各位算法同学们,把成熟排序系统改成生成式推荐,线上时长只涨 1.14%,但多花的推理资源约等于原 context-free 排序组件的 10%——这可能是工业界更愿意接受的一步。这篇 LIGE-GR 想解决的是:LLM 式 listwise 生成到底怎么塞进已有推荐栈,而不是推倒重来。
📄 LIGE-GR: A Smooth Leap from Ranking to Generative Recommendation in the LLM Era
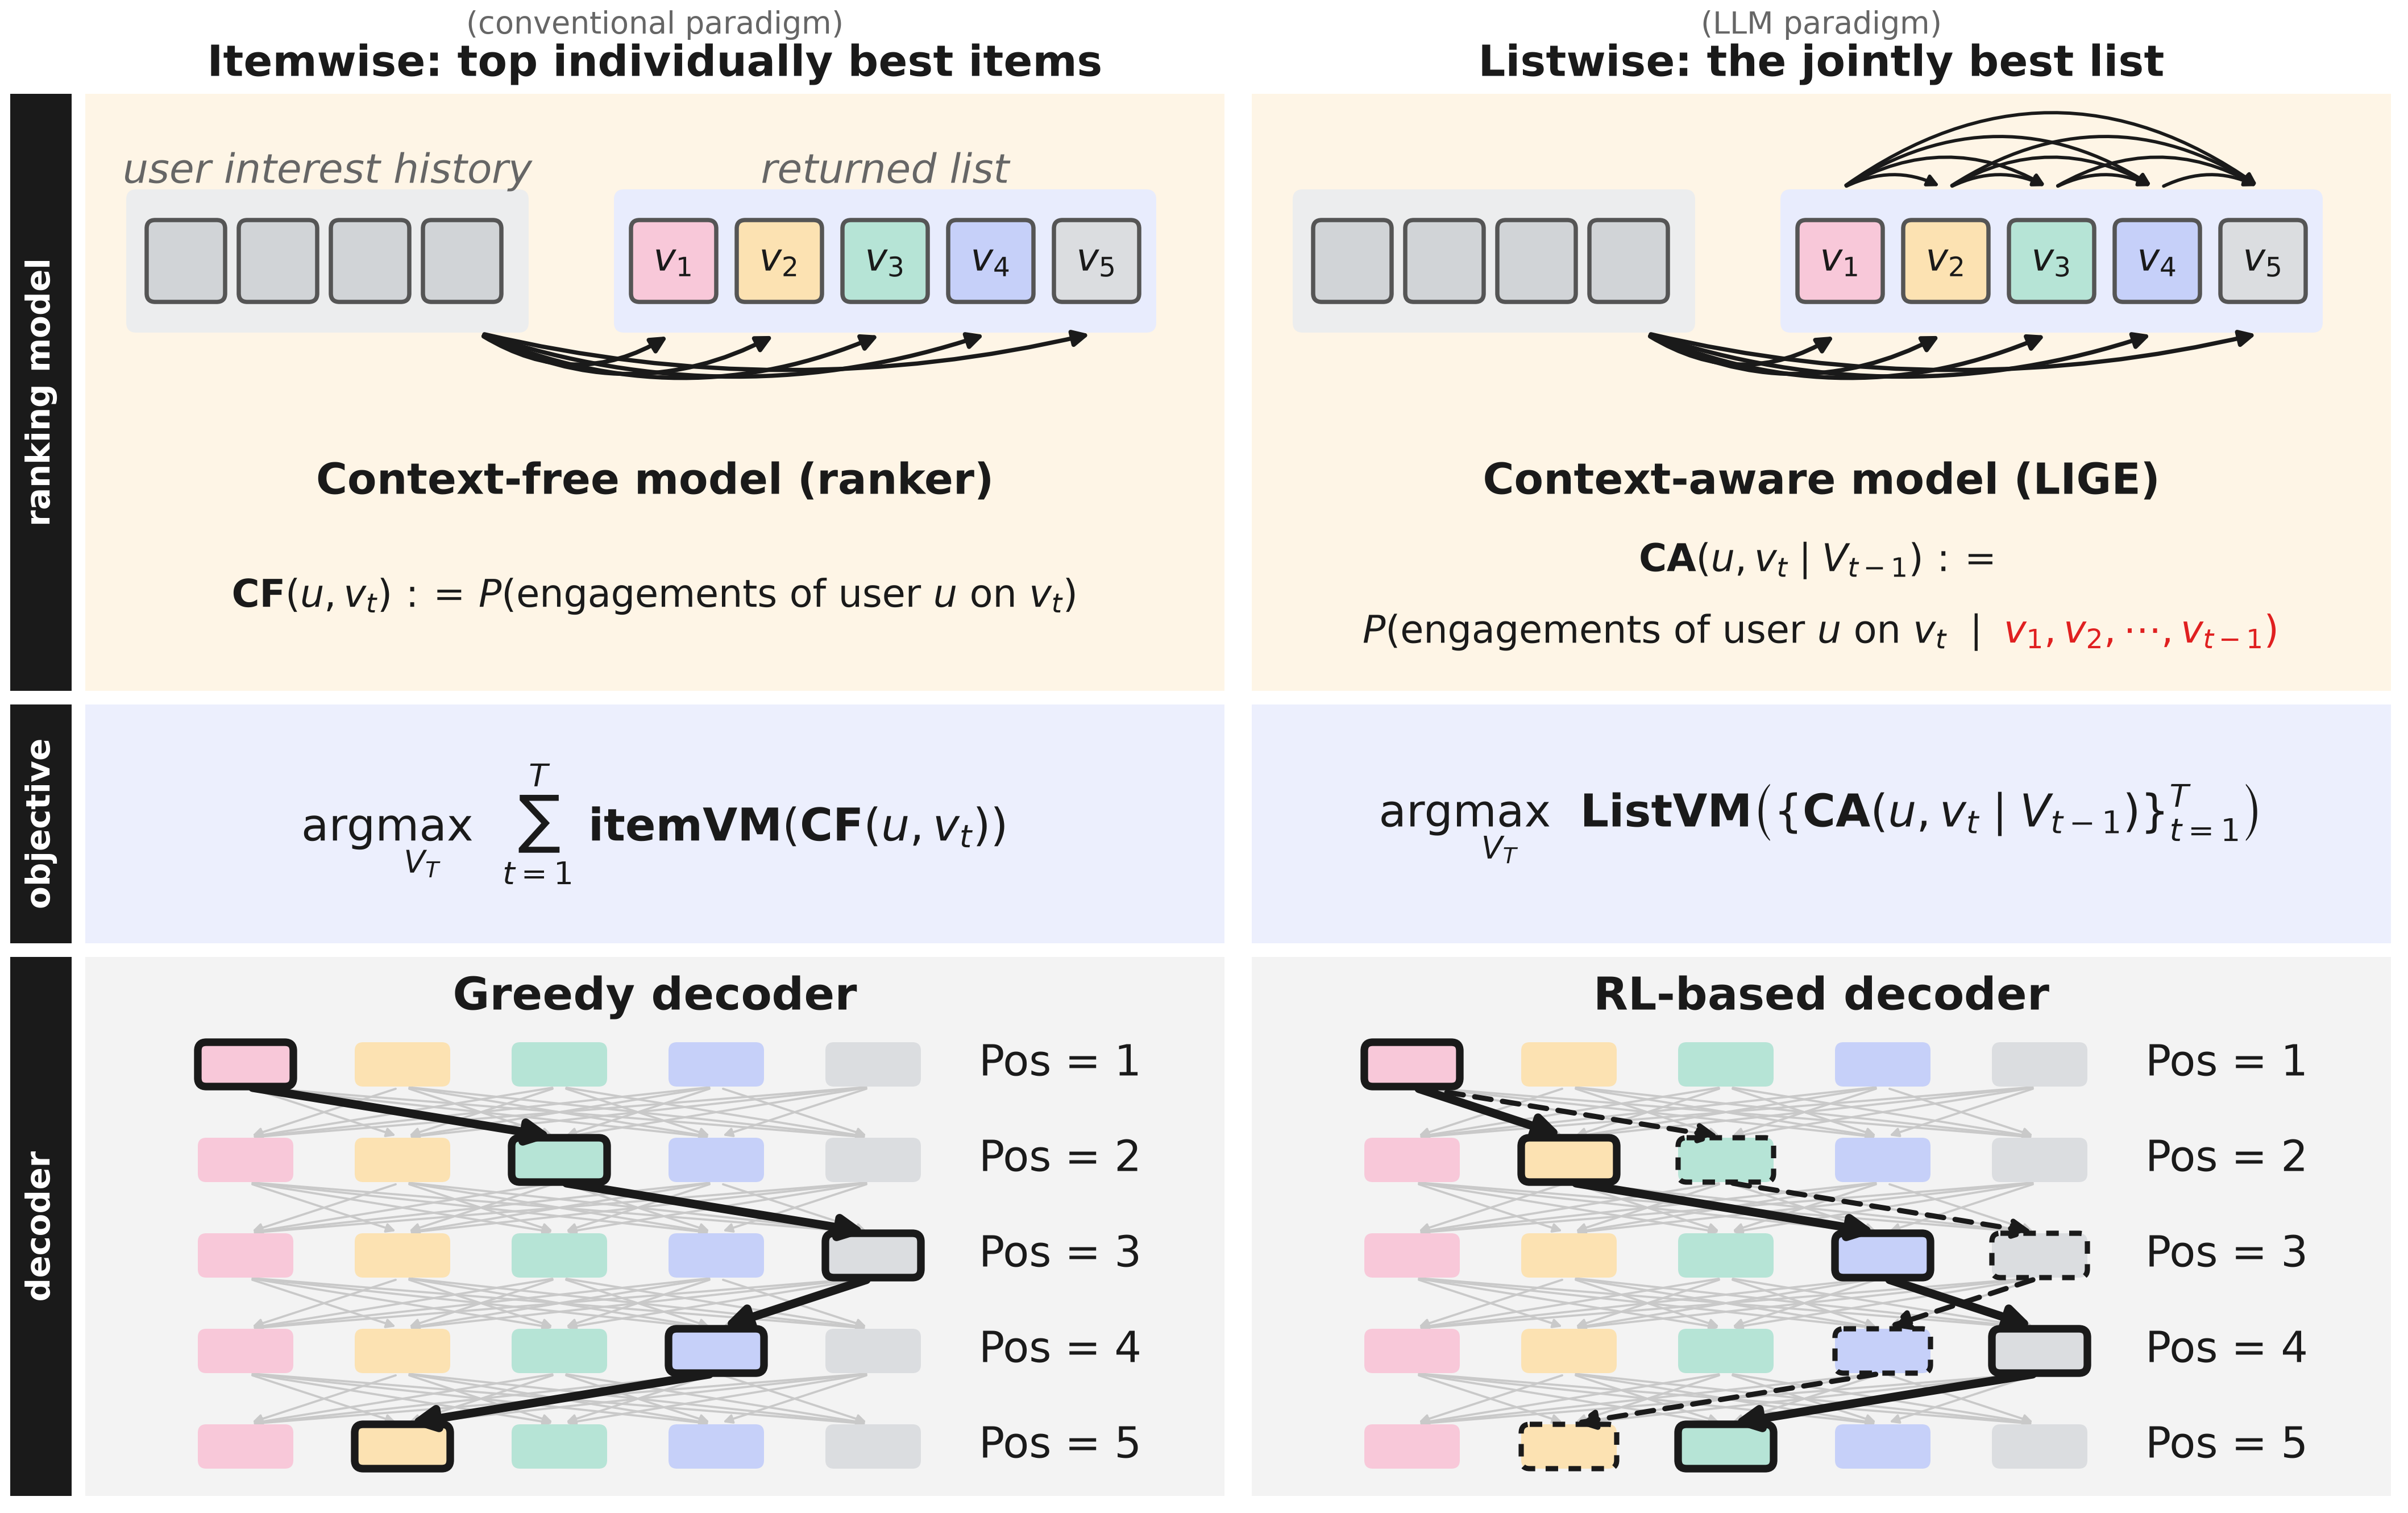
🔧 排序模型从 context-free 升级到 context-aware:每个 item 的预估值不再只看用户和自己,还会看已排进列表的前缀,用轻量 4 层 causal Transformer 做条件修正。
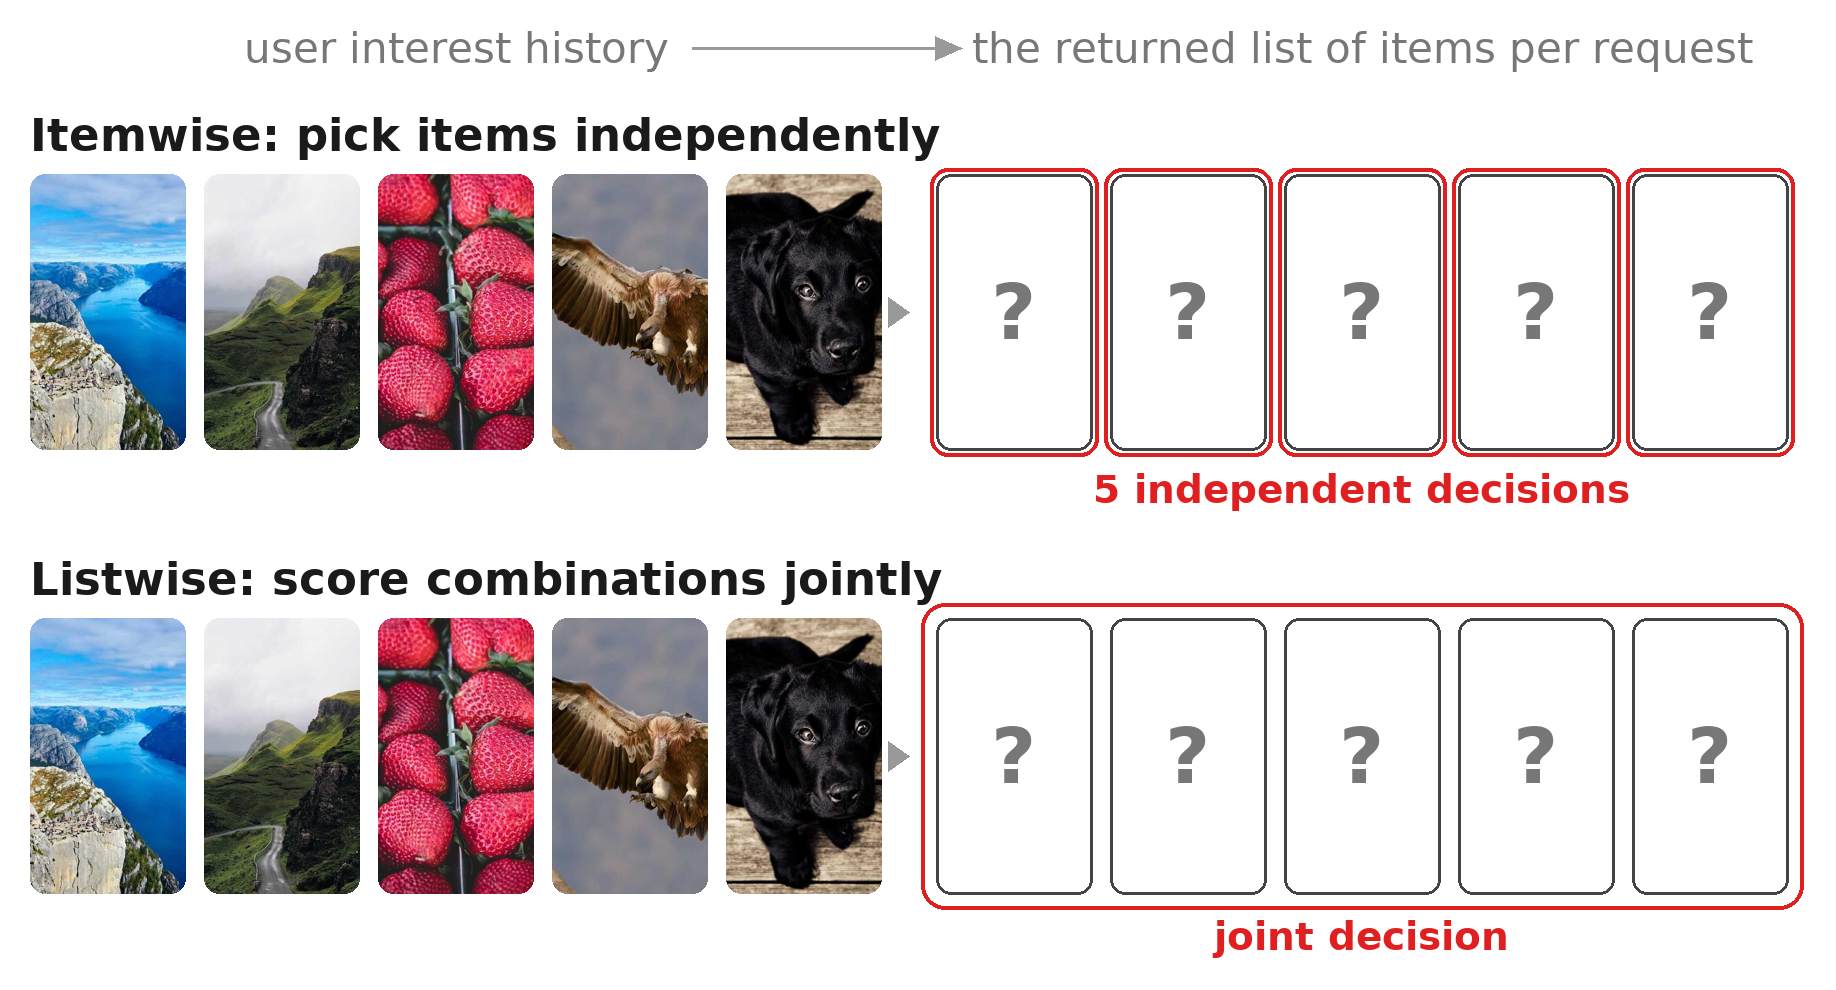
🧩 目标函数从 itemwise 打分求和,扩成 listwise value model,整条序列一起评估;同时保留原控制层做多样性和业务约束,兼容已有 value function。
⚙️ 解码从逐位置贪心选最高分,换成 RL-based 序列解码(Palette decoder),在位置×候选的路径里探索;且三个模块都能回退,退回去就恢复原系统。
📊 Instagram Reels 上 time spent 提升 1.14%。
📈 Facebook Video 上 time spent 提升 0.72%。
✅ 额外推理资源约为 context-free 排序组件的 10%,端到端每请求延迟增加约 7%。
✅ 列表长度 T 设为 10 左右,不是重造整条链路。
我的判断:它更适合已经有成熟排序栈、想试 listwise 优化又不想大换血的团队。要盯的是延迟预算、RL 解码在线上是否稳定、回退开关是否真能无损;如果 baseline 已经调得很强,百分位收益的复现难度不低,别只看离线的序列指标。
原文:AlphaXiv