小红书精读:Distilling Lexical Product Associations into Deep Transformers: An Extreme Multi-Label Approach for Natural Language E-Commerce Search
🔍P@1 93%,小模型学会语义找货
各位算法同学们,54,000个商品、53,923个类,最后P@1能到93.15%,而“老师”只是个TF-IDF近邻图。这篇把电商搜索从词面匹配往语义蒸馏推了一步,还顺手修了老baseline的索引错位坑。
📄 Distilling Lexical Product Associations into Deep Transformers: An Extreme Multi-Label Approach for Natural Language E-Commerce Search
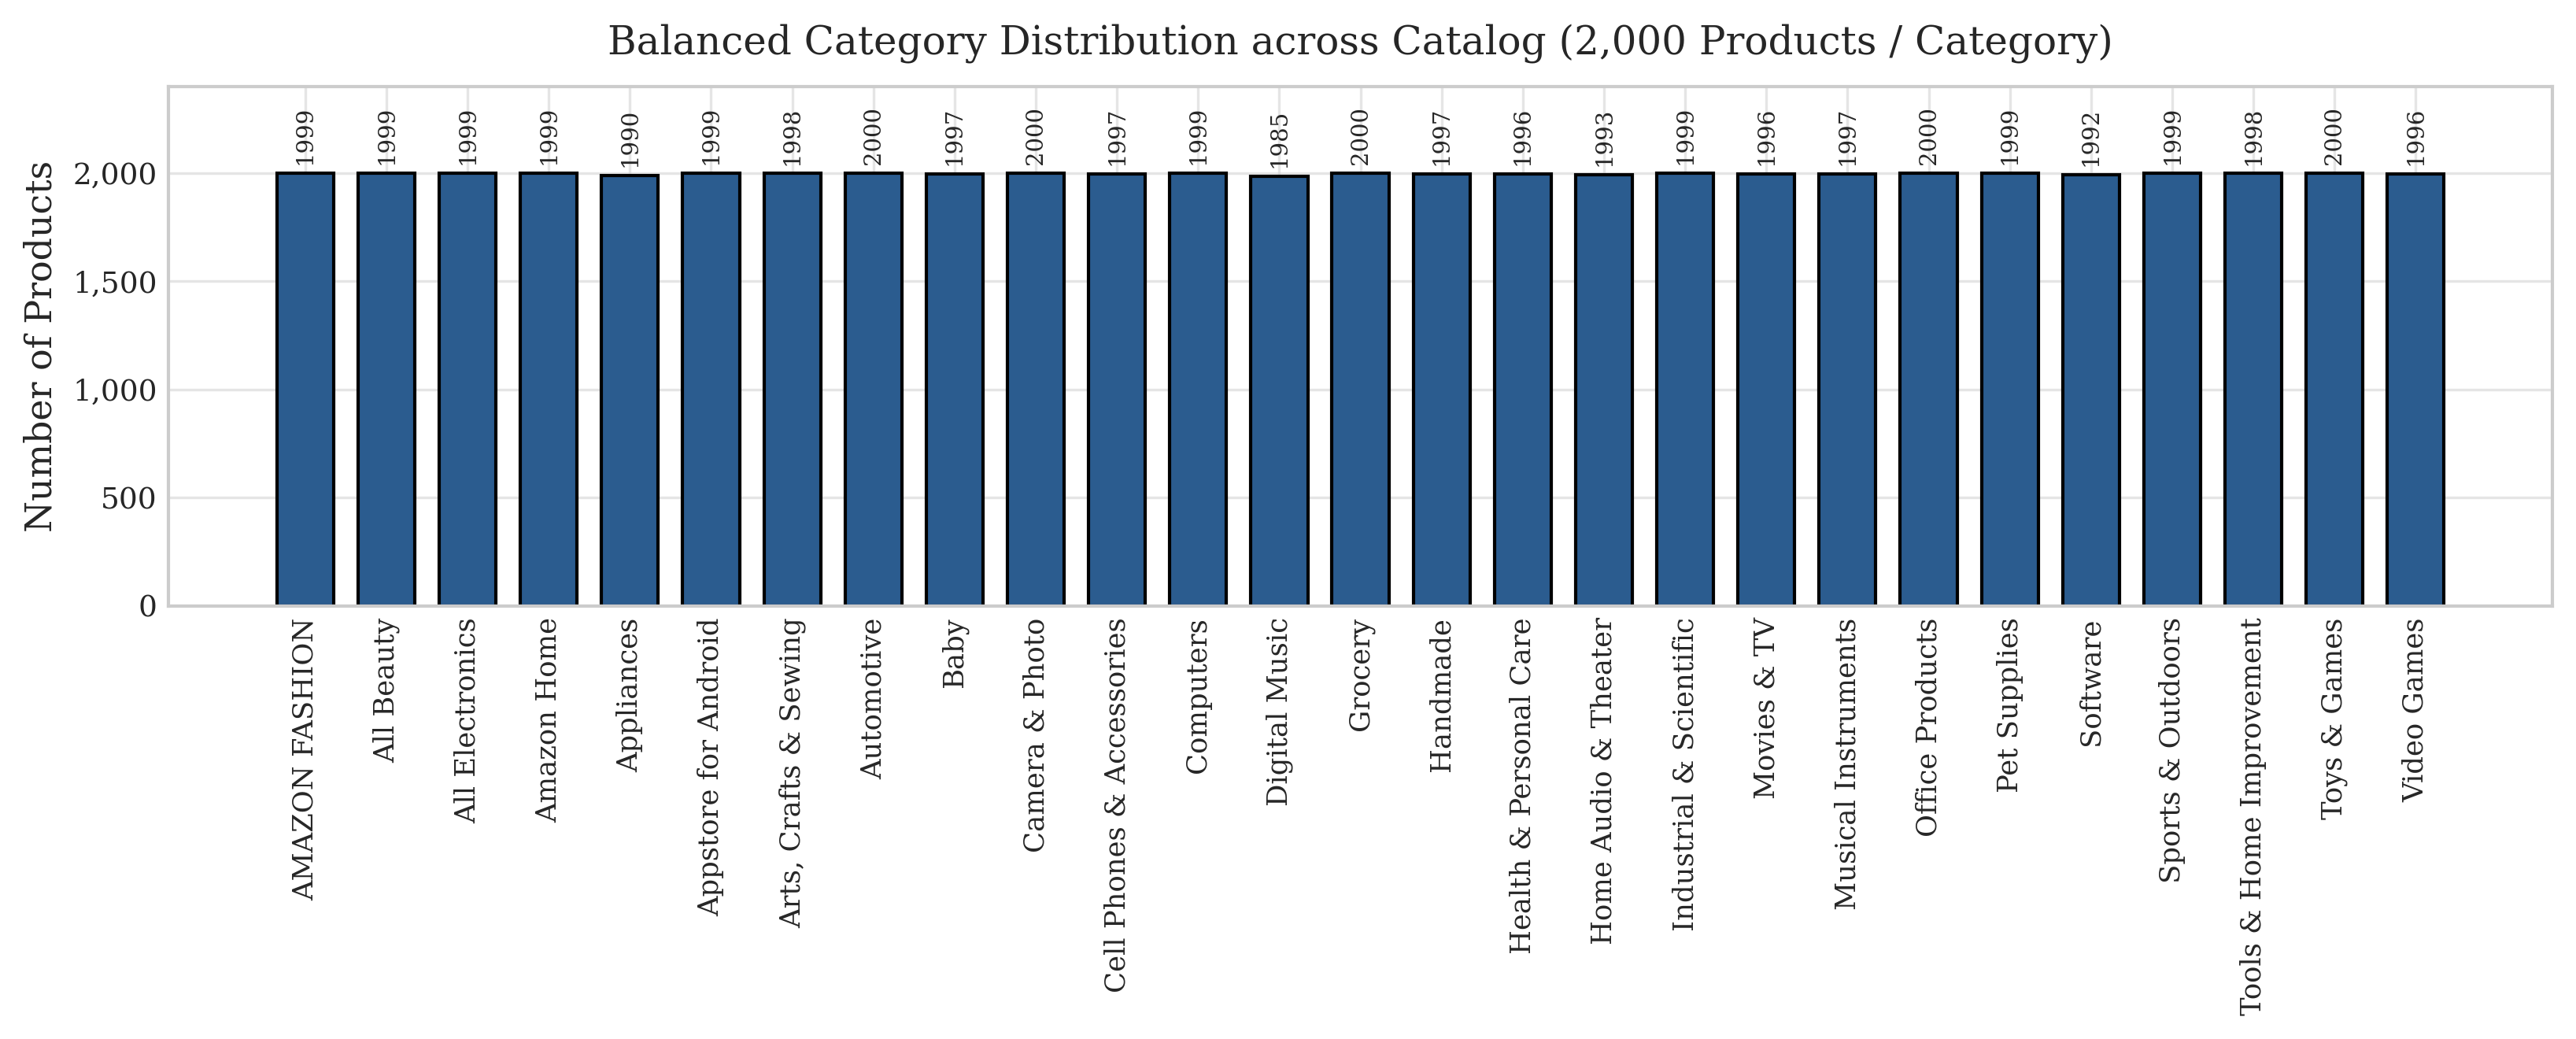
🔧 用TF-IDF余弦相似度取K=50近邻,生成物品-物品伪标签图,再蒸馏进DistilBERT,输出53,923类,标签密度只有0.093%,标签矩阵用CSR只占24.8MB。 🧩 评估严格自排除,把自己的类logit置-∞,不让模型召回自己,避免P@1虚高。 ⚙️ 修正TF-IDF相似矩阵与多标签二值化器的列索引错位;此前会出现P@1<0.1%的假基线,修完后TF-IDF teacher的P@1=98.10%。
📊 DistilBERT学生:P@1=93.15%、P@5=90.08%、NDCG@10=0.8845、MRR@10=0.9545。 📈 TF-IDF teacher上限:P@1=98.10%、NDCG@10=0.9419、MRR@10=0.9882,学生没超过,但把词面向量图的大部分拓扑学回来了。 ✅ 单卡T4约10小时收敛,BERT-base约34小时;十个自然语言查询原型里,情境、跨类、改写、否定约束这些词面模型失效的场景,学生能解出隐式意图。 ⚙️ 到百万商品规模,瓶颈在XMLC投影层内存,论文给了往双塔ANN的落地路线。
这套适合暂时没上ANN、又被BM25词面匹配卡住的检索团队,先拿它当语义蒸馏基线。看结果别只盯P@1,优先看跨类和否定约束query的P@5、NDCG@10;坑在teacher是TF-IDF,学生的上限被词面相似度框住,长尾意图能不能继续涨要看真实query分布。
原文:AlphaXiv