小红书精读:Scaling Articulated Rationales for MLLM-based Recommendation
🔍推荐模型开始读用户“为什么”
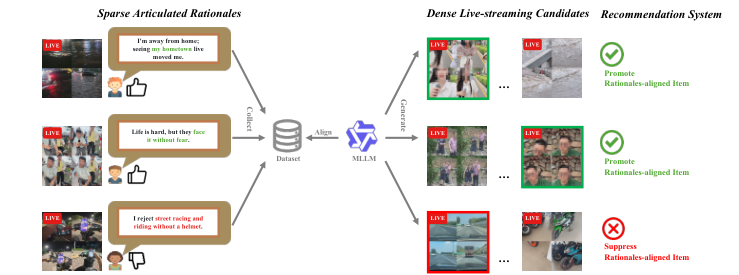
各位算法同学们,推荐系统最擅长学你点了什么,却几乎不学你为什么点。这篇快手 SARA 把问卷里的稀疏理由做成工业可用的排序特征:覆盖从 86,564 个作者扩到 10M 作者,线上还真的涨了 watch time、降了 Hate 反馈。
📄 Scaling Articulated Rationales for MLLM-based Recommendation
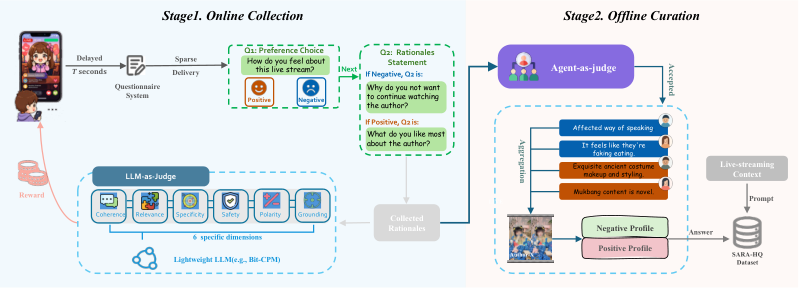
🔧 数据引擎先解决“理由太稀疏”:问卷延迟 10 秒触发、投递概率约 5% 动态调整,再用 LLM/Agent judge 筛质量,攒出 187,532 条 SARA-HQ。
🧩 对齐分两步:先用 SARA-HQ 做大规模 SFT,再用 Quality-Refining DPO 提质量,得到 SARA-7B,让理由生成从问卷覆盖的 86,564 位作者扩到全部 10M 作者。
⚙️ 理由不直接当文本塞模型,而是拆成正负两类特征:正理由进用户-作者交互建模,负理由进 negative-feedback history,用于跨语义相关作者泛化拒绝记忆。
📊 在未见作者上,SARA-7B 生成的 rationale 比通用 MLLM baseline 更 specific、relevant、grounded。
📈 多模态排序 baseline 上,正 rationale 集成让 watch time +0.99%。
✅ 负 rationale 集成让 Hate 反馈 -8.16%。
🕒 支持每日刷新,线上部署超过 30 天。
如果业务里有显式负反馈或问卷入口,这套“先收集再对齐再当特征”的路径可参考;要盯的是 rationale 质量评估器与排序特征的增益是否稳定,别只看生成文本像不像人话。坑在于问卷覆盖和用户疲劳,以及负理由跨作者泛化会不会误伤。
原文:AlphaXiv