小红书精读:MARS: Modality-Aligned Retrieval for Sequence Augmented CTR Prediction
低活用户CTR差?用图文对齐捞相似序列
各位算法同学们:快手上大约35%的用户一个月行为不到1000条,而CTR模型的建模长度已经从10的3次方卷到10的6次方——序列越长,这批低活用户越吃亏。这篇KDD’25的工作换了个思路:行为不够,就从别的模态里借。
📄 MARS: Modality-Aligned Retrieval for Sequence Augmented CTR Prediction
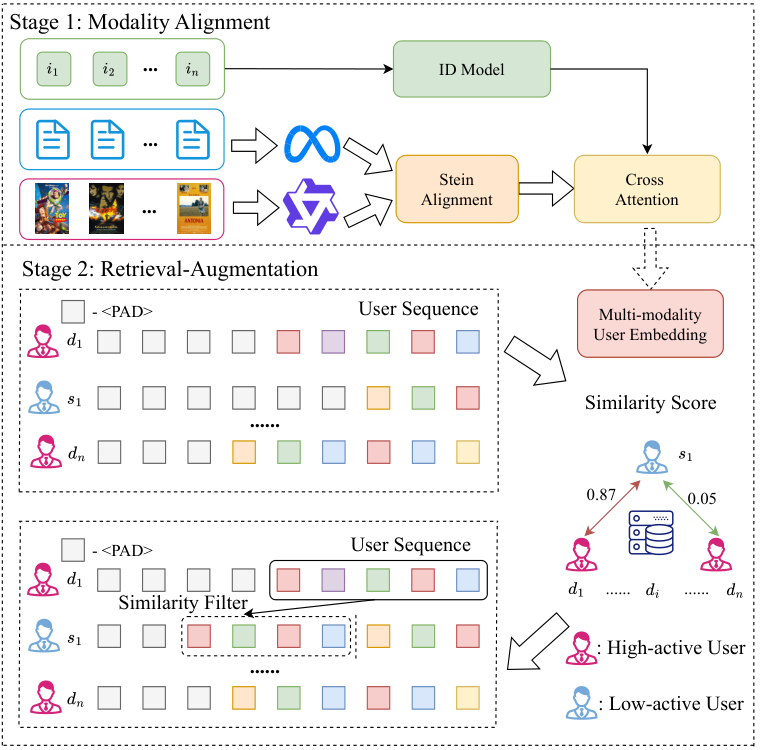
🔧 增强不再只吃协同信号。物品文本用LLaMA编码、图像用ViT编码,再通过Stein核做跨模态分布对齐,把图文压进同一个语义空间,好处是不依赖负采样和大batch,训练更稳。
🧩 增强方式很直接:用对齐后的多模态用户embedding,给每个低活用户检索最相似的高活用户,再按item-user相似度过滤,最后把对方的序列拼进低活用户的历史里。
⚙️ 对齐损失里加了熵正则,防止embedding空间塌缩,保证检索出来的邻居有区分度,而不是一锅端。
📊 快手线上A/B中核心业务指标有增长,已上线服务数亿用户的主流量。
📈 论文给的分布数据是35%用户一个月行为少于1000条,这正说明长序列模型的红利覆盖不到这部分人。
✅ KDD’25,代码匿名开源,仓库 github.com/wangshukuan/MARS,可以自己跑。
总结:这套方法对做低活、稀疏场景排序和召回的团队有直接参考价值,本质是把多模态对齐当成检索的底座。要盯的指标是检索过滤后的序列噪声比例,以及多一路检索加过滤带来的线上延迟;坑在于把高活用户的序列塞进低活用户历史,容易引入语义漂移,过滤阈值设松了会反噬。
原文:AlphaXiv