小红书精读:An Industrial-Scale Sequential Recommender for LinkedIn Feed Ranking
LinkedIn 排序换掉 DCNv2,时长 +2.1% 📈
各位算法同学们,一个排序模型先在线上扛了三个多月流量才发论文,通常说明它真能扛,而不是赶着刷榜。LinkedIn 把 Feed 排序的老 backbone DCNv2 换成了序列 Transformer,A/B 里人均时长涨了 2.10%。
📄 An Industrial-Scale Sequential Recommender for LinkedIn Feed Ranking
🔧 主线是系统-模型协同设计:CPU/GPU 分离部署,shared-context batching 一次给同一请求的几百个候选打分,Arrow 到 tensor 零拷贝传输,还写了自研 Flash-Attention kernel SRMIS,比 PyTorch SDPA 快约 2 倍。
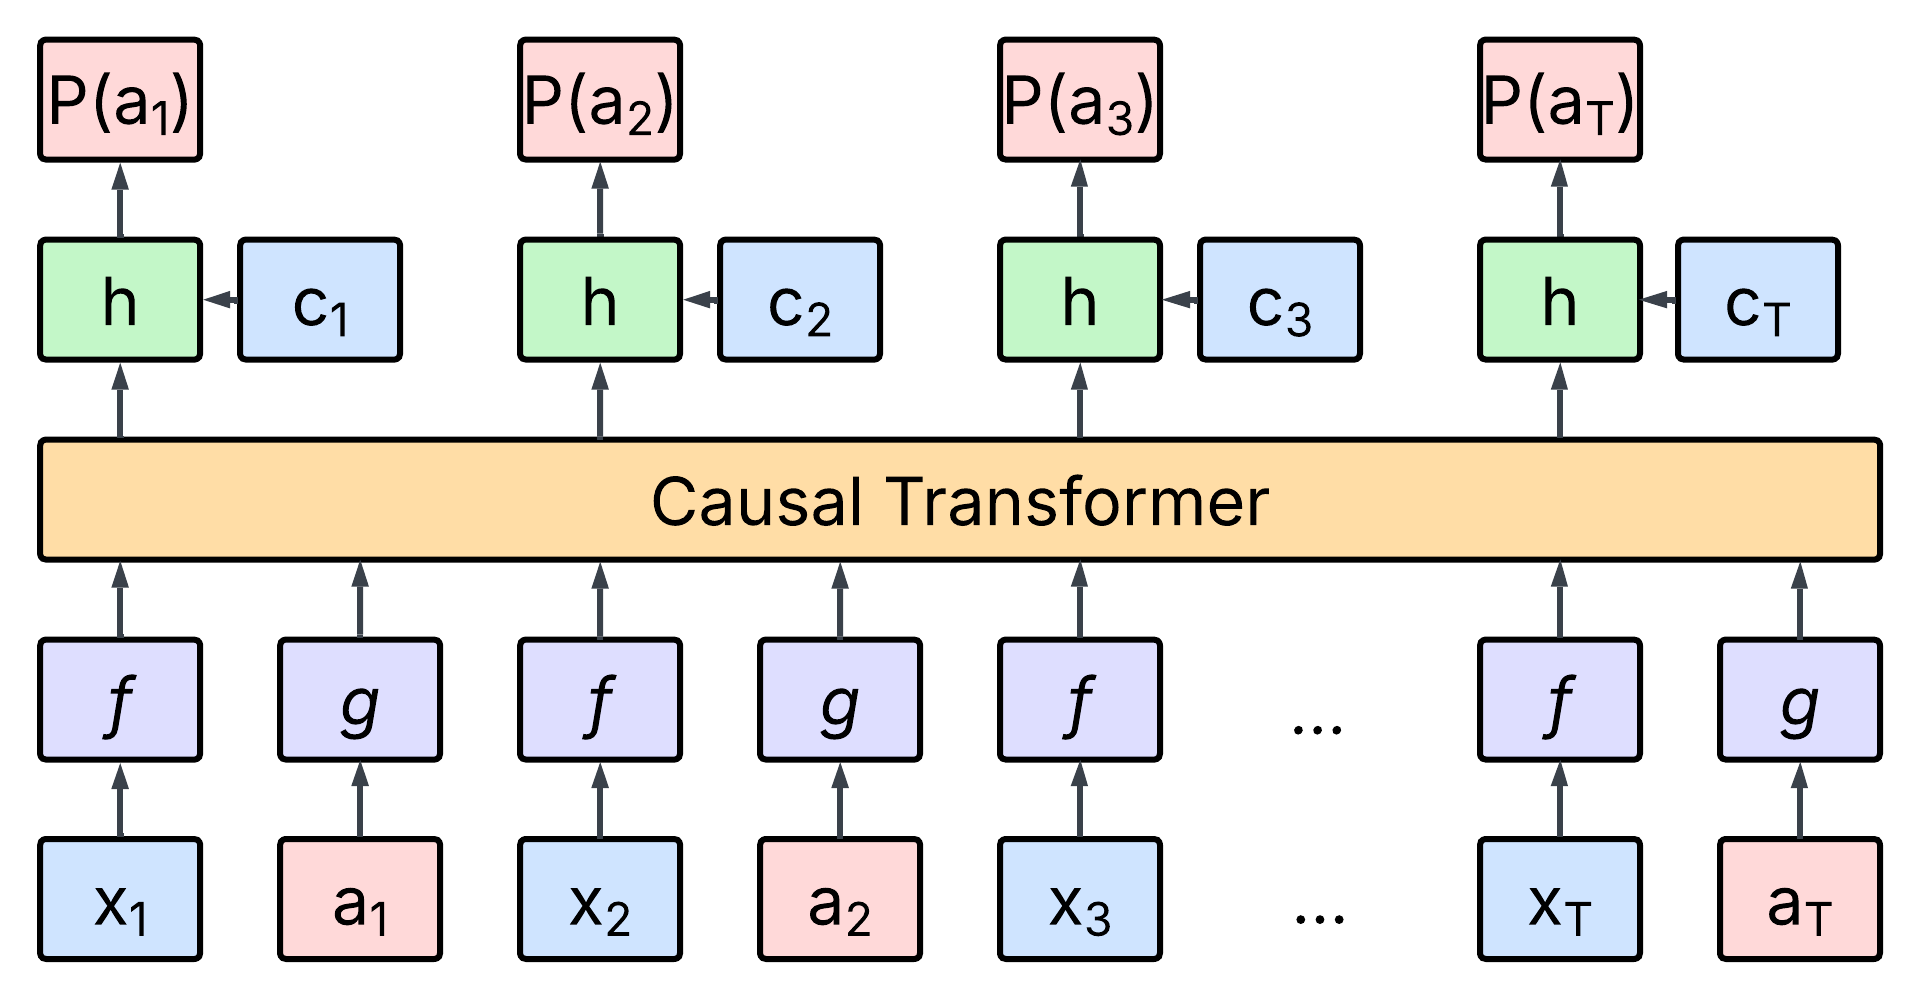
🧩 特征走 late fusion:把一部分 context 特征(主要是 item 热度和 viewer-author 亲和度这类数值信号)从 transformer 前面挪到输出之后拼接。离线 Long Dwell AUC 只掉 0.04%,训练 step 时间少 12%,线上 top-line 指标打平。
⚙️ 两个细节挺反直觉:用 LLM 派生出的会员画像 embedding 补稀疏历史;用 within-session randomization 处理同一次会话内 label 相关性造成的 train-serve skew。另外 attention 用 Softmax 反而比 Sigmoid、SiLU、ReLU 好。
📊 线上 A/B:time spent +2.10%,点赞/评论/转发 +3.52%,baseline 就是生产环境里跑的 DCNv2 ranker。
✅ 覆盖 12 亿会员,已承接 LinkedIn Feed 大部分流量超过三个月,不是小流量试水。
📈 等算力(10^17 FLOPs)下把 transformer block 换成 HSTU 层,Long Dwell AUC 掉 0.21%。
🧩 late fusion 是拿 0.04% 的 AUC 换 12% 的训练提速,线上打平,这笔账划不划算取决于你的训练成本。
总的说,如果你在做工业推荐、被延迟和吞吐卡着上不了长序列模型,这篇的 serving 部分比模型结构该先看。要盯三样:线上时长和互动率、训练 step 时间、train-serve skew 有没有被 within-session 那类设计按住。坑是 1000 条历史是配合 0.1 负采样调出来的,换业务得重调历史长度和采样,别直接搬。
原文:AlphaXiv