推荐算法日报 · 2026-10-30
总览
今天这三篇都围绕推荐系统和语义 ID 打转,整体不算惊艳,但主线挺清楚:一篇在多模态多场景的共享结构上做了个挺有说服力的诊断,一篇想给生成式推荐的 SID 补上 item 之间的关系,还有一篇专门修正 SID 解码时历史层信息混淆的问题。三篇都偏向离线实验,提升幅度普遍只有千分位到几个百分点,而且没有线上验证,所以看的时候要把它们对问题的洞察,和它们报出的数字分开评估。我个人最推荐先读第三篇,因为它先用 mask 实验把“层级别混淆”这件事讲清楚了,再顺势改结构,逻辑最顺,工程收益(更快、更省显存)也最实在;其次是第一篇,那个“多模态早融合反而打不过场景独立 MLP”的发现值得所有做多场景的人警惕,但它的方法堆得偏多,收益也偏薄,读的时候多留意消融。第二篇的思路干净,但多一个预训练阶段、外加前缀树上的蒸馏,带来的复杂度与涨幅不太匹配,暂时当成思路参考更合适。今天优先看 LESSRec 和 DuTri,第二篇快速翻一下 HCPD 那部分就行。
论文列表
1. DuTri: Dual-Branch Modeling with Triadic Factorization for Multimodal Multi-Scenario Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-10-27 08:35 UTC
- 机构:College of Computer Science and Software Engineering, Shenzhen University,Shenzhen Technology University
- 工业优先级:中
- 备注:12 pages, 7 figures
多模态塞进多场景模型,反而更差?
各位算法同学们,把多模态特征直接放进 STAR、HMoE、HierRec 这类多场景骨干,效果可能还不如“每个场景各配一个 MLP”的简单结构。这篇论文先做了控制实验来验证这个判断,再给出解决方案,有意思的地方在于它质疑了“直接复用共享架构”这个默认做法。
📄 DuTri: Dual-Branch Modeling with Triadic Factorization for Multimodal Multi-Scenario Recommendation
🔧 协作分支对 user–scenario–item 三元交互做 CP 分解:用户因子和物品因子跨场景共享,场景因子去调制两者的交互,再叠加残差量化把连续偏好变成结构化表示,跨场景共性和场景差异由一个结构同时承接。
🧩 双分支拆开:协作分支只负责 ID 侧偏好,多模态分支则用学到的用户偏好和场景偏好去指导 ID、文本、图像的自适应融合,让各模态的贡献随用户和场景变化,而不是全局一套权重。
⚙️ item 级对比学习把协作物品表示和多模态表示拉齐,两个分支之间有信息往来,而不是各算各的、最后拼接。
📊 AntM²C 上 5 个场景 S1–S5、5 个随机种子取平均:ID-only 输入时三个 MSR 骨干都优于 Scenario MLP,换成多模态输入后结论反转,Scenario MLP 在每个场景的平均 AUC 都更高。
📈 Amazon 上趋势一致,作者把结果放在附录 A.1。
✅ DuTri 在 AntM²C 和 Amazon 两个真实数据集上整体 AUC 超过现有多模态和多场景 baseline,消融实验确认 CP 分解、残差量化、跨分支对齐三项各自有贡献。
🧠 如果你在做多场景 + 多模态的精排或召回,先跑一个“每场景单独 MLP”的对照,别默认骨干的共享机制还成立;评估时盯分场景 AUC,而不只是平均值。要注意的坑:CP 分解加残差量化多了一套超参(秩、码本大小),摘要只给了结论,具体涨幅得翻正文表格逐个 baseline 对一遍。
2. REGER: Modeling inter-item Relations with Semantic IDs for Generative Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-10-27 17:25 UTC
- 机构:University of Electronic Science and Technology of China
- 工业优先级:中
- 备注:13 pages, 6 figures
SID学不会物品关系?这篇补了三处
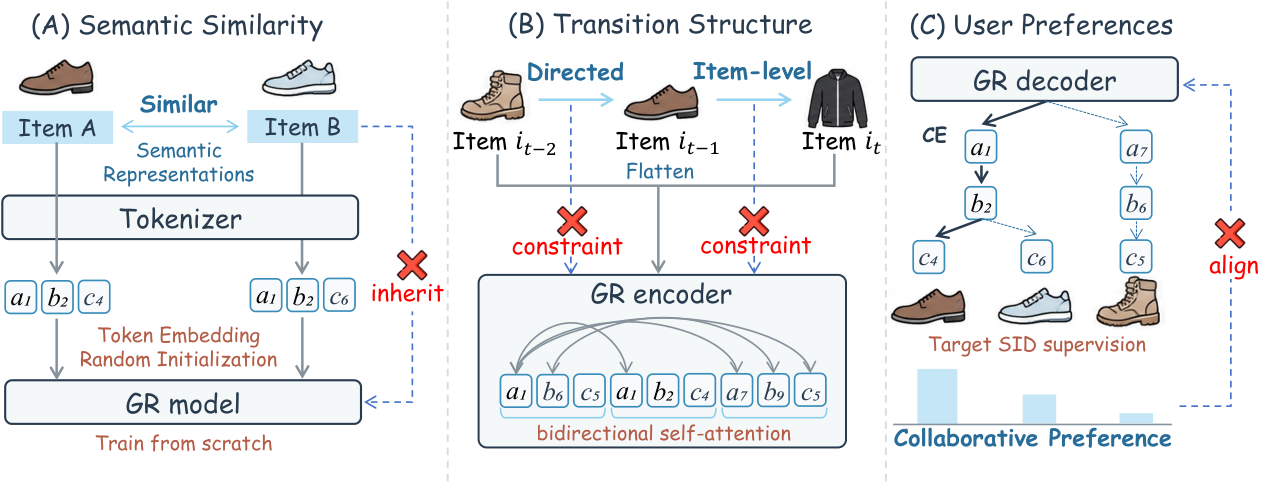
各位算法同学们,生成式推荐里有个被默认接受的事实:SID 的 token embedding 是随机初始化的,模型从零开始训,item 之间在连续空间里本来就有的语义关系,它压根没继承过。这篇 REGER 就是把“物品间关系”从隐式学习改成三处显式注入。
📄 REGER: Modeling inter-item Relations with Semantic IDs for Generative Recommendation
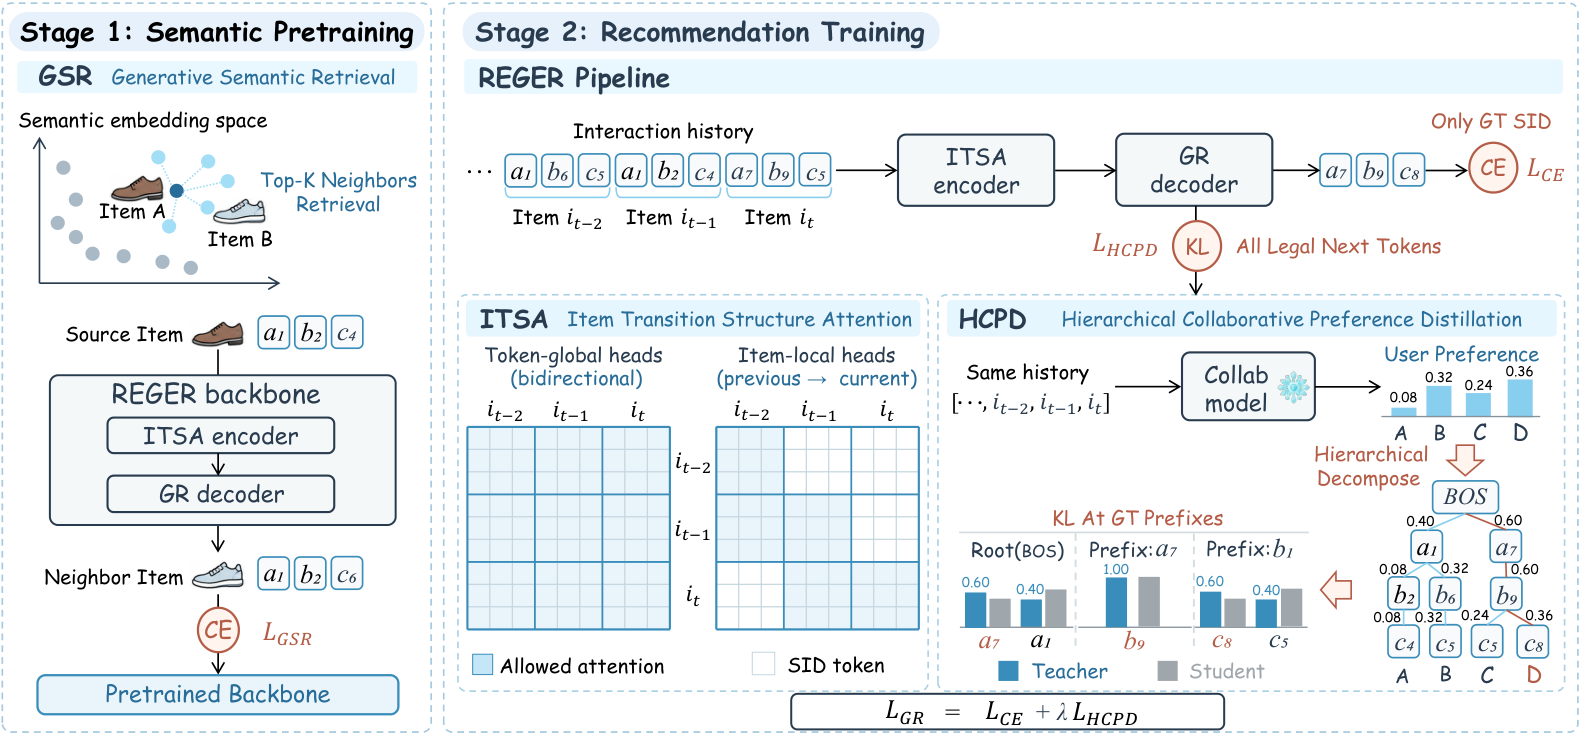
🔧 预训练阶段加了生成式语义检索(GSR):输入一个 item 的 SID,让 decoder 生成语义近邻的 SID,先让 token embedding 和整个 GR 模型学会“谁和谁像”,再去学用户偏好。
🧩 历史编码阶段提出 ITSA:把注意力头拆成两拨,全局头照旧做双向自注意力,局部头用对齐 SID 完整边界的窗口,只看当前 item 和它的前一个 item,把有向转移关系变成结构性约束而不是靠模型自己悟。
⚙️ 生成阶段提出 HCPD:把 SID 组织成前缀树,证明判别式推荐器估的物品偏好分布可以精确分解为各前缀上合法下一 token 的条件分布,item 级 KL 也能拆成前缀条件 KL 的加权和;据此在目标 SID 路径的真实前缀上蒸馏 teacher 的完整条件分布,和交叉熵联合优化。
📊 在 6 个真实数据集上做的实验,覆盖了主流的 GR baseline。
📈 相对现有 GR 方法是一致性提升,不是只在个别数据集上赢。
✅ 消融实验单独验证了偏好蒸馏这一项确实在起作用,论文同时报了 HCPD 的效率。
🧪 三个挑战(语义相似、转移结构、用户偏好)分别对应三个模块,拆得比较干净,方便复现时逐个开关。
总结一下:如果你在做生成式召回或者 SID tokenization,这篇的三段式思路可以直接拿来对照自己 pipeline 里哪一环是隐式的。要盯的指标是前缀条件 KL 有没有真的降下来,以及长尾 item 上的收益是否被头部吃掉。坑在于 HCPD 依赖一个判别式 teacher,teacher 本身训不好,蒸馏过去的就是噪声;另外局部注意力窗口和 SID 长度绑定,换 tokenizer 得重新调。比起只改 tokenizer 的那类工作,它更像是改训练目标,和 hybrid 检索路线不冲突,可以叠。
3. LESSRec: Level-Specific History Modeling for Semantic ID-Based Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-10-27 14:11 UTC
- 机构:Chongqing University,Griffith University
- 工业优先级:中
🎯同层历史才管用,跨层多半是干扰
各位算法同学们,如果把用户历史按语义层级切开、每次预测只让解码器看和目标同层的那一条序列,召回反而比看全部历史更高——而且只用了四分之一的 token。这篇就是在 TIGER 上把这件事做实了,顺手改了解码器的注意力结构。
📄 LESSRec: Level-Specific History Modeling for Semantic ID-Based Recommendation
🔧 先给结论找证据:作者不改参数、只改 TIGER 解码器的 cross-attention mask,让每个目标位置只看某一层的历史 token。可见 token 数不变,越多的目标位置对上自己那一层,效果越好;全部对齐后历史可见量只剩 1/4,Recall@10 仍略高于原始 TIGER。
🧩 两个配套设计:Level-Isolated Self-Attention 让编码器里每个语义 token 只和跨物品的同层 token 交互,EOS 可以看全部但不能把信息回流;Level-Aligned Cross-Attention 让预测第 r 层 token 时只看第 r 层历史,从源头断掉跨层混合。
⚙️ 只靠单层会丢物品整体语义,所以再加一条 Item-Level Semantic Sequence:把每个历史物品各层编码表示平均池化成物品级表示、按交互顺序排好,解码器用第二条 cross-attention 分支读它,再和同层上下文融合。LESSRec+ 则把编码器层按层级拆成独立分组、总参数量不变,省掉被 mask 掉的那部分计算。
📊 Games 数据集 Recall@10:全对齐比全错配高 11.59%(标准编码),在层级隔离编码下这个差距拉到 49.46%。
✅ 全部目标位置对齐时,模型只用约四分之一的历史 token,指标仍略微超过无限制访问的 TIGER。
📈 结论在三个公开数据集、三种 tokenizer 上都成立,消融也支持 LIS、LAC、ILS 各自的作用;LESSRec+ 的效率分析显示编码侧计算和中间激活都降了。
我的判断:如果你在做 semantic ID 生成式推荐、解码器现在是无差别 attend 所有层级的历史 token,这套 mask 改造几乎不动参数就能试,优先盯你自己 tokenizer 下的 Recall@10 和 NDCG@10,并且一定和同参数量的 TIGER 对齐比。坑有两个:语义层级数 L 变了,同层收益的幅度可能跟着变;ILS 用的是对各层表示做平均池化,细粒度差异会被压掉,物品级分支的权重别设太大,否则又绕回跨层混合。