推荐算法日报 · 2026-10-29
总览
今天这批五篇整体质量不错,主线很清楚:生成式推荐在往工程化落地方向发展,大家不再只谈结构创新,而是在解决上线时真正会卡住的问题。最值得细读的是拍立淘那篇多模态生成检索,它把意图标签、路由模型全部去掉,用原生 VLM 直接输出商品 SID,还给出多档思考预算下的质量-成本操作点,线上 IPV 和 GMV 都有显著涨幅,是一份难得的端到端规模化样本;另一篇值得看的是浙大和阿里做的那篇多目标蒸馏,方法说穿了就是按 token 的 KL 难度重新分配 teacher 权重,改动小到可以 plug-and-play,但有十亿级工业离线数据和线上 A/B 支撑。美团那篇潜在残差推理的思路我很喜欢:冻结主干只学修正量,消融里端到端训练反而最差,说明功能分离是必要的而非锦上添花,可惜增益集中在第一步,候选规模上去之后的开销也没讲清楚;快手那篇参数继承解决的是扩参后收敛慢的真实成本问题,省 72% 训练窗口的账很实在,但精度提升小到可以忽略,而且没有线上验证。腾讯和武大那篇 CTR 位置编码要先接受一个反直觉结论:LLM 那套位置编码搬到 CTR 上基本无效,NoPE 反而最强,这个负面结果本身就值得读,方案里的时间分组双向注意力也算务实。今天优先看拍立淘多模态检索和 KL-MOPD 这两篇,前者看怎么把生成式检索真正推到线上,后者看小改动怎么在工业场景里兑现收益;做排序和扩参的同学再补美团和快手那两篇。
论文列表
1. PailitaoMMSearch2.0 Technical Report: Scaling Generative Retrieval to Unified End-to-End Multimodal Search
- 论文链接:AlphaXiv
- 更新时间:2026-10-27 10:17 UTC
- 机构:Taobao & Tmall Group of Alibaba
- 工业优先级:强
- 备注:PailitaoMMSearch2.0 Technical Report
一个模型吃掉三种搜图意图🔍
各位算法同学们,淘宝拍立淘线上 A/B 里交易数涨了 27.04%,但模型没加意图分类器,也没为“相似/改款/搭配”各开一条链路。它用原始图片加自由文本指令直接生成商品 Semantic ID,这篇报告讲的是生成式检索怎么从单场景解耦。
📄 PailitaoMMSearch2.0 Technical Report: Scaling Generative Retrieval to Unified End-to-End Multimodal Search
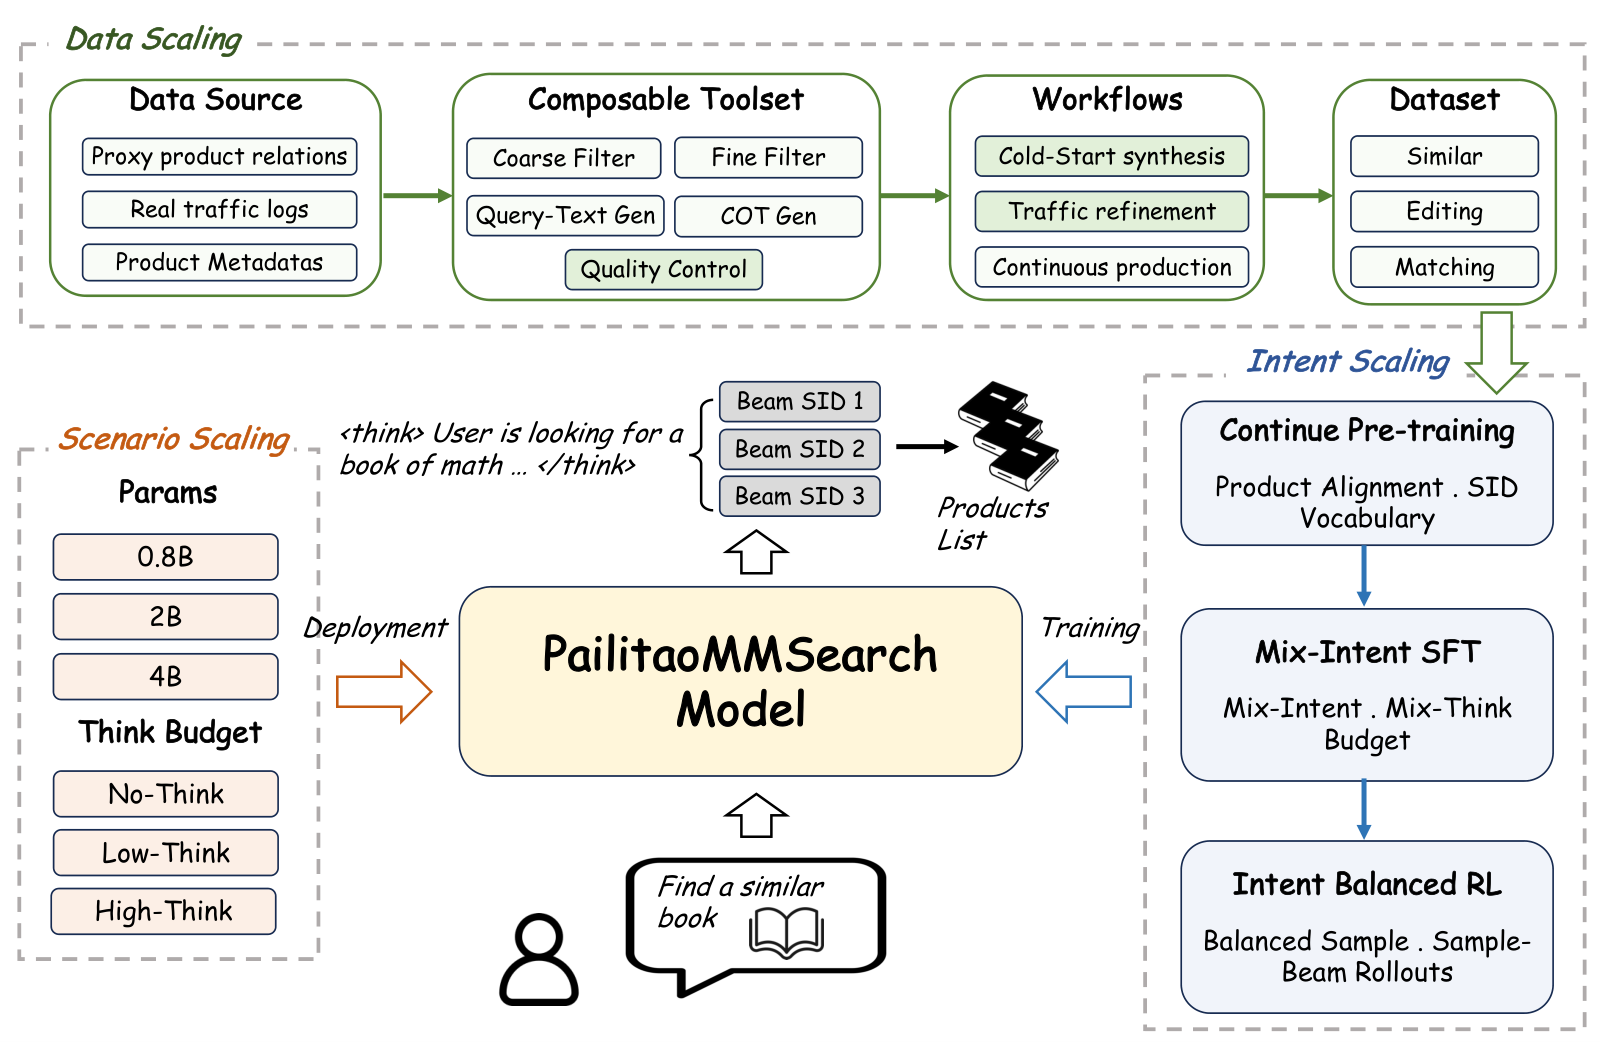
🔧 数据侧不靠堆日志:一套可组合工具做冷启动合成、质量过滤、真实流量修正和持续生产,再按意图与生命周期拼成工作流。
🧩 意图侧把相似、编辑、匹配塞进同一个策略:CPT 先对齐商品知识和 SID 词表,混合预算 SFT 教多种推理档位,RL 再统一优化。
⚙️ 场景侧用 0.8B/2B/4B 模型容量和 No/Low/High-Think 预算切质量-成本点,不引入路由模型,服务时只选配置。
📊 商品用三级 SID、每级 8192 码本,解码出候选集就是检索,省掉对全库打分。
📈 Sample–Beam RL 的 macro Excellent Rate 比 SFT 高 5.97 个点;rollout 采样推理轨迹、beam 解码商品 SID,跟线上多候选服务对齐。
✅ 拍立淘线上 A/B:商品页浏览量 +17.90%,交易数 +27.04%,GMV +8.94%,统计显著。
做电商多模态检索或生成式召回的同学,可以盯它的数据工具链和 Sample–Beam 设计;落地坑在 SID 码本与商品更新的一致性、推理预算带来的 P95 延迟,以及 RL 奖励能否覆盖长尾意图。和“向量召回+意图路由”比,它省的是系统复杂度,不是训练成本。
2. KL-MOPD: Discrepancy-Aware Multi-Objective On-Policy Distillation for Generative Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-10-27 10:28 UTC
- 机构:Zhejiang University,Alibaba Group
- 工业优先级:强
多目标蒸馏:难教的teacher会换人
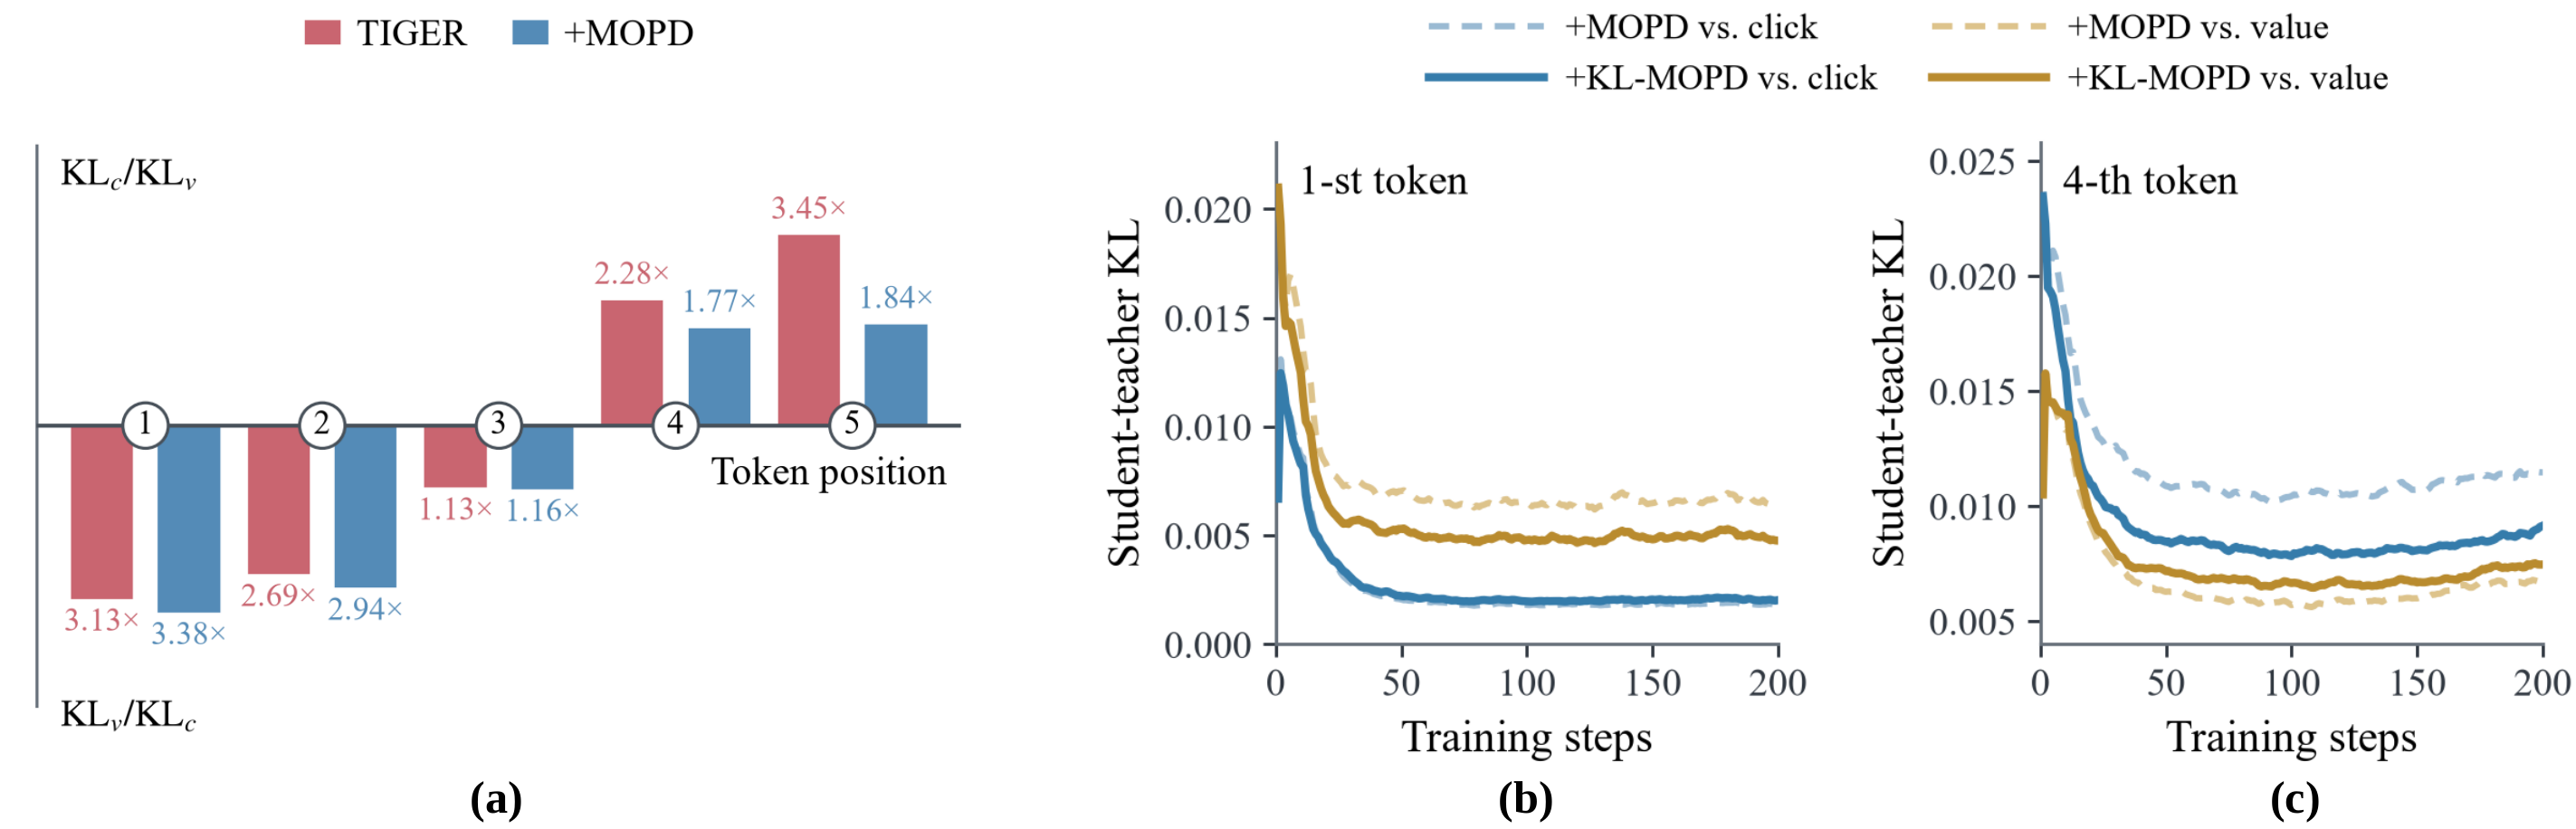
各位算法同学们,在同一个 token 上,初始 student 到 value teacher 的 KL 是到 click teacher 的 3.13 倍;到了第 4 个 token,难教的那个换成了 click teacher。等权多 teacher 蒸馏就会在每一步都欠拟合一个目标。
📄 KL-MOPD: Discrepancy-Aware Multi-Objective On-Policy Distillation for Generative Recommendation
🔧 把多目标 on-policy 蒸馏方法 MOPD 搬进生成式推荐:item 级多目标方法只看整条物品,但生成式推荐(GR)要每个 token 都选对才能召回正样本,所以改成在 student 自己采样的轨迹上,逐 token 对齐两个单目标 teacher 的 next-token 分布。
🧩 指出 vanilla MOPD 的两个问题:token 级不平衡,每步两个 teacher 难度不同;跨 token 不一致,难教的那个会沿解码步切换。等权设置对这两点都没反应。
⚙️ 解法很轻:按初始 student 到各 teacher 的 token-wise KL 比例,分配该 token 上的 teacher 权重,难教的那一方多给监督;权重在训练前一次性算好,不增加前向计算,即插即用,并证明在双目标加性联合目标下严格优于 vanilla MOPD。
📊 三个公开 benchmark、八个 baseline,多数是 2026 年新工作:单目标平均提升 4.91%,联合目标平均提升 4.12%,也超过最强单目标 teacher 本身。
📈 到两个 teacher 的平均 item-wise KL 降了 13.70%,不是靠牺牲一个目标换另一个。
✅ 十亿级工业数据(49M 用户、158M 广告)离线联合指标提升 3.19%;10% 流量线上 A/B 广告收入提升 1.63%、GMV 提升 2.20%。
判断:做多 teacher 蒸馏或多目标 GR 的同学可以先试,改动只在 loss 权重,不碰模型结构,能在已有 MOPD 管线上快速验证。重点看每个 token 上两个 teacher 的 KL 比值有没有收敛,以及联合指标是否超过单目标 teacher;只涨单目标、联合不动,说明权重没起效。风险是权重依赖初始 student,换初始化、换 teacher、加第三个目标都要重新计算并重新验证,理论保证也只覆盖双目标加性形式。
3. Latent Residual Reasoning for Ranking in Generative Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-10-27 09:25 UTC
- 机构:University of Science and Technology of China,Meituan,Renmin University of China,The Hong Kong Polytechnic University 等 5 家机构
- 工业优先级:强
- 备注:Accepted by CIKM 2026
别急着一次打分,让模型多想几步🔧
各位算法同学们,排序模型现在基本都是“快思考”:一次前向直接吐分。这篇偏要问一句——多算几步,能不能把候选的分打得更细?而且它没重训线上模型,只挂 LoRA,这点才是它真正有意思的地方。
📄 Latent Residual Reasoning for Ranking in Generative Recommendation(CIKM ‘26,USTC / 美团 / 人大 / 港理工等)
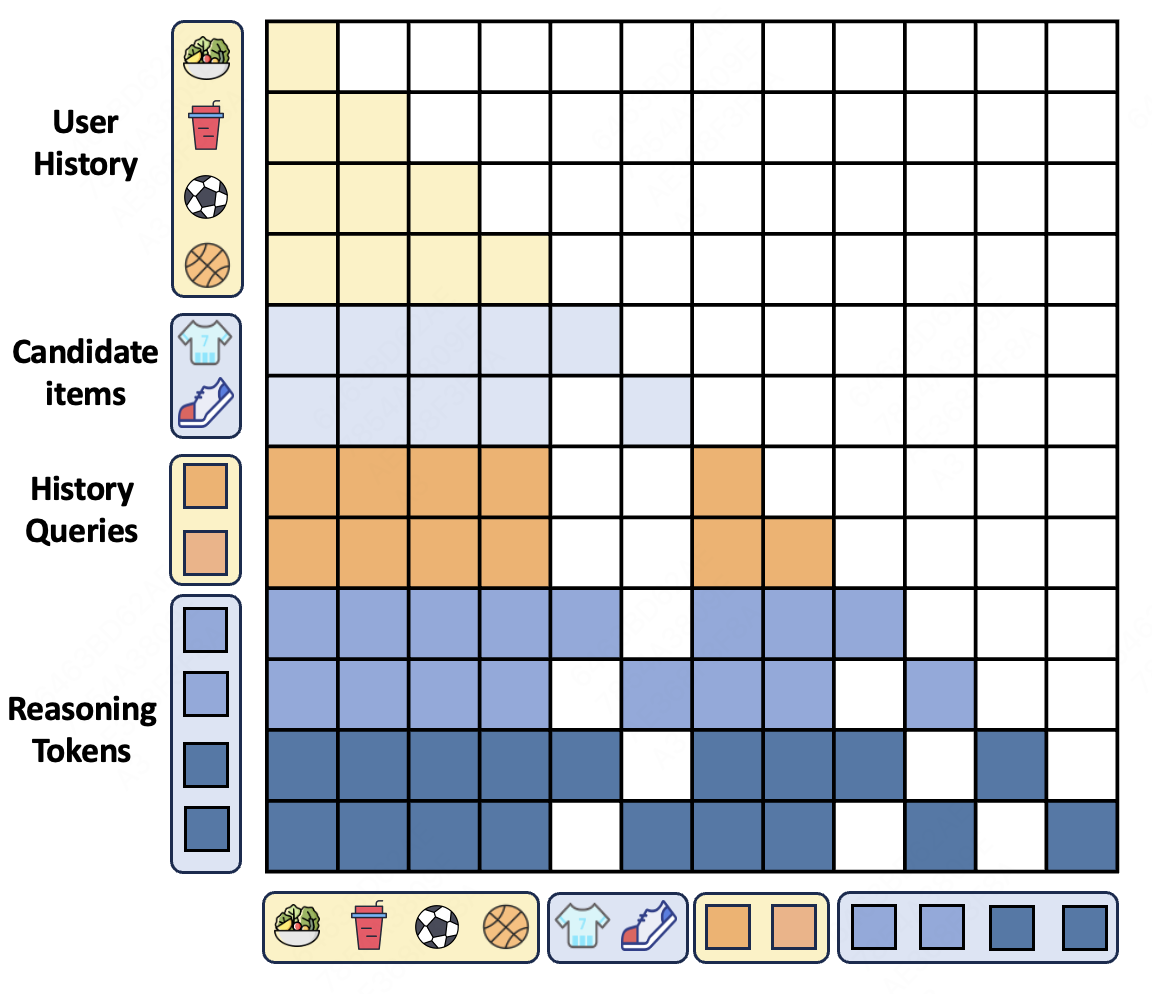
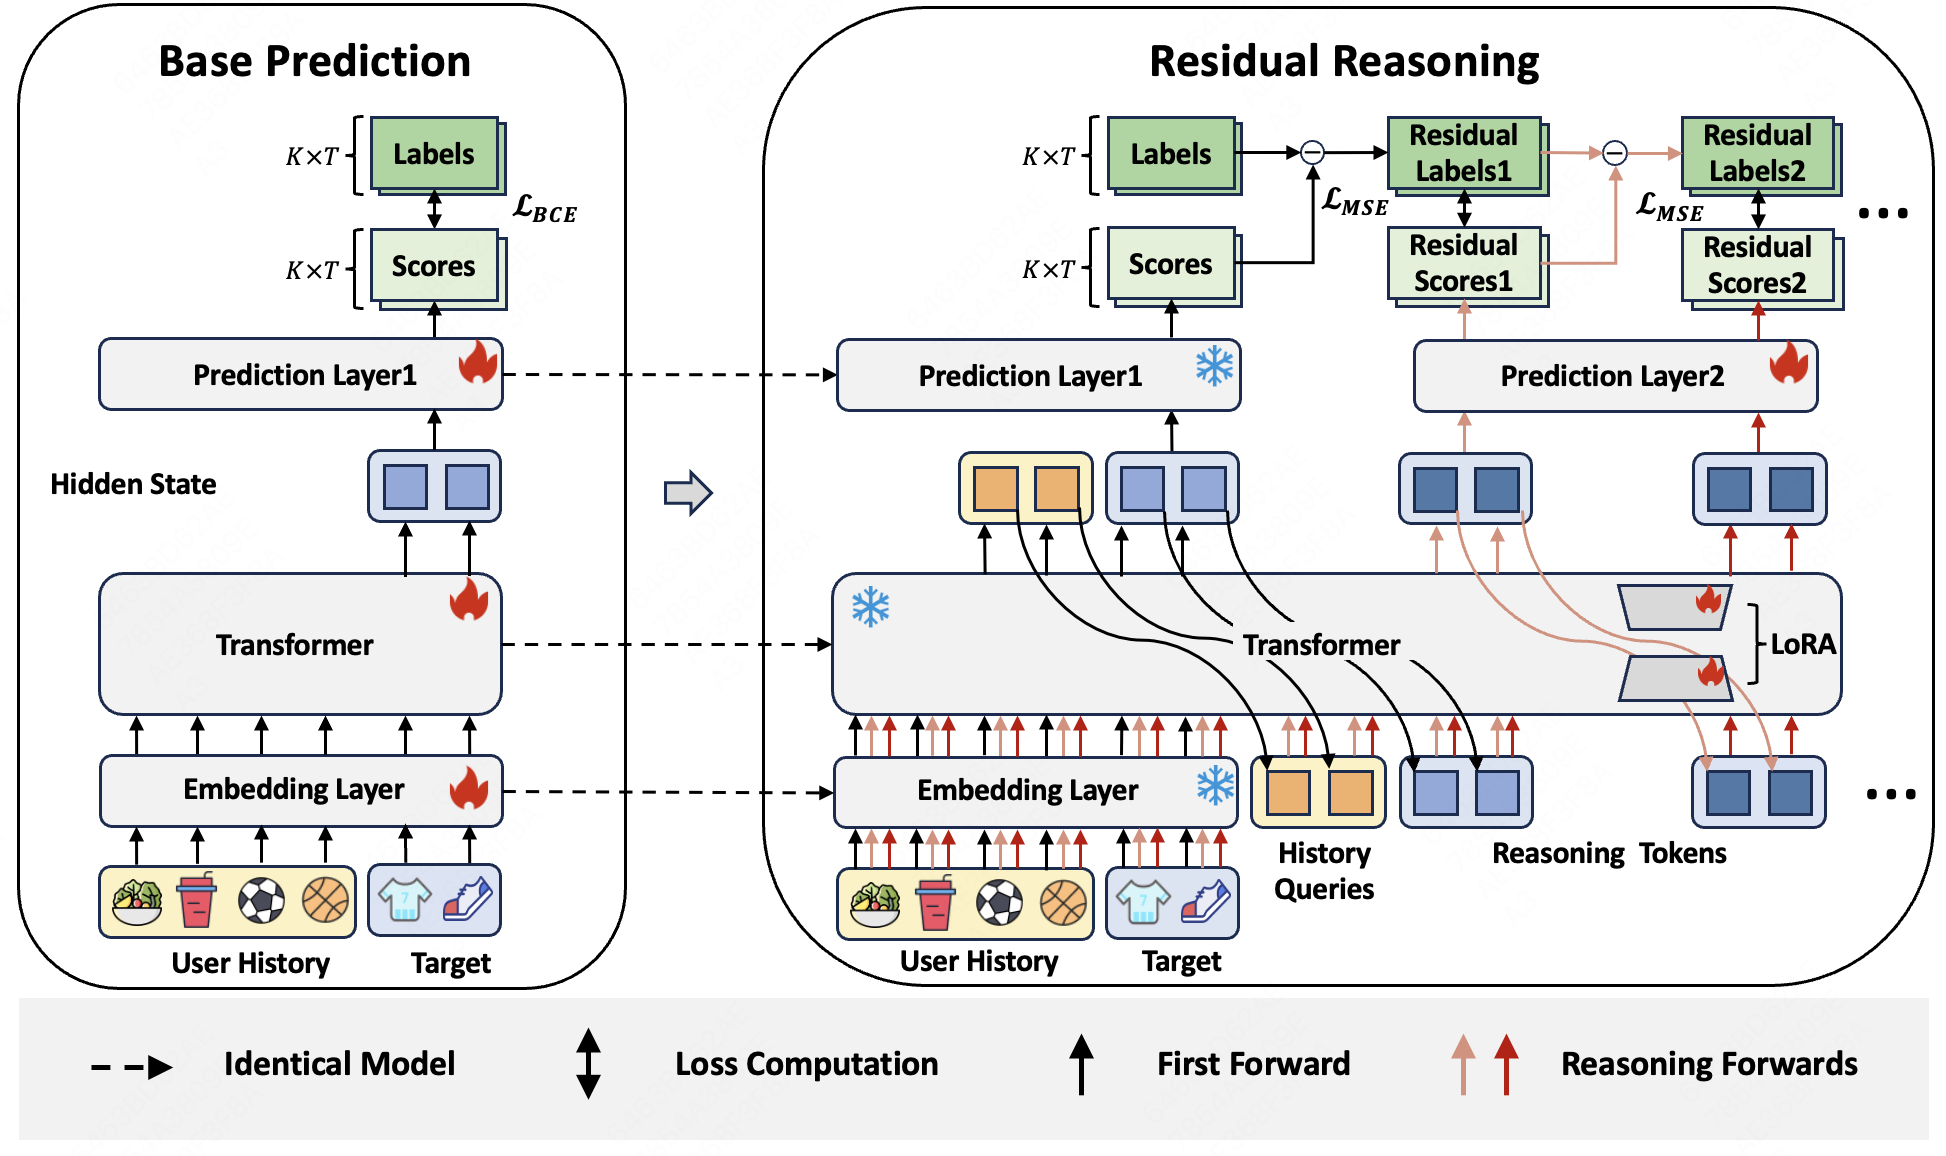
🔧 残差式潜空间推理:不在每一步重新预测完整分数,而是让第 r 步只学“对上一步的加性修正”,逐步累加。这样一来,每步的监督信号天然对齐排序目标,而不是语义 ID 生成那套目标。
🧩 history queries:候选并行打分时,每个候选各带自己的 reasoning token,容易丢掉全局用户信息。作者从用户行为序列里压出一组 history query,给候选特定推理补一个全局视角。
⚙️ 冻结底座加 LoRA 加独立推理预测层:不改主干、不换在线模型,只做参数高效适配。对工业团队来说,这决定了它是“能上线”还是“只能发论文”。
📊 验证覆盖 2 个公开 benchmark、1 个大规模离线工业数据集、1 次线上 A/B,三个层面都做过,不是只在小数据集上刷点。
📈 落在 2 个排序模型上跑,其中包含线上在部署的 MTGR,说明不是挑了个好欺�负的底座。
✅ 作者点名的增益场景是冷启动物品和长序列、行为复杂的用户——这两类恰好是直接预测最容易欠拟合的地方。具体涨点数字在正文表格里,摘要没给,别信二手转述的百分比。
总结:做生成式排序、又不想动线上主模型的团队可以看,思路是“用推理步数换分数精度”,路径比端到端重训温和得多。要盯三件事:一是离线 AUC 涨了之后 CTCVR 和冷启分桶是否同步涨,二是推理步数与延迟的收益曲线在哪一步开始变平,三是 LoRA 分支和主模型版本的同步维护成本。坑在这儿:多步推理是实打实的算力开销,如果只在小流量场景试,收益很容易被延迟抵消掉。
4. Inherit4Rec: Parameter Inheritance for Efficient Scaling of Recommendation Models
- 论文链接:AlphaXiv
- 更新时间:2026-10-27 03:27 UTC
- 机构:Kuaishou Technology,Shenzhen Technology University,City University of Hong Kong
- 工业优先级:强
0.31B扩到1B,省下72%训练时间
各位算法同学们,推荐模型从0.31B扩到1B,最贵的其实不是卡,是重新收敛要等近50天。快手联合深技大、港城大这篇 Inherit4Rec,做的是把LLM里的“参数继承”真正搬到流式推荐的动态数据上,解决继承完一恢复训练就掉点的老毛病。
📄 Inherit4Rec: Parameter Inheritance for Efficient Scaling of Recommendation Models
🔧 D2D 扩容:扩FFN时复制输入投影,新输出投影初始化成“贡献相加为零”,扩容那一刻前向输出和原模型完全一致;老参数带着优化器状态和LR schedule一起走,新参数给全新状态和单独schedule,绕开梯度对称和新参数学不动两个坑。
🧩 D2S 转换:不按权重聚类,而是拿真实训练样本的通道输出贡献挑出常驻的shared expert,再把对同一批输入共同激活的通道分成等大的routed expert,shared+top-1激活,配标准load-balancing loss。
| ⚙️ 真正的差异点:增长和分区都吃当前数据分布的统计量,不是只看预训练权重,所以面对漂移的P(X)和P(Y | X)不会一上线就崩。 |
📊 工业短视频数据集上,0.31B扩到1B,GAUC相对继续训原模型有显著提升。
📈 D2S 相比从零训的Dense和SMoE,GAUC只有很小的下降,没有出现断崖。
✅ 复用已有checkpoint,比从零训目标模型省72%的GPU训练时间。
📉 图2里直接套LLaMA-MoE、GMoEfication、bert2BERT那套,恢复训练后GAUC掉幅一路压到接近-0.9%的下限,Inherit4Rec基本贴着原Dense走。
我的判断:如果你们团队正按“小模型→大模型→更大”的节奏反复重训,这篇的收益最直接,落地时重点盯扩容后前两周的GAUC恢复曲线,以及各expert的负载是否偏斜。坑有两个:D2S的分区依赖训练样本统计,大促或新品类导致分布快速切换时得分区重算;shared expert挑多少通道、routed expert切几份,是要重新调的旋钮,不是拿来即用。
5. Rethinking Positional Encoding and Interaction Granularity for CTR Prediction
- 论文链接:AlphaXiv
- 更新时间:2026-10-27 12:35 UTC
- 机构:1 Wuhan University, China; 2 Tencent Inc., China; 3 Peking University, China
- 工业优先级:中
- 备注:13 pages, 11 figures
CTR里的位置编码,可能一直是负收益
各位算法同学们,先问一句:Transformer 做 CTR,位置编码真的有用吗?这篇在 KuaiRand 上把 OneTrans 的 6 种位置编码全试了一遍,没有一个打赢直接不加位置编码(NoPE)。作者顺着这个反常识现象往下挖,重新追问了两件事:CTR 到底需要什么位置信息,历史行为该在什么粒度上交互。
📄 Rethinking Positional Encoding and Interaction Granularity for CTR Prediction(武大、腾讯、北大)
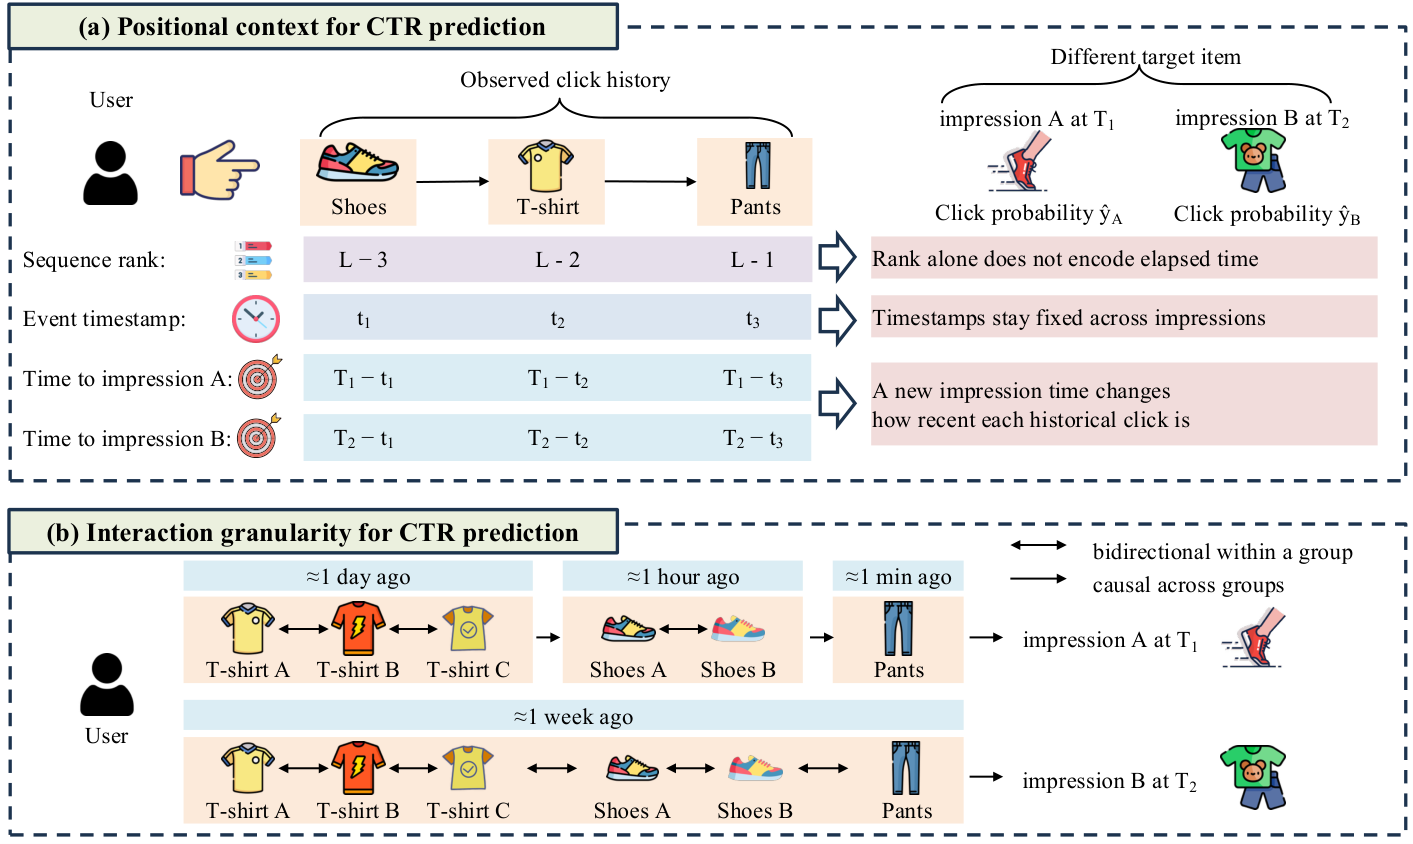
🔧 位置信息其实有三层:序列 rank、事件时间戳、以及行为到当前预测目标的相对时间。前两个在固定历史里不变,但“距目标多远”会随每次曝光变化,同一个 rank 在不同请求下含义完全不同,所以只靠 rank 或只靠时间都不够。
🧩 Factorized Rank Encoding 用低秩分解参数化 rank 嵌入。作者观察到学出来的 rank embedding 近似低秩,几个主方向就能还原大部分性能;参数量从 LD 降到 D+LK+KD,文中给的是 3.8 到 21.6 倍缩减。Target-Relative Time Encoding 则把“距目标的时间距离”做成由粗到细的可学习时间势,直接当 attention bias 用。
⚙️ 交互粒度上提出 Temporal Group-Causal Interaction:按目标相对时间把历史分组成时间桶,组内双向交互并加掩码 item 重建,组间保留因果顺序,最后压成 group summary 传给后续层。它比 token 级全因果放得开,又不像全局双向那样把兴趣演化顺序抹掉。
📊 四个公开 benchmark、11 个 baseline,在每个数据集上都赢最强 baseline,平均相对 AUC 提升 1.47%,TAAC 上最高提升 4.45%。
📈 这套 target-aware 的 rank+time 编码还能直接搬到别的 Transformer CTR 主干上;相对同一主干下 8 种位置编码配置里最好的那个,最高再涨 4.20%。
✅ 消融实验里,rank 和 target-relative time 两个分量各自拿掉都会掉点,说明不是只有其中一个在起作用。
总结感想:如果你的模型还在直接继承 LM 那套 APE、RoPE 加 token 级 causal attention,建议先在自己数据上复核一遍 NoPE 基线,确认位置编码到底有没有贡献,再决定上不上 FRE、TRTE。有两个需要留意的点。TRTE 依赖准确的曝光时间戳和分桶尺度,粗到细的粒度选错可能没有收益;分桶还会改变有效序列长度和算力开销,线上除了 AUC 也要看按时间间隔分层的校准。相比 SASRec 式纯序列表征,它的优势集中在“同一用户多次曝光、时间间隔分布很偏”的场景。