推荐算法日报 · 2026-09-30
总览
今天这批论文整体是工业味很重的一天,真正有硬核方法和线上数字的不多,但主线很清晰:一条是怎么把推荐序列建模里的时间和跨域信息榨干,另一条是拿 agent 把模型研究流程本身自动化。跨语言电商那篇用 NLP 里的 code-switching 思路在共享 token 空间做跨国混合,最打动我的不是离线全指标第一,而是小国家涨幅明显更大这个结构性证据,可惜线上只给了六国聚合,小国家的卖点没被单独验证。时间感知 RoPE 那篇是今天方法上最扎实的,抓住了推荐照搬 LLM 位置编码却不记真实时间间隔的痛点,理论证明了光换时间戳没用,实验也够硬,但要注意它的漂亮涨幅很大程度是相对弱基线,线上订单指标只是方向性显著。快手的 agent 做模型研究那篇胜在流程设计,证据留痕、四类研究动作、三档参照系都很有参考价值,不过它的百分比不是成功率,新纪录其实很稀,而且闭源,能抄的是思路不是实现。后面几篇搜索、电商、负采样和多模态属性抽取的稿子还没细看,先不下结论。今天优先看时间感知 RoPE 和跨语言 code-mixing 这两篇,前者学方法,后者学怎么把跨域迁移落到工业指标上。
论文列表
1. Cross-Country Code-Mixing for Generative Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-09-24 03:38 UTC
- 机构:Alibaba International Digital Commerce Group
- 工业优先级:强
- 备注:CIKM 2026 Short
跨国推荐ID不互通,代码混搭破局 🌍
各位算法同学们,跨国家推荐里各市场的用户ID和商品ID完全不重叠,传统跨域方法赖以为生的共享锚点直接消失。阿里国际这篇工作换了个思路:自然语言里有多语言code-switching语料,推荐为什么不能自己造一份?
📄 Cross-Country Code-Mixing for Generative Recommendation
🔧 共享语义码本:先编码多模态内容,再跨国家联合训一个行为驱动的i2i对齐模型,共享负样本池让“长得像且行为也像”的商品互相靠近,最后过RQ-VAE出token序列。这个码本一物两用,既是GR的tokenizer,也是跨国替换的公共语义空间。
🧩 双重约束的token级混搭:替换发生在语义token上而不是各国家的item ID上,候选必须同时过静态内容约束(token序列的汉明距离)和动态属性约束(价格、受众、热度按国家分位数分桶对齐后的余弦相似度)。只靠标题图片相似就替换,在两个市场里可能是完全不同的角色,噪声很难控。
| ⚙️ 上下文感知重加权:item级过滤管不了上下文,一个和Apple设备序列不搭的安卓平板,内容属性都对得上但意图是错的。于是让GR模型自己算 P(y’ | x) 除以 P(y | x)+P(y’ | x) 当权重,带stop-gradient,只用来给噪声样本降权,不回流梯度。 |
📊 两个真实多国家数据集上,数据稀疏国家提升明显,数据充足国家没有掉点,说明不是简单的此消彼长
📈 线上A/B:广告收入 +1.77%
✅ 订单 +2.64%,来自大型电商平台的真实大盘
总结:如果你在做多市场或多域的生成式推荐,尤其小市场冷启动、想从大盘借信号,这篇的“数据级迁移”比纯参数共享更直接,也容易接进现有GR pipeline。要盯的是稀疏国家的收益和大市场有没有负迁移;两个坑先划出来,码本低频更新,价格热度这类快变量必须自己补一路side-info分桶,不然会拖后腿;替换率k和采样子率p直接决定混入多少噪声,建议先在单个小市场小步调。
2. T-RoPE: Time-Aware Rotary Position Embedding for Sequential Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-09-24 21:39 UTC
- 机构:未披露机构
- 工业优先级:强
把位置索引换成时间戳,推荐涨78% ⏱️
各位算法同学们,把推荐模型里 0、1、2… 的位置索引换成真实秒级时间戳,稀疏数据上 HR@10 直接涨了 78% 以上。而且论文证明了标准 RoPE 就算喂时间戳,依然保持时间平移不变——同一条历史在不同季节被看到,注意力图案完全一样。
📄 T-RoPE: Time-Aware Rotary Position Embedding for Sequential Recommendation
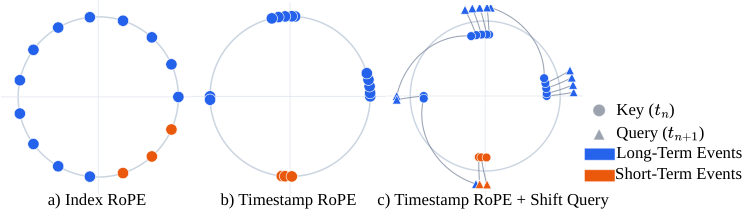
🔧 用 Unix 秒直接做旋转角,相邻事件隔几秒还是隔几周不再是同一个“一步”,时间差直接作用到 QK 点积上。 🧩 每个旋转平面配一个基频,从 10² 到 10⁸ 秒几何铺开,配上可学习的 query/key 时间系数,让模型自己决定周、月、季哪个周期更重要。 ⚙️ query 对齐到下一个事件时间戳(推理时用当前时间),key 侧做非平稳旋转,专门打破相对时间对称性,把日历相位编进去。
📊 五个公开 benchmark,每个数据集每个指标都是最好;PixelRec 稀疏数据 HR@10 比最强基线高 78–130%。 📈 Amazon Books 各指标涨 8–12%。 ✅ 6B+ 交互的工业电商数据,比 HSTU + Time RAB 主干全面高 13–82%;消融显示多尺度频率贡献最大,NDCG@50 涨 56%,非平稳 key 再贡献 4%。 📈 Shop App 线上 A/B:转化率 +0.33%,订单量 +0.63%。 额外算法开销对序列长度和 head 维度都是线性的。
如果你已经在序列推荐里用 RoPE、埋点又有真实时间戳,这个改动接口兼容,可以先试;但要是只有事件序号没有时间,或者业务周期短到一次会话内,多尺度频率库很可能学不出东西,先确认 β 的取值范围覆盖了你的周期。另外线上提升是千分之几量级,别指望单点改动带飞,重点看它和 HSTU 的时间 RAB 叠加后还能不能保住那 13–82%。
3. SPARQL-LLM: Real-Time SPARQL Query Generation from Natural Language Questions
- 论文链接:AlphaXiv
- 更新时间:2026-09-23 19:59 UTC
- 机构:SIB Swiss Institute of Bioinformatics,SIB Swiss Institute of Bioinformatics and University of Zurich,SIB Swiss Institute of Bioinformatics and University of Lausanne
- 工业优先级:中
- 备注:21 pages, 8 figures, 3 tables
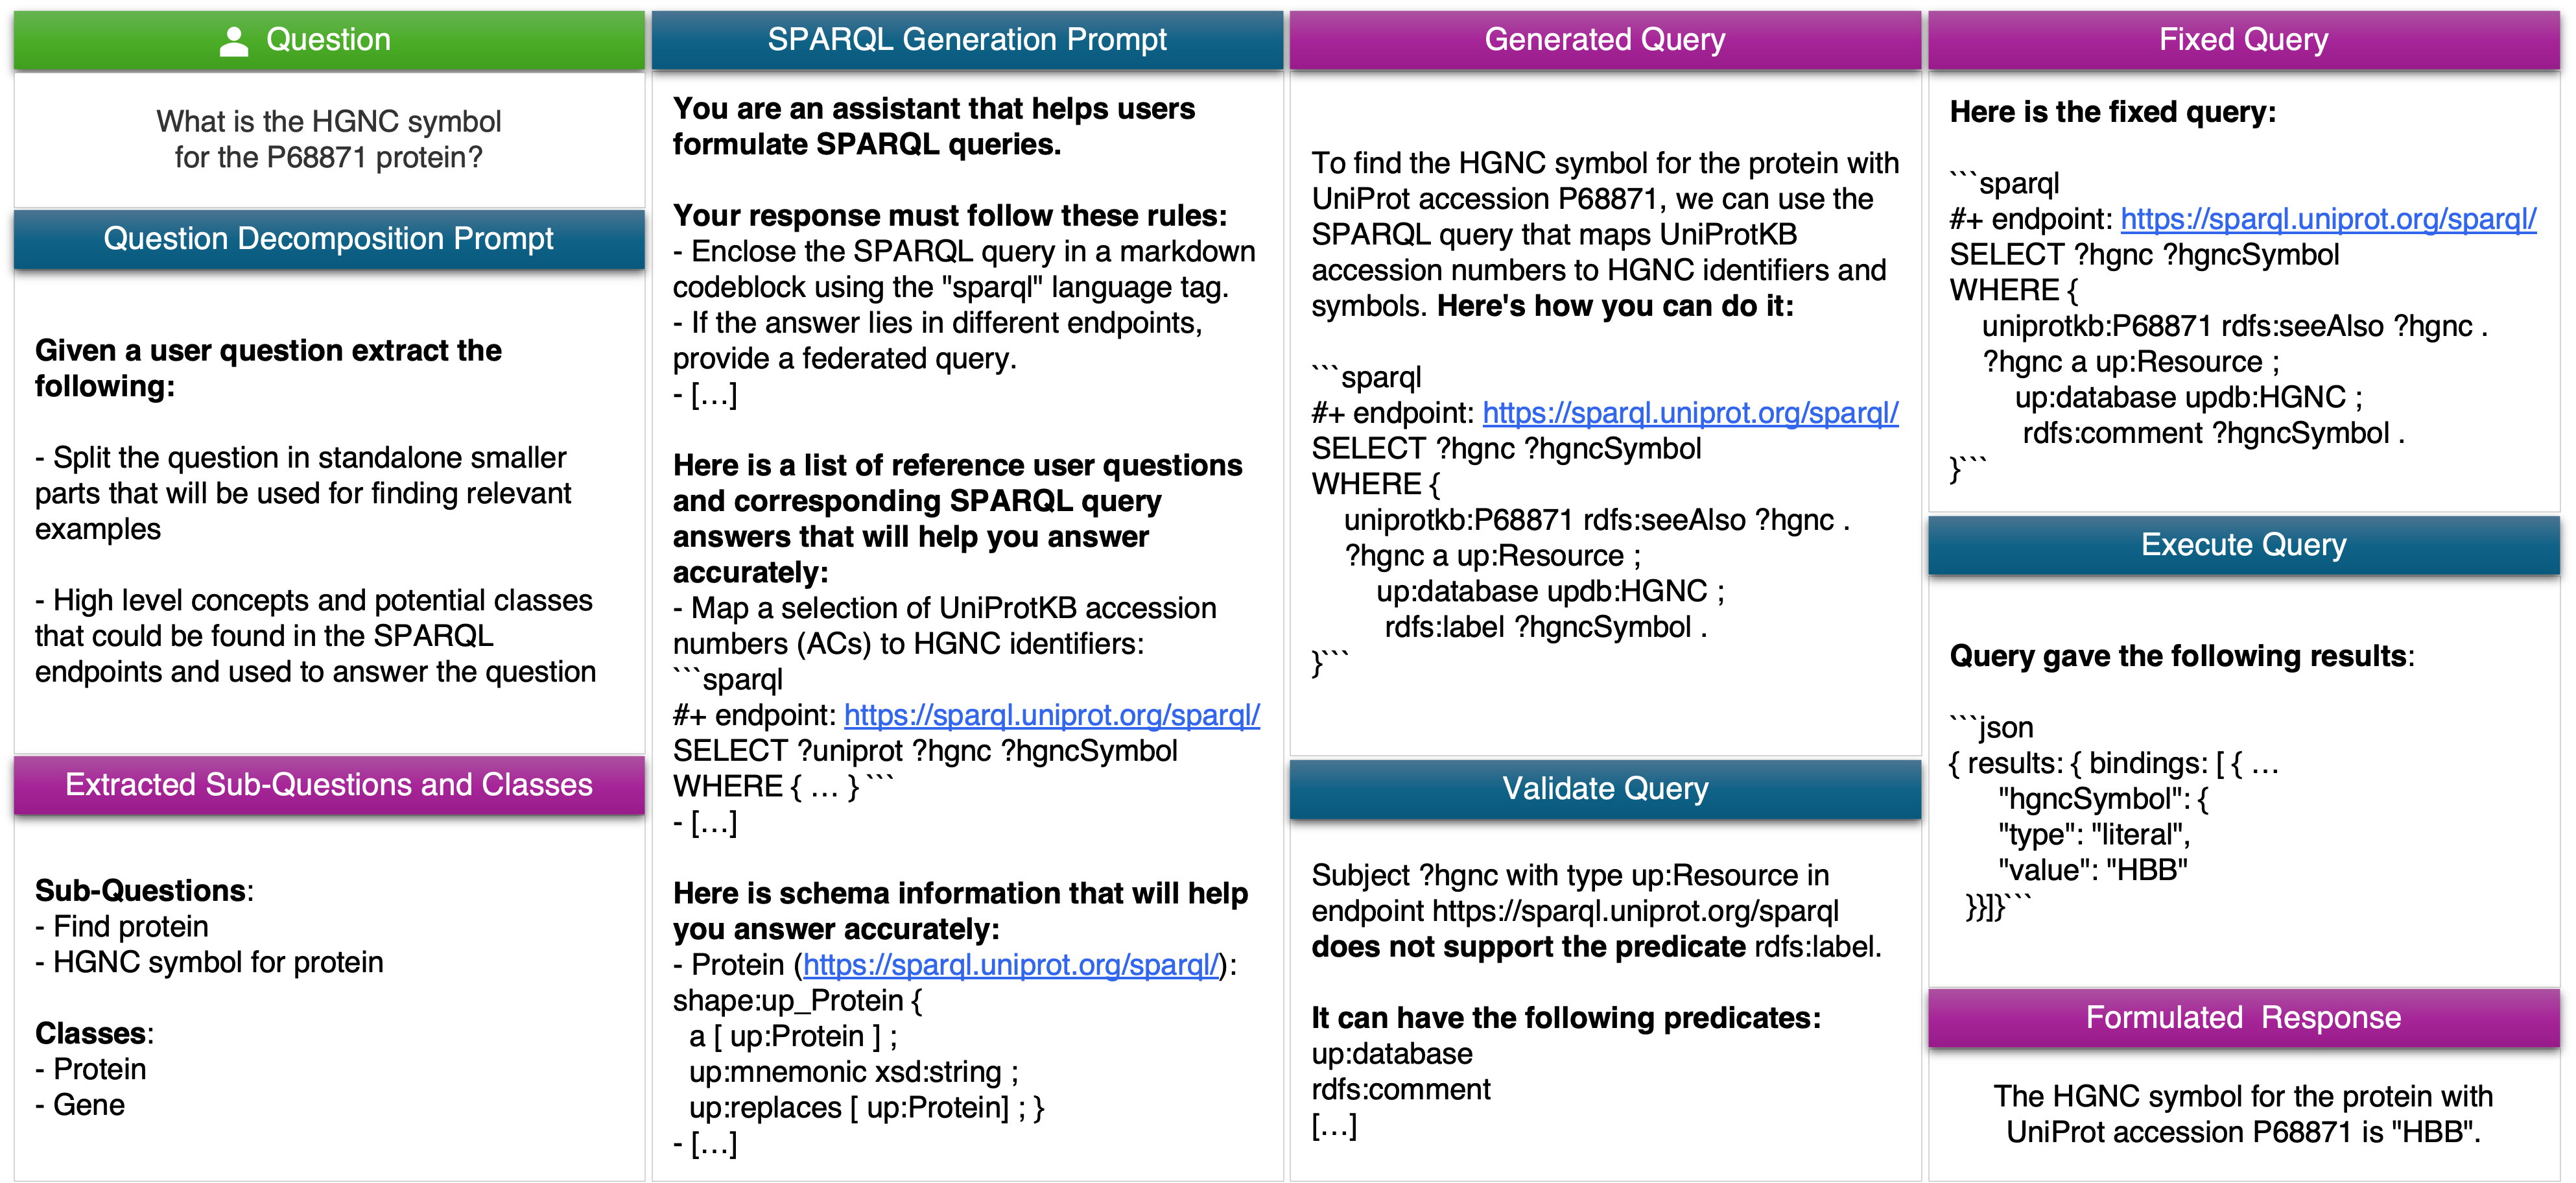
每问1分钱的Text2SPARQL ⚡
各位算法同学们,Text2SPARQL 现在的瓶颈早就不是准确率了,是“一个问题要等多久、烧多少钱”。这篇工作的看点在于它把 runtime 和 cost 摆到和精度同等的位置,而且是真上线跑的,不是只刷榜。
📄 SPARQL-LLM: Real-Time SPARQL Query Generation from Natural Language Questions
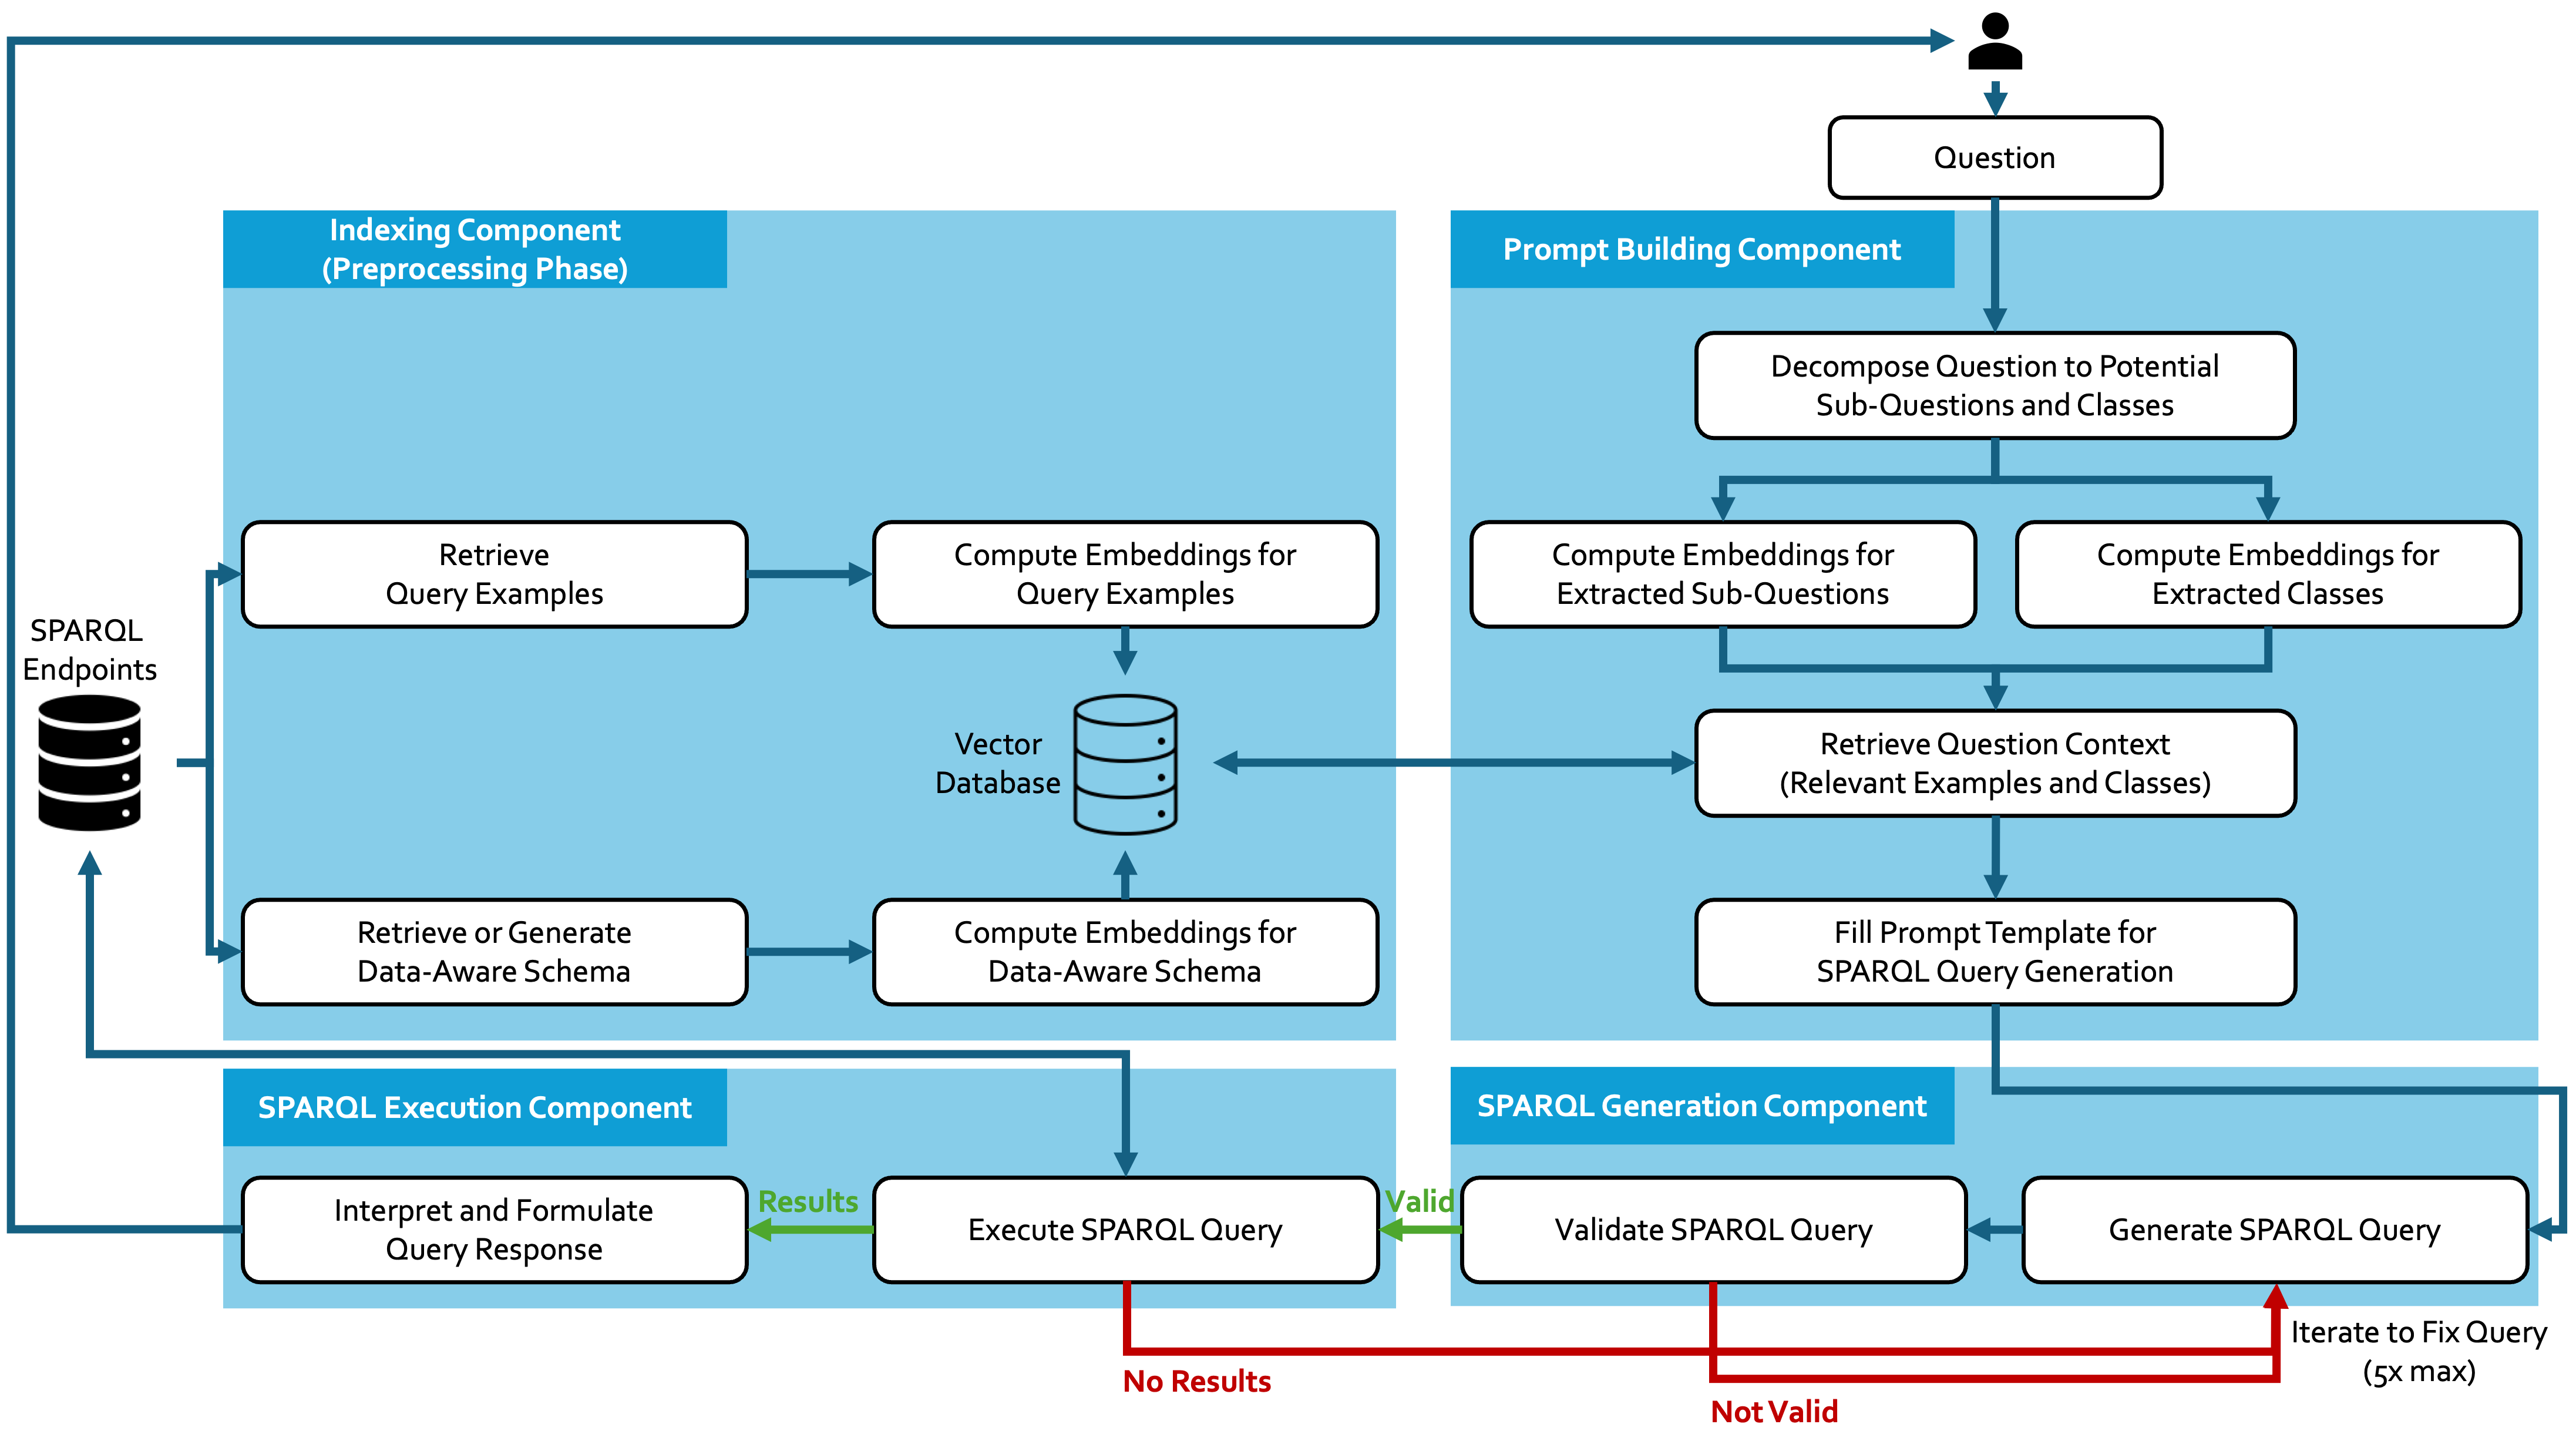
🔧 混合路线:检索式 KGQA 负责先验知识,从端点里捞出人工写的问题–SPARQL 样例对,加上数据感知 schema(VoID 统计)拼进 prompt;再用 agent 式的迭代校验检查生成的查询能不能跑通。不像纯 agent 那样每个问题都把 schema 从头摸一遍。
🧩 元数据轻量且从端点自动抽:用 triplestore 无关的 VoID 生成器扫 schema,另配一个自研工具在耗时和元数据完整度之间折中,适合数据常变、元数据得随时更新的 RDF 库。门槛也不高,很多端点本来就有现成 query examples。
⚙️ 强调用“人写的样例”而不是模型自造样例,理由是自生成的过程性知识平均下来没什么收益,用户意图和真实 SPARQL 写法之间的鸿沟太大。系统切成元数据索引、prompt 构建、查询生成与执行三块,端点对任何 triplestore 都适用。
📊 在 multilingual 公开挑战赛上,F1 比第二名高最多 59%。
📈 延迟最低,比第二名快最多 27 倍,单问题成本最多 0.01 美元,这才是“实时加低花费”能落地的关键。
✅ 英语、西语、德语这类高资源语言都能接,也能写出复杂的生物信息学查询;评估覆盖了生物信息学三个主流知识图谱,并做了消融,分别看样例和 schema 各自的贡献。
⚙️ 代码在 GitHub 开源,线上部署在 expasy.org/chat,属于点开就能用的那种。
总结:端点稳定、schema 有人维护、又要压 token 成本的场景,这套检索加校验的混合思路比纯 agent 划算。要盯的指标是 F1、p95 延迟、单问成本三条一起看,只报准确率的对比参考性不大。坑在于它吃高质量的人工问题–查询样例,冷启动没样例、schema 又乱的小众图,收益会掉下来,建议先在自己的端点上跑一遍消融。
4. Advancing Model Research in AgentX: Long-Horizon Autonomy for Industrial Recommender Systems
- 论文链接:AlphaXiv
- 更新时间:2026-09-24 15:45 UTC
- 机构:未披露机构
- 工业优先级:中
- 备注:Technical report. 37 pages, 11 figures, 13 tables, including appendices
🤖636次实验560次跑赢基线
各位算法同学们,636次改模型的实验里,560次AUC超过业务基线。这不是人工调参刷出来的,是两个Agent自己排实验、自己接着往下排出来的。
📄 Advancing Model Research in AgentX: Long-Horizon Autonomy for Industrial Recommender Systems
🔧 双Agent分工:Research Agent负责跨实验规划,从论文和已有实验结果里写提案并自审;Model Agent负责在业务沙箱里多轮改代码、跑训练、返回代码+测量+未解问题。提案和结果来回交换,一次实验的产出直接变成下一次的起点,不用每次都等人类提需求。
🧩 四种研究动作:Reproduce引入方法,Follow-up精修实现,Composition把不同实验的改动拼起来,这三个跑常规研究;Diagnose则专门针对业务反馈和线上评估暴露的问题取证,比如用PCOC衡量的预测偏差,先拿证据再决定怎么修。
⚙️ 一个依赖感知的历史回放benchmark,473个实验节点、6个环境,用来研究下一个实验该怎么选。
📊 约25天生产观察内完成636次改模型实验,560次AUC高于基线。
📈 最长跑的场景里,77次Follow-up有7次、120次Composition有5次,AUC超过了同一血脉里所有可比祖先。
✅ 最新5次跨业务线上A/B:拉新效率提升10-15%,目标人群广告消耗提升15-20%,观看时长提升0.3-0.8%;观看时长模型的FLOPs和参数量还各少约10%。
🔍 调度上有个反直觉结果:agent已经会分析并选出具体候选时,更复杂的自适应分配没有稳定收益,固定任务类型轮换加agent选候选就够用。
总结:对做推荐模型迭代、想在固定业务沙箱里跑自动化实验的团队有用。要盯的是AUC相对基线的分布和血脉里能不能持续刷新纪录,以及线上那几个百分比能否在别的场景复现。坑有两个:agent只能改模型内部的特征表示、路由、骨干和任务塔,上游特征采集和预测任务定义动不了;另外别急着上花哨的调度器,先把候选选择做扎实。跟Dream-RSI那类历史回放工作比,这篇多出来的是把实验结果回灌成下一个研究问题这一步。
5. PEAR: Progressive Evidence-Based AutoResearch for Industrial Search Systems
- 论文链接:AlphaXiv
- 更新时间:2026-09-28 12:30 UTC
- 机构:未披露机构
- 工业优先级:未标注
- 备注:20 pages, 2 figures, 6 tables
工业搜索AutoResearch新解🔍
各位算法同学们,工业搜索里让 agent 自己迭代调策略,最大的坑不是模型不够强,而是把短暂流量波动当成永久提升。PEAR 这篇把“证据”和“置信度”拆开设计,适合正在做搜索/推荐策略自动优化的人看。
📄 PEAR: Progressive Evidence-Based AutoResearch for Industrial Search Systems
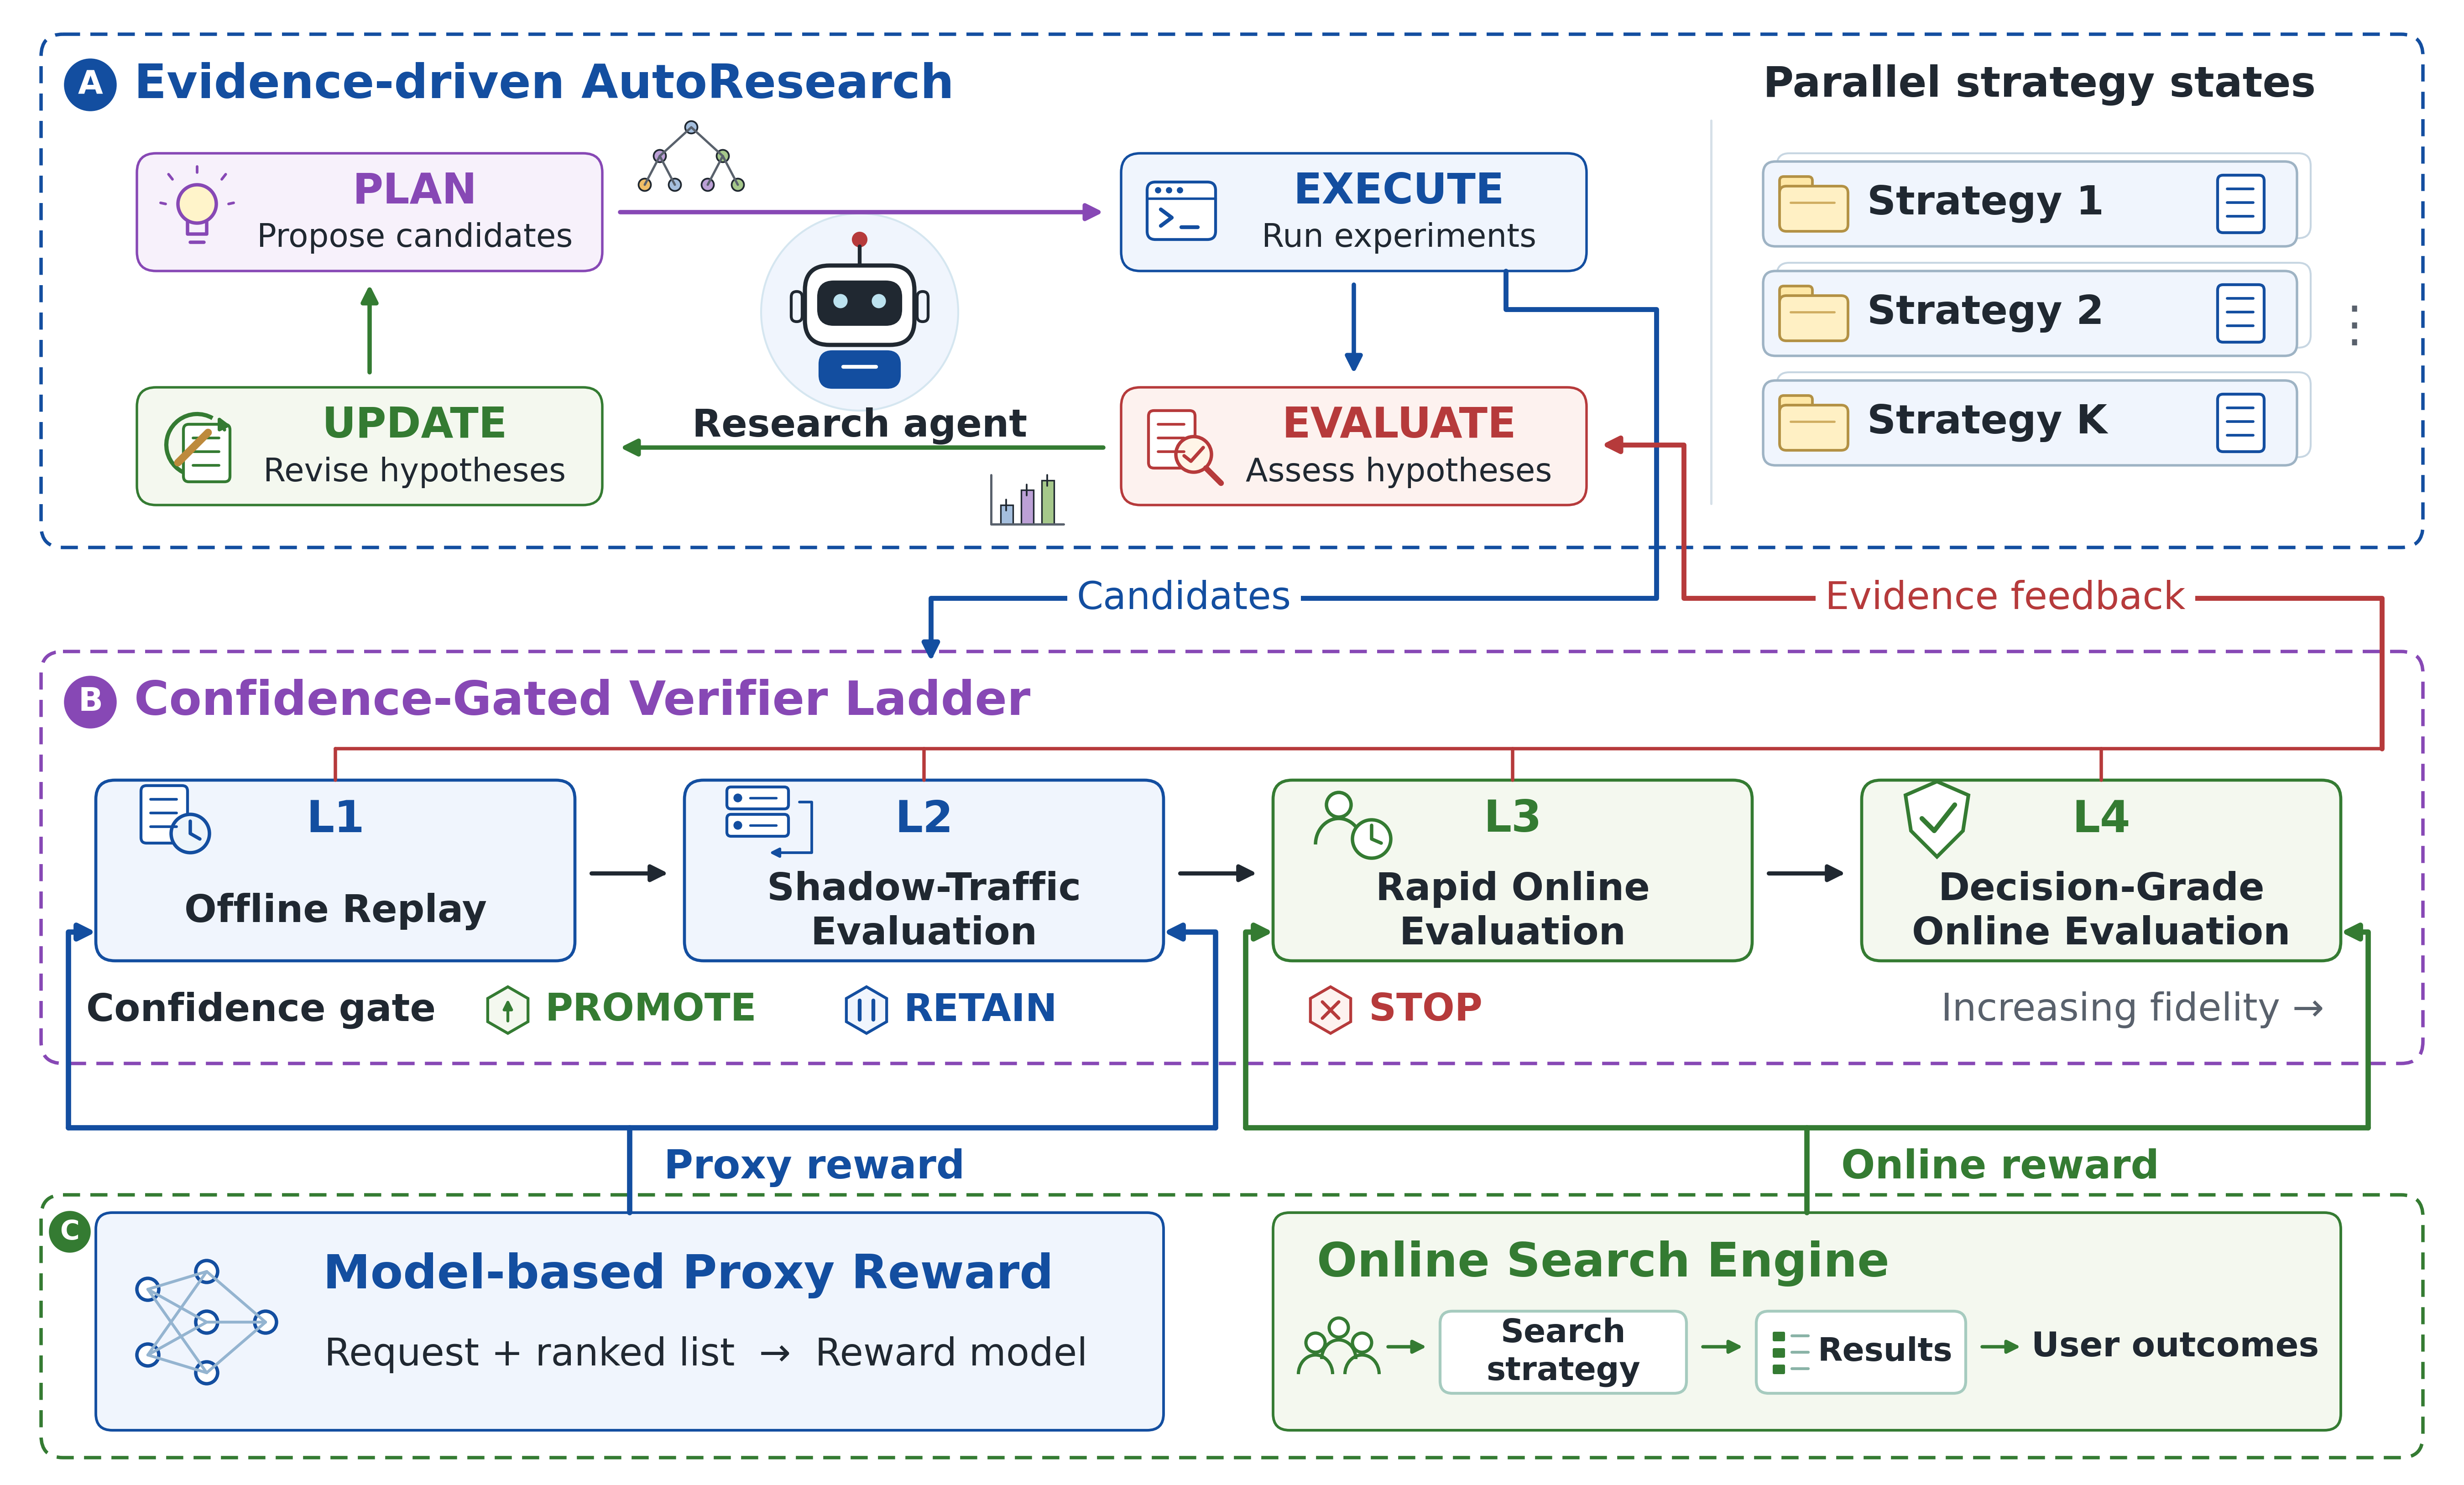
🔧 用 Evidence-driven AutoResearch 给每个策略任务维护独立研究状态,把假设、候选干预、实验结果和流量上下文绑在一起,不再用一个全局分数串所有轮次。
🧩 Plan–Execute–Evaluate–Update 循环里加入贝叶斯优化式推理:既细化已有证据支持的区间,也探索没试过的区域;不同流量上下文里的分数不会被直接比较。
⚙️ Confidence-Gated Verifier Ladder 把评估分成四层:Offline Replay、Shadow-Traffic Evaluation、Rapid Online Evaluation、Decision-Grade Online Evaluation。统一置信度门只让统计显著正向的候选往上走,便宜评估负责宽探索,贵的线上实验留给被 promote 的候选。
📊 真实工业搜索系统,三个策略任务上跑,两个被 promote 的候选从 Shadow-Traffic 到 Decision-Grade Online 方向一致为正。
📈 两个 Decision-Grade Online A/B 实验里,Main Order/DAU 分别相对各自 baseline 提升 2.7336% 和 3.2957%。
✅ 这是线上主单和 DAU 指标,不是离线 proxy;提升幅度在成熟工业系统里不算小,但论文没给置信区间和实验时长,复现时要盯显著性和流量平稳性。
总结感想:如果你在做搜索/推荐策略的 AutoResearch,PEAR 的主要价值是把 keep-if-better 换成带上下文和置信度的证据管理,并给了一个分层评估的工程模板。落地坑在于四层阶梯依赖 Shadow 流量和快速在线实验平台;没这套基建,先做研究状态和置信度门性价比更高,对比对象也建议先用 keep-if-better 基线加单层离线筛选。
6. Retail Product Search: A Practical Approach at Target
- 论文链接:AlphaXiv
- 更新时间:2026-09-25 16:36 UTC
- 机构:Data Sciences, Target Corporation
- 工业优先级:未标注
- 备注:10 pages, 2 figures, 6 tables
混合检索上线,CTR涨0.97%🔍
各位算法同学们,纯关键词检索换成混合检索后,零结果查询直接砍了一半。Target 这篇把线上 A/B 的每一步都写清楚了,做电商检索或垂类搜索的话,能直接对照自己的链路找差距。
📄 Retail Product Search: A Practical Approach at Target
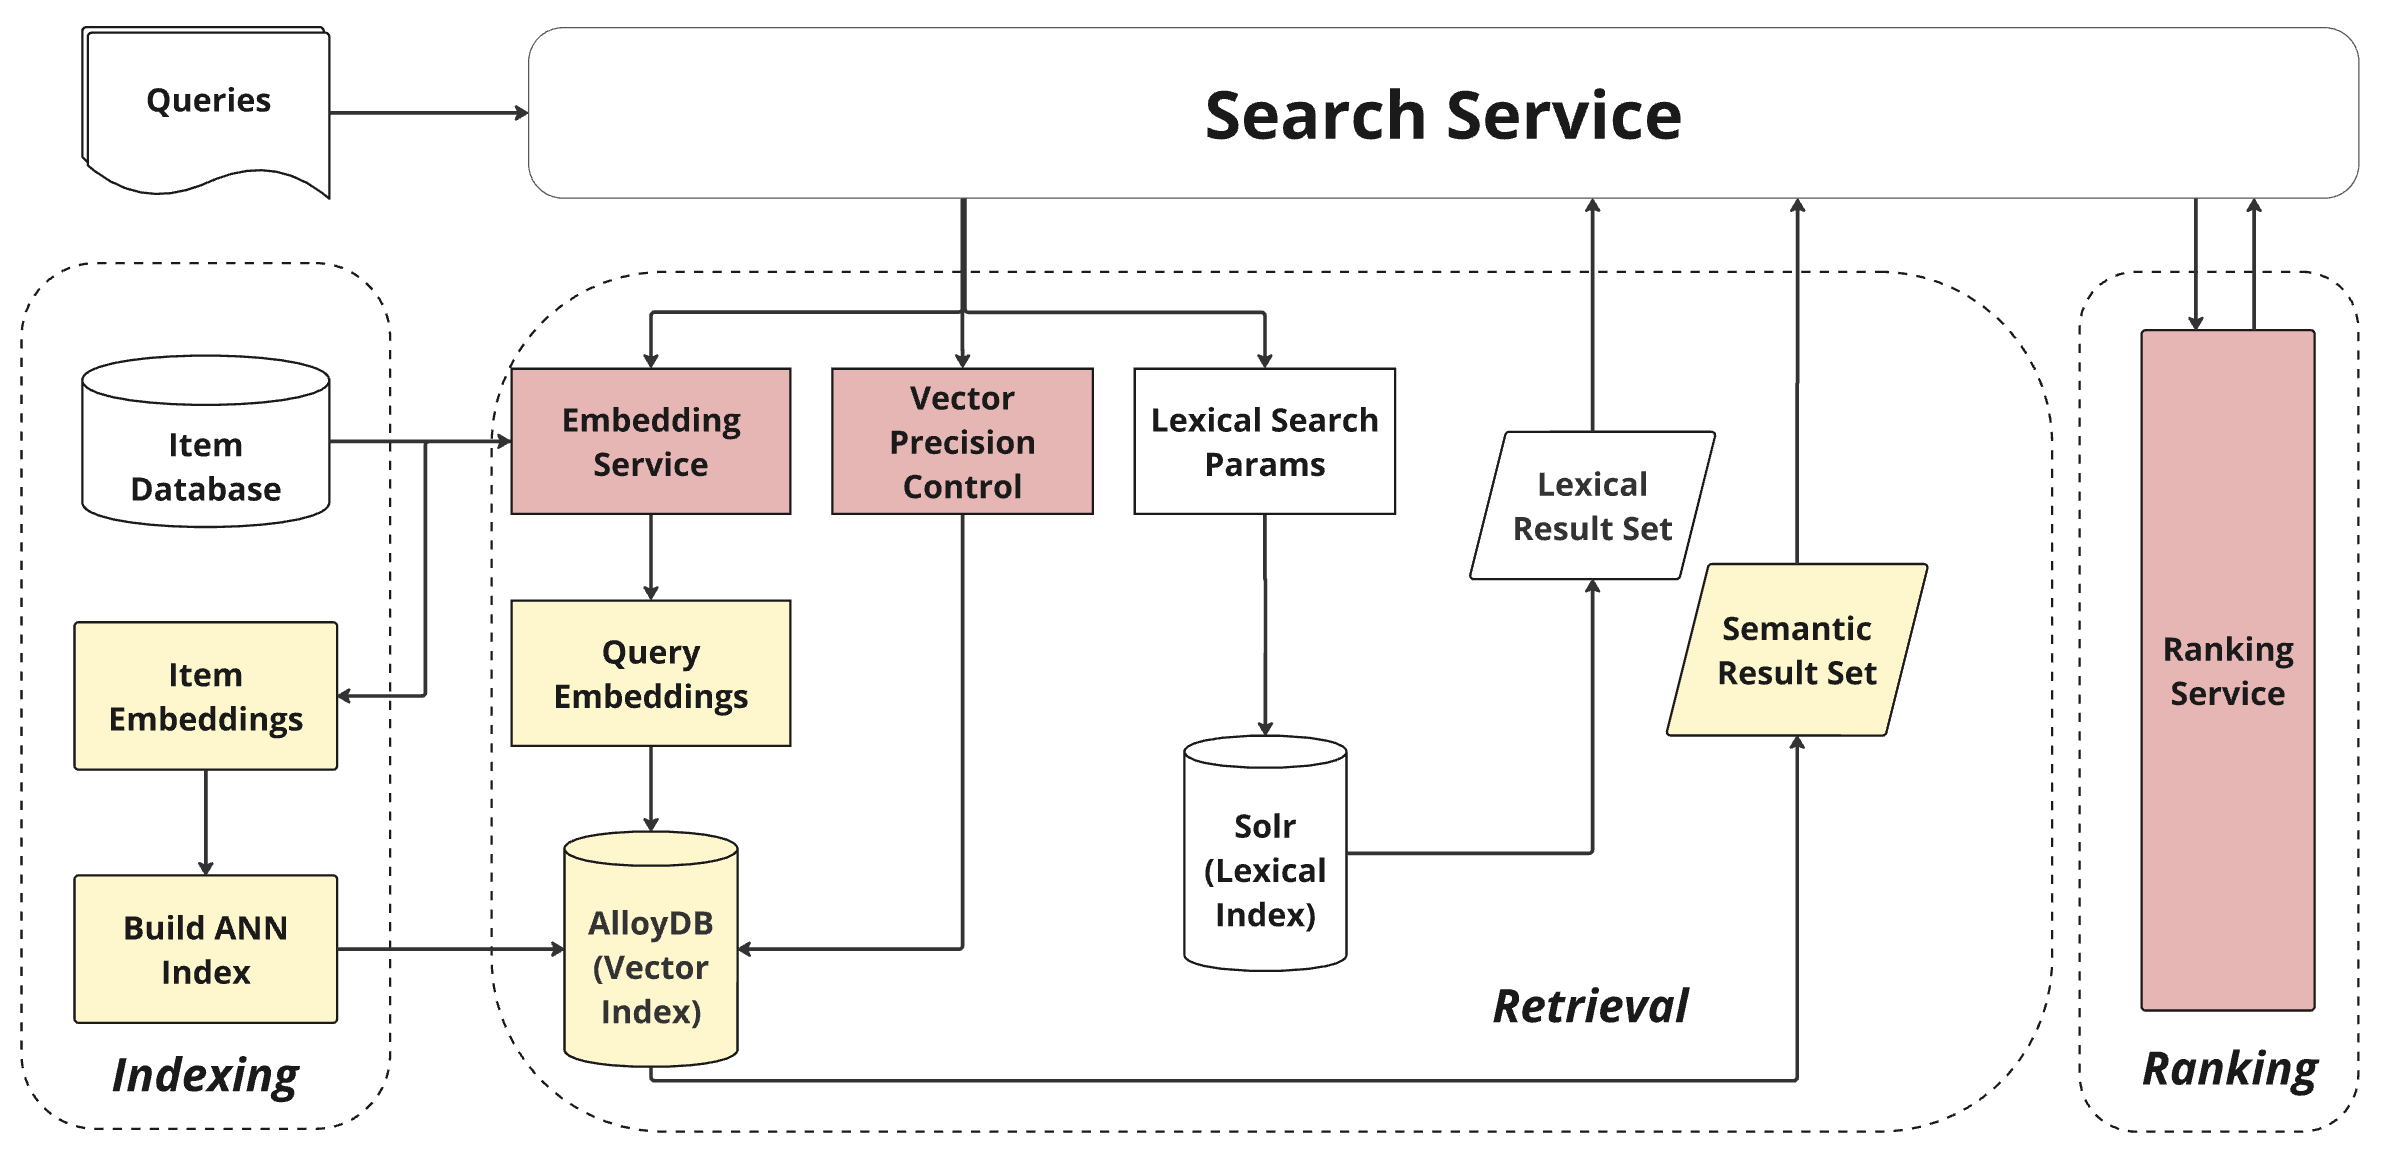
🔧 双通道并行召回:Solr 倒排索引和微调双塔向量模型同时跑,向量侧用 AlloyDB 上的 ScaNN 做 ANN,索引覆盖百万级商品向量,文本不一致的同义、缩写、拼写错误都能兜住。
🧩 标签完全来自行为日志:点击、加购、转化聚合成约 2000 万 query-商品对,按类目和 query 频次分层采样,避免头部 query 淹没长尾,还构造了两类难负样本做对比学习。
⚙️ 精度控制加融合策略:先用 query 里出现或预测出的属性过滤向量候选,再对比 RRF 和加权交错,线上测试最终选了加权交错,权重靠 A/B 调。
📊 4 周线上 A/B 对比纯关键词检索:CTR 提升 0.97%,订单转化提升 0.98%,人均需求提升 1.10%。
✅ 零结果搜索大约减半,系统已全量部署,每天服务数百万用户。
📈 离线指标也有提升,但论文强调真正做决策的是线上转化和参与度,不是通用相关性榜单。
我的判断:做电商搜索、内容检索或任何 query 意图跨度大的团队,可以重点看它的标签构造和精度控制,这两块比模型结构更影响落地效果。坑也很明显,加权交错的权重会随类目和流量变化漂移,得持续用 A/B 盯;向量通道不加过滤,低精度结果会直接进候选池。如果要对照,先看自己的零结果率、CTR、转化和 P99 延迟,再看离线召回指标。
7. Real-Time Hard Negative Sampling via LLM-based Clustering for Large-Scale Two-Tower Retrieval
- 论文链接:AlphaXiv
- 更新时间:2026-09-25 20:46 UTC
- 机构:Meta
- 工业优先级:未标注
负样本太简单?Meta用LLM聚类挑
各位算法同学们,两塔检索里最贵的往往不是模型结构,而是负样本怎么采。这篇的改法很直接:负样本别从全库随机抽,改成正样本所在语义簇里挖,线上相对旧召回源 CTR 涨了 53%。
📄 Real-Time Hard Negative Sampling via LLM-based Clustering for Large-Scale Two-Tower Retrieval
🔧 自监督簇内难负样本:给每个正样本从它所在语义簇里抽 K 个负样本,而不是全库均匀采。均匀采的负样本和用户向量相似度趋近于 0,梯度也趋近于 0,模型学不到东西;同簇负样本更贴近当前决策边界,梯度更大,逼模型去分辨细粒度差异而非依赖簇间那种一眼假的距离。
🧩 簇是用 LLM 多模态内容表征聚出来的:不靠协同信号分簇,而是用 LLM 学到的内容表示,所以同簇物品是语义上真的像,负样本才有区分度。
⚙️ GOOBS 实时全局 out-of-batch 采样:内存里维护一个实时物品池,训练时在线取簇内负样本,直接嵌进生产训练和 serving 流程,十亿级训练样本下额外算力开销很小。
📊 四个公开数据集 + 14 天大规模线上 A/B 测试。
📈 作为生产系统里的一个召回源,它服务的曝光上 CTR 相比旧源模型 +53%。
📉 物品数越多的数据集收益越明显(如 Amazon Reviews);线上分析还显示流行度偏差明显下降,推荐的反馈回路被削弱。
关于要不要跟:如果你在做两塔召回,并且正被 easy negative 或流行度偏差卡着,这套思路可以直接试。坑在簇的质量和粒度,LLM 内容表征不行,同簇负样本就退化成噪声;簇数太少负样本还是太远,太多又接近随机采样。上线别只盯 CTR,还要看长尾覆盖率、类目分布和物品池新鲜度,实时池一旦更新滞后,采出来的所谓难负样本可能已经是老古董。
8. Correcting to Predict: Pseudo-Value Correction for Multimodal Attribute Value Extraction
- 论文链接:AlphaXiv
- 更新时间:2026-09-28 05:59 UTC
- 机构:Alibaba International Digital Commerce Group
- 工业优先级:未标注
- 备注:Accepted by CIKM2026 Oral Full Paper
属性抽取换个思路:别生成,去纠错
🧭 各位算法同学们,多模态属性抽取里最坑的不是模型”看不见”,而是它明明看见了,还是照着候选值抄。阿里国际这篇 C2P 干脆把 AVE 从生成任务改成了纠错任务,线上三个业务指标都跑出正向,思路比结构更有意思。
📄 Correcting to Predict: Pseudo-Value Correction for Multimodal Attribute Value Extraction(CIKM ‘26,Alibaba International Digital Commerce Group)
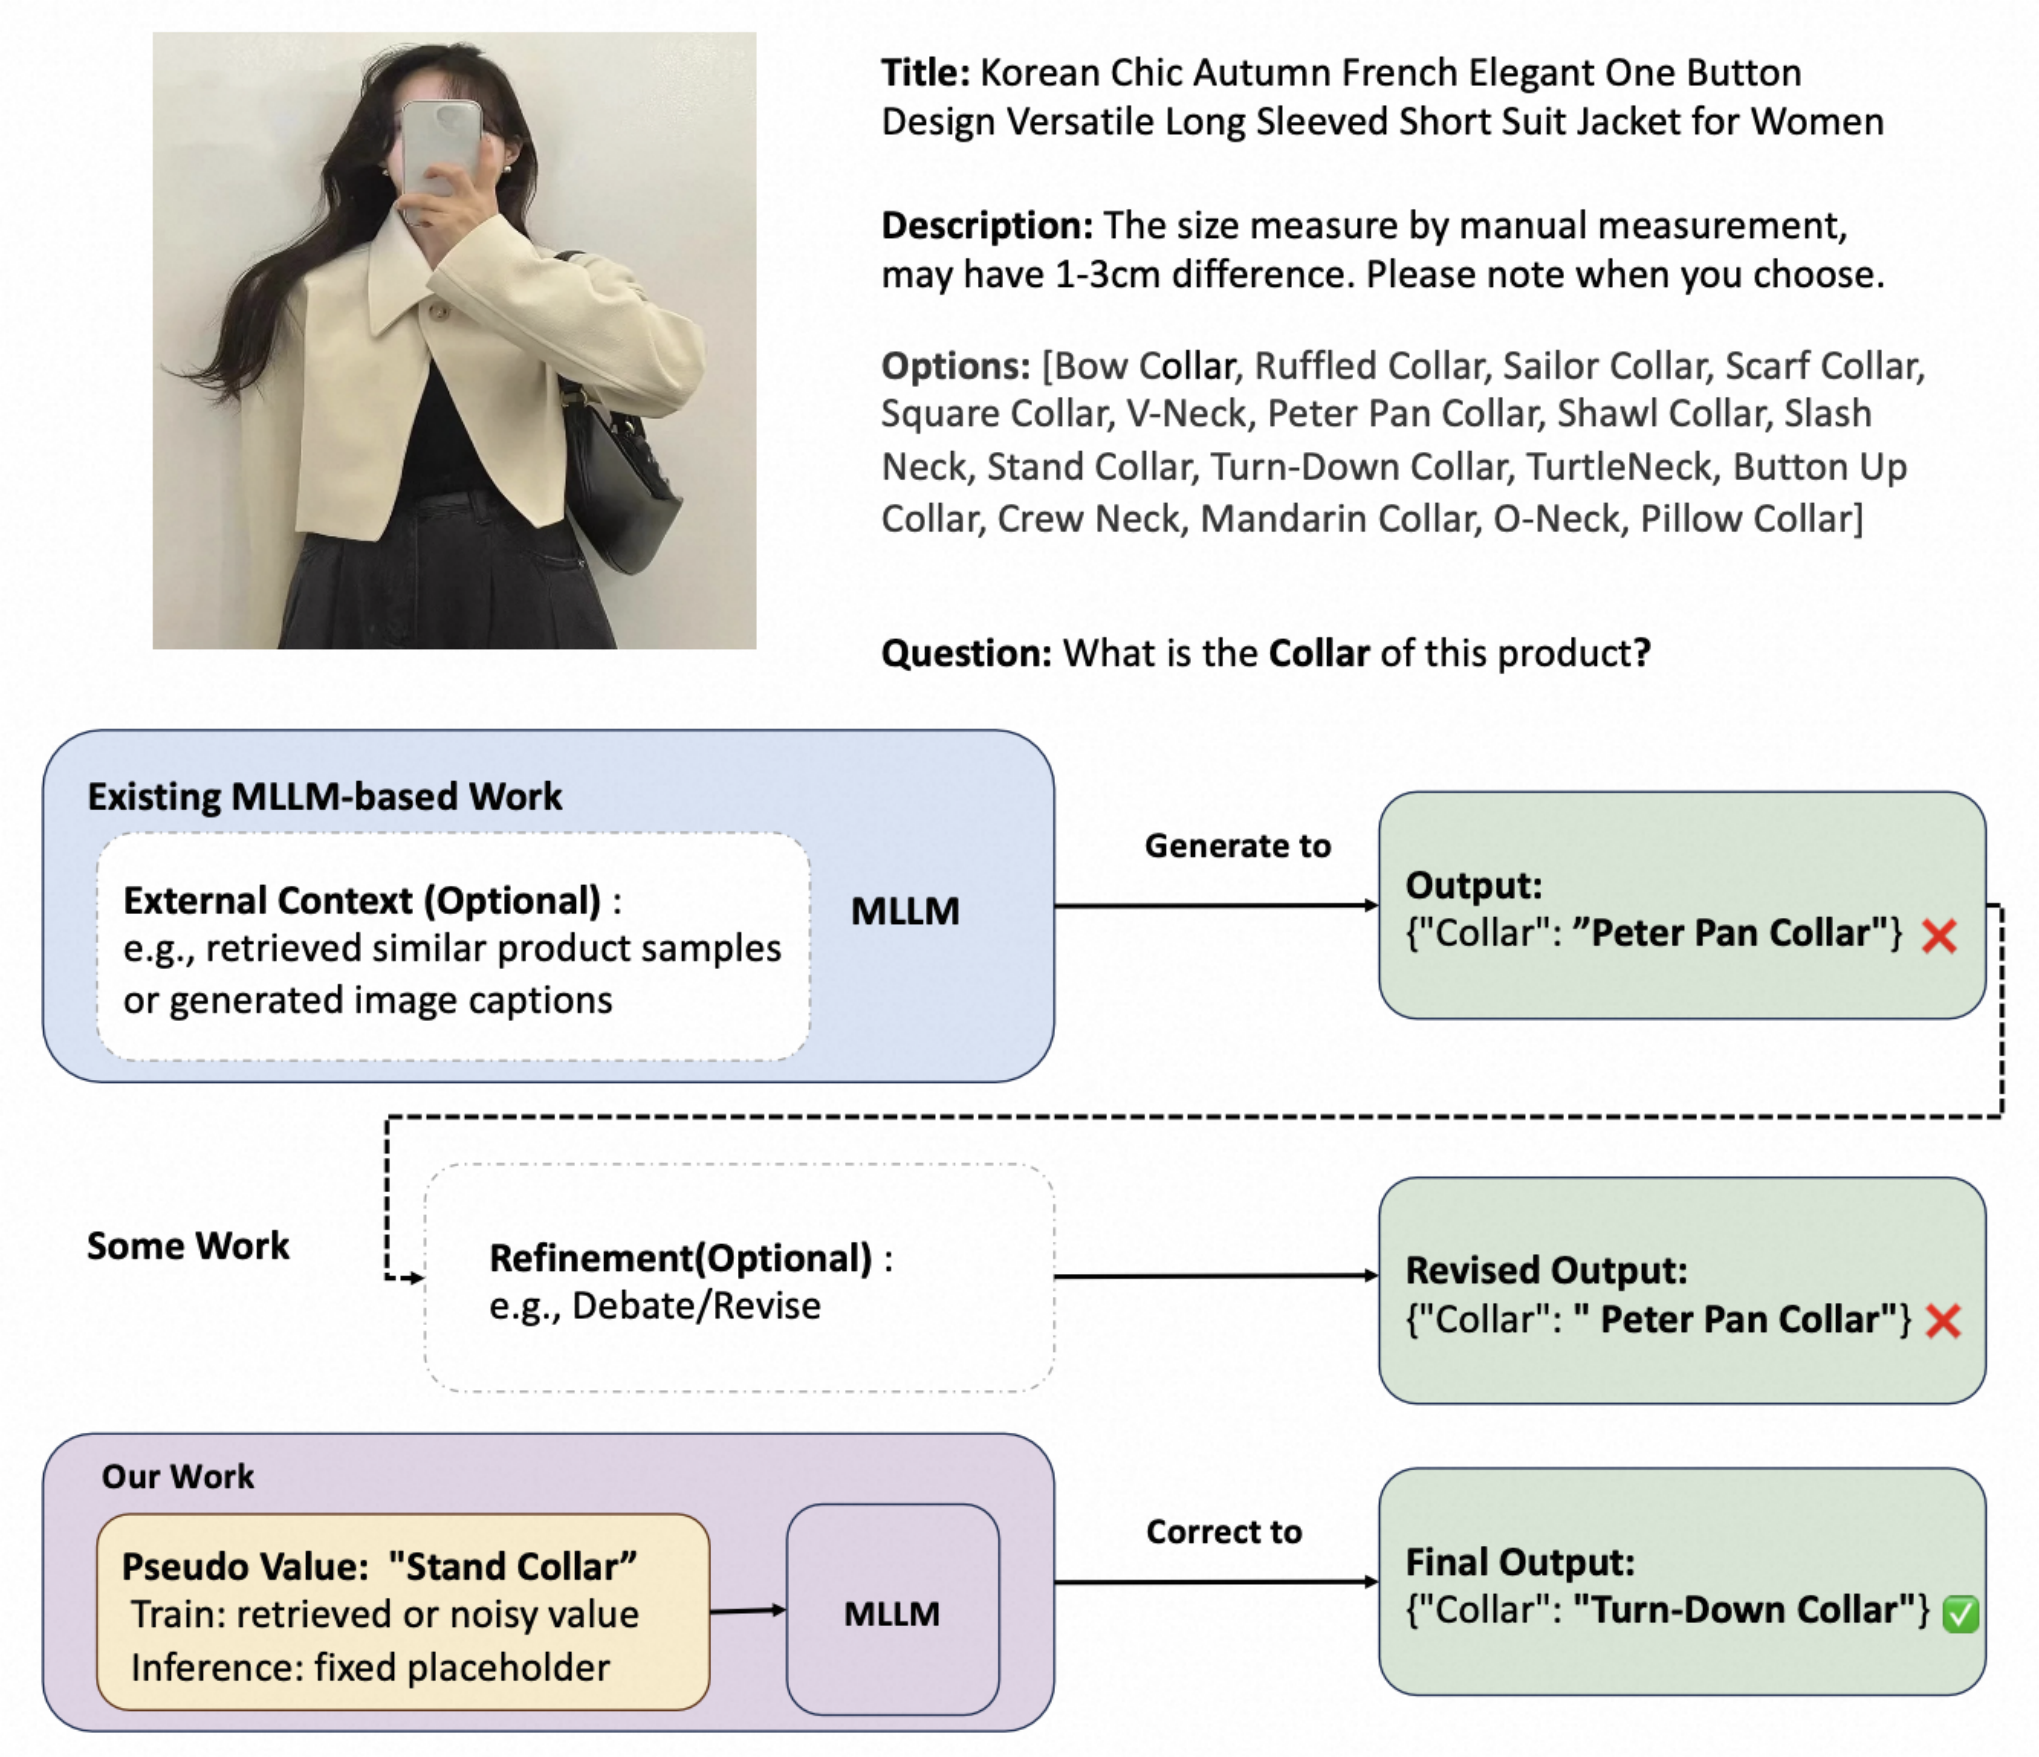
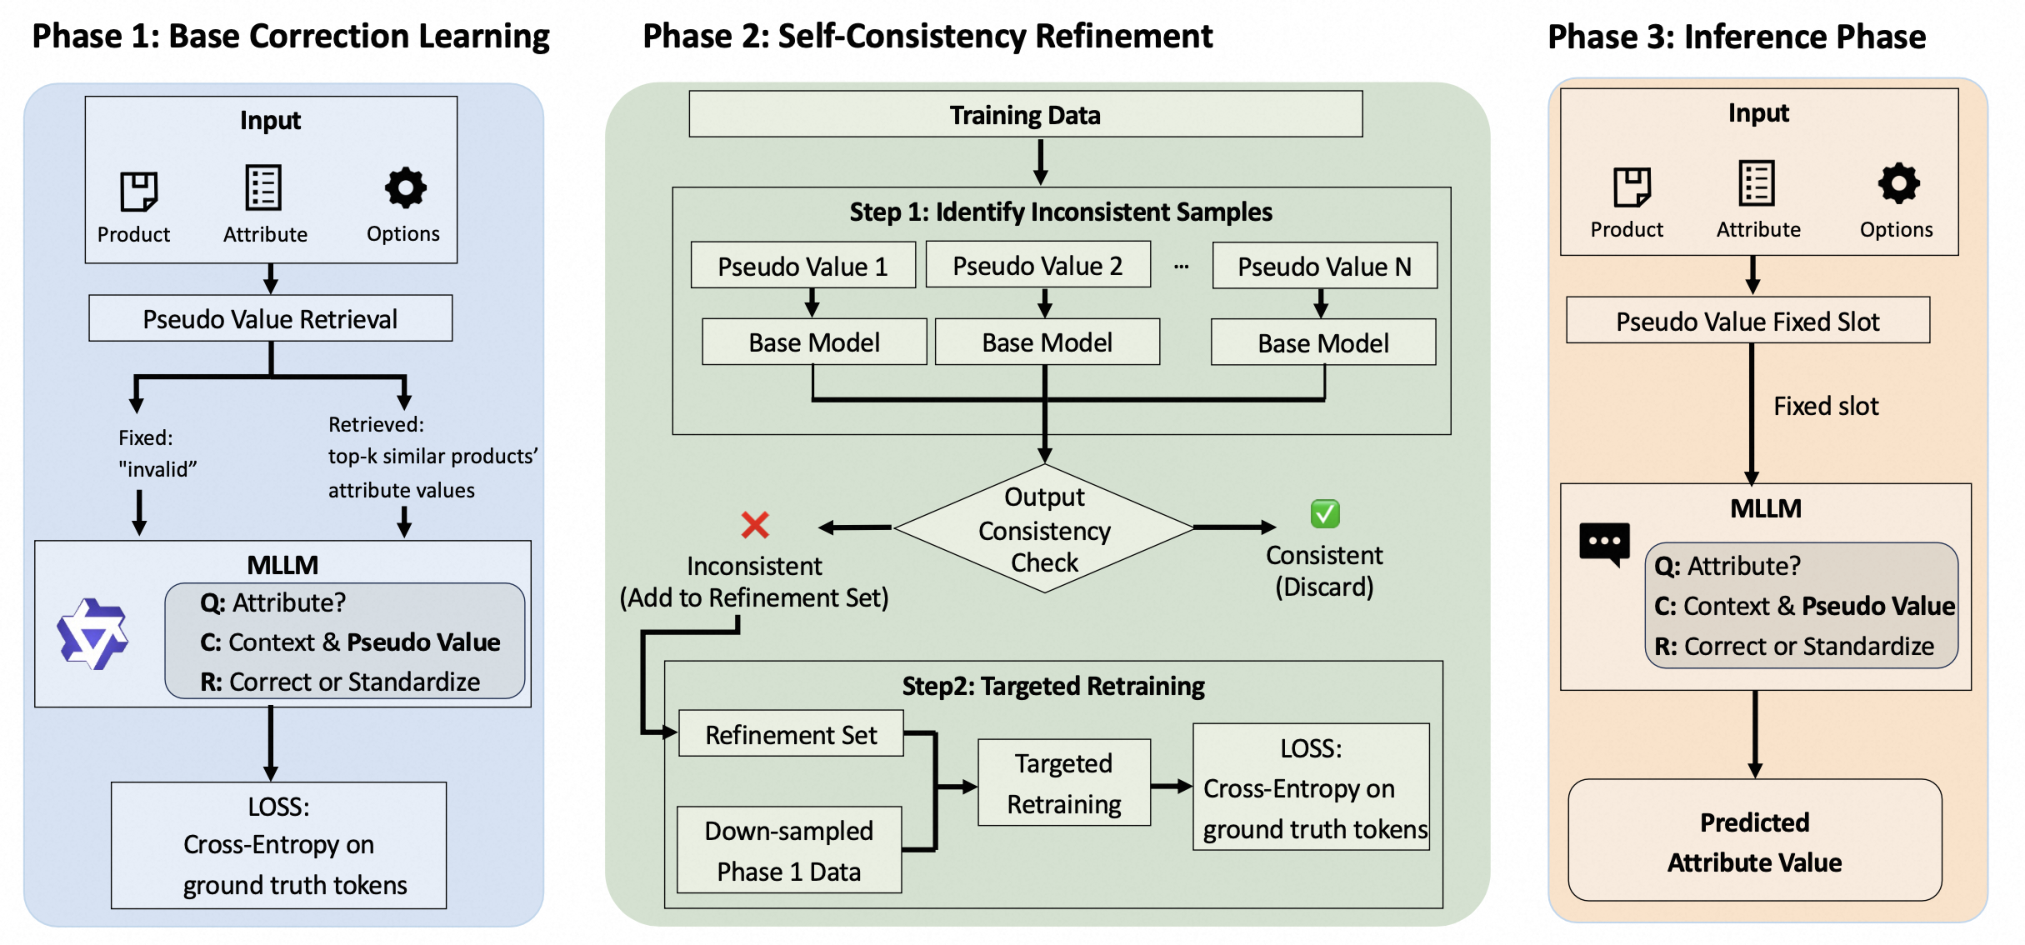
🔧 输入里塞一个”伪值”:可以是检索到的候选,也可以只是一个占位符,模型的任务变成按图文证据判断该保留还是改掉。检索结果从”可信上下文”降级成”待验证的假设”,这是它和 RAG 路线最本质的分歧。
🎲 训练时故意喂各种不同的伪值,逼模型学”看证据”而不是”抄输入”;再加一个自一致性精炼阶段(SCR),专门捞出那些换个伪值预测就变的样本回炉,因为预测会变说明它依赖的是输入猜测,不是商品本身。
⚙️ 推理时不需要在线检索、也不需要多轮迭代,固定一个占位符就能触发学到的纠错行为,单次前向出结果,这是它能进生产环境的前提。
📊 离线评估用公开的 ImplicitAVE 榜单加一个大规模工业数据集,提升主要集中在歧义属性上,也就是 Boot Style、Season 这类必须图文联合推理、语义相近值容易混的字段。
📈 线上在 AliExpress 做了 A/B,卖家采纳率、属性完整度、用户互动三个方向都是一致正向,属于真实流量下的工业验证,不是只刷榜单。
✅ 效率层面省掉了在线检索和迭代精修,一次前向预测,延迟和成本都可控。摘要和正文截断处没有给出具体提升的百分点,想看准确数值得等完整实验表。
🧠 如果你的场景是电商属性抽取落地,这篇的价值在于视角:把检索候选当假设而不是上下文,比”再加一轮自我反思”更治本,因为自我纠错和投票类方法的问题就是初始预测没被证据锚住,后面越修越错。要盯的坑是两个:伪值的构造方式直接决定学到的纠错行为,线上候选质量或类目分布和训练差太远时可能退化;对比对象要锁死 EIVEN、MVP-RAG 这类,重点看歧义属性子集,而不是整体平均分。