推荐算法日报 · 2026-09-28
总览
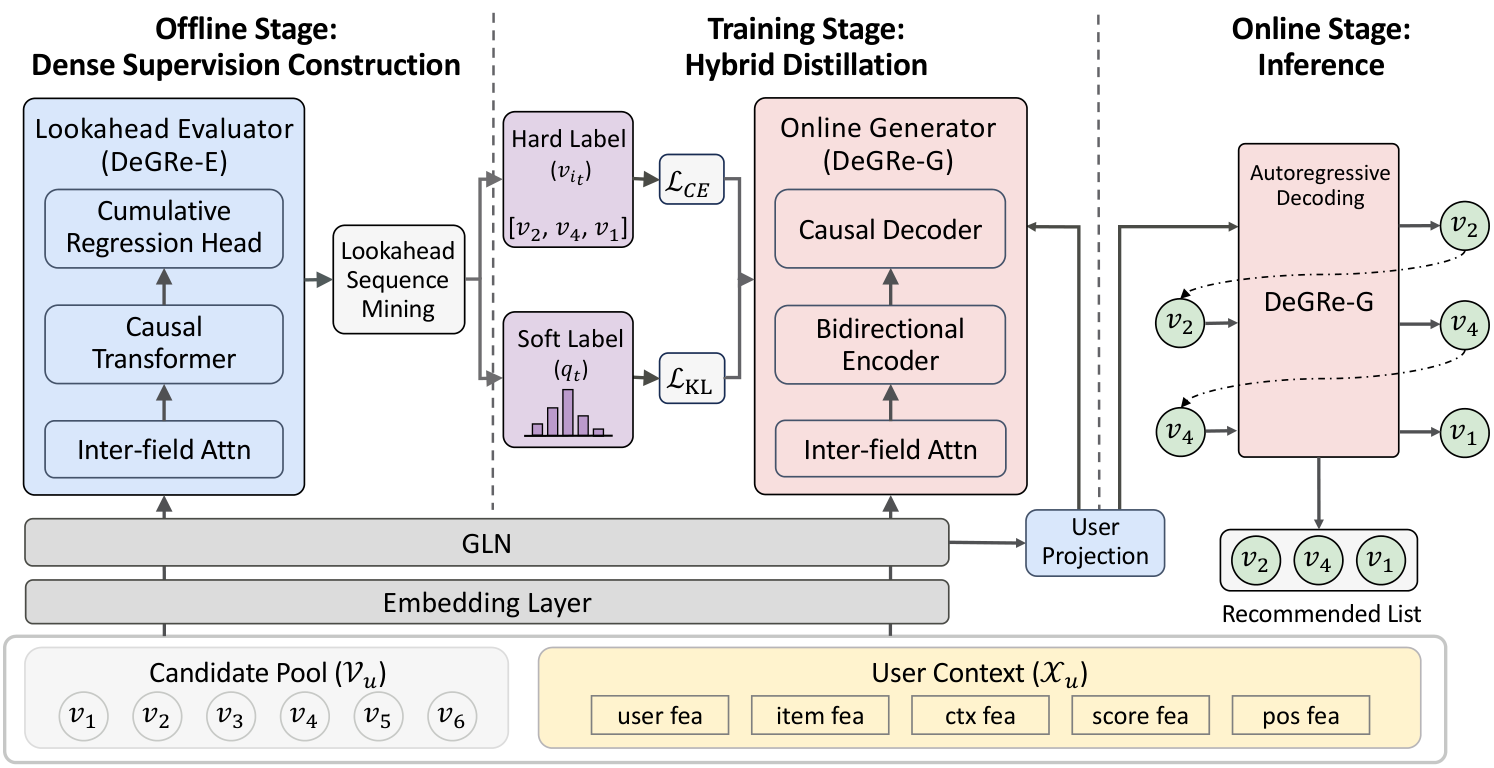
今天这六篇整体质量偏高,主线很清楚:大家都在给生成式推荐补「监督信号到底从哪来」这一课。重排那条线最有代表性的是 DeGRe,用离线 evaluator 在未曝光空间里挖 step-wise 价值再用 beam search 蒸馏给在线 generator,离线涨得吓人、线上 GMV +3.75% 也上了闪购,但消融显示真正干活的就是硬标签,软标签和序列加权基本在噪声里,这种「收益集中在一个组件上」的结构值得警惕。另一条线是级联架构的统一,OneTrans-V2 把召回-粗排-精排塞进一个 Transformer,DCGR 用 decision prefix 调权取代多通道,GMV +9.74% 很亮眼,可惜正文截断、ablation 看不到,而且模型增益和 serving 栈的工程增益混在一起,得打折看。连续空间召回这条 X-Rec 是最有启发的,跳过 SID 量化直接在 embedding 上做 flow matching,anchor conditioning 和球面测地线都是可复用的 trick,late-interaction DiT 拿 1 个点换 8 倍吞吐这笔账工业上太划算。ScalarLens 把数值特征拆成「值定坐标、上下文定响应」这个视角我认为比它那点 AUC 增益更值钱,而且直接吃原始量纲、纯 drop-in,对生产管线的一致性痛点很实在。SID 那条 credit assignment 用冻结 retriever 给兴趣假设发 span 级奖励,思路干净、消融也够扎心,但底座和目录规模都偏小;slate 那篇是理论味道最重的,margin 和 movement 的稳定性刻画加 DP post-processing 的 scope 契约,没什么涨点但边界说得很清楚。今天优先看 X-Rec 和 ScalarLens 这两篇把「表示怎么设计」讲透的,做重排的再补 DeGRe,做级联的留意 OneTrans-V2 的工程细节。
论文列表
1. DeGRe: Dense-supervised Generative Reranking for Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-09-24 17:36 UTC
- 机构:College of Software, Zhejiang University,Rajax Network Technology, Taobao Shangou of Alibaba,State Key Lab of CAD&CG, Zhejiang University
- 工业优先级:强
- 备注:Accepted to KDD 2026 ADS Track (Oral). Best Paper Award Honorable Mention
重排还在推点击置顶?该换了🔁
各位算法同学们:淘宝闪购线上 GMV +3.75%,靠的不是更大的生成模型,而是把排列空间的探索整个挪到了线下。DeGRe 要治的是生成式重排的两个老毛病——标签靠规则拍、回报信号太粗。
📄 DeGRe: Dense-supervised Generative Reranking for Recommendation
🔧 老做法把“点击的 item 提到前面”当训练标签,等于默认点击一定更值钱、跟位置无关。DeGRe 改成离线用 Lookahead Evaluator 去未曝光空间里挖高价值序列:它建在 cumulative regression 上,把“当前累计价值”拆成一组序数二分类再求和,因此能给任意长度的子序列打分。
🧩 奖励式方法的痛点是 credit assignment——整条 list 只有一个 CTR/GMV 后验分数,分不到每一步。DeGRe 把 evaluator 的逐步价值估计当作 dense supervision,蒸馏进轻量的 Online Generator,让生成器内部把前瞻规划学会。
⚙️ 于是离线在线解耦:在线不采样、不重排,一次 greedy decoding 逼近全局最优,也不用同时部署 generator 和 evaluator,延迟可控。
📊 论文称在公开 benchmark 和工业数据集上都超过现有 baseline,同时保持推理效率;摘要里没给具体数值,我就不编了。
✅ 线上 A/B 测试:GMV +3.75%,目前已部署在淘宝闪购。
总结:如果你们线上还停在“单点评分+贪心排序”,或者拿 reward model 训生成式重排但回报太稀疏,这条路线可以复现看看。要盯的是 list 级 utility 和线上 GMV/CTR,别只看单点 AUC。坑有两个:离线 beam search 挖掘加累计回归训练本身不便宜;dense 信号的质量全看 evaluator 校准,它偏了,生成器只会学得更自信。
2. OneTrans-V2: Unifying Retrieval, Pre-rank, and Fine-rank with One Transformer in Industrial Recommender
- 论文链接:AlphaXiv
- 更新时间:2026-09-23 14:57 UTC
- 机构:未披露机构
- 工业优先级:强
级联推荐三合一,GMV涨9.74% 🚀
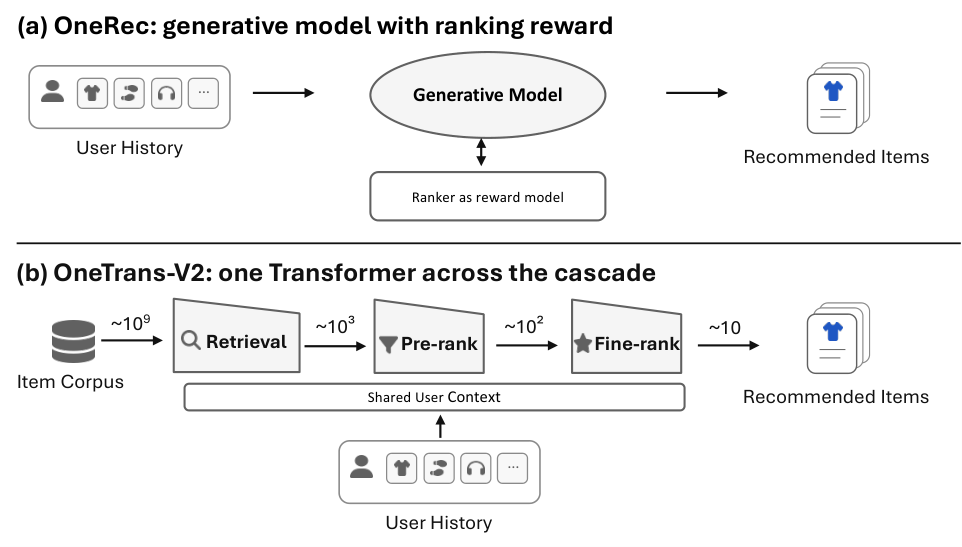
各位算法同学们:一个Transformer同时干召回、粗排、精排,GMV提升9.74%,同硬件下QPS是原级联的3.2倍。看点不是涨点,是它没走OneRec“干掉级联”那条路——候选特征全保留,只把候选无关的用户上下文共享出来。
📄 OneTrans-V2: Unifying Retrieval, Pre-rank, and Fine-rank with One Transformer in Industrial Recommender
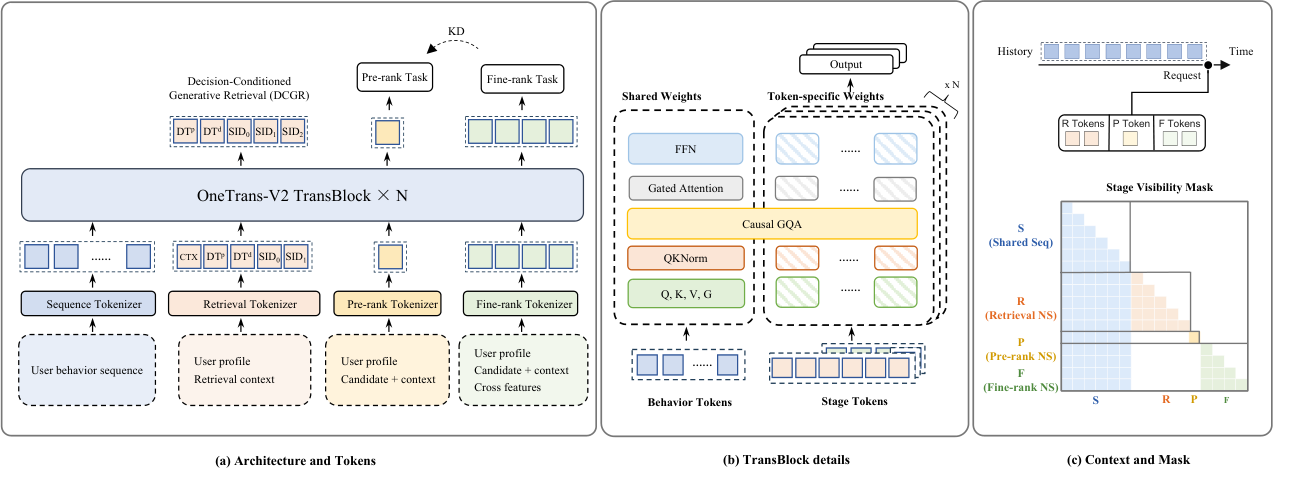
🔧 用户行为序列只编码一次成共享user context,三层各自追加自己的token;stage visibility mask让各阶段读得到上下文但互相看不见,于是粗排能只用1个token保持轻量,精排用多token建模cross feature。
🧩 DCGR治召回的多目标分裂:先预测“决策前缀”(是否转化、金额档位、类目对用户有多新),再条件生成item的SID;业务目标靠business offset去偏决策分布,一套生成模型覆盖多个目标,线上当参数调,不用另训通道。
⚙️ 稀疏MoE撑容量、激活计算有上界,μP式参数化稳住优化;SNT按用户终身行为序列组织训练,把一次序列编码摊到多次曝光上。
📊 GMV提升9.74%,三阶段全量上线 📈 同硬件预算下端到端QPS是原级联的3.2×(依赖协同设计的serving) ✅ SNT带来4.4×训练加速 ✅ 联合训练下召回、粗排、精排都优于各自单独训练的版本
总结:做级联推荐、尤其被“用户序列重复编码”和“召回多通道”磨过的团队,这套共享上下文加DCGR值得对着自己链路比一遍。两个坑要先想清楚:stage visibility mask的token预算得和延迟对齐;3.2×QPS依赖配套serving改造,换模型本身拿不到。对照对象是UniR2、OneRec这类工作,分歧点在于“保留候选特征”还是“去级联”,盯住GMV和QPS/延迟比值这两个指标就够了。
3. X-Rec Technical Report
- 论文链接:AlphaXiv
- 更新时间:2026-09-24 07:53 UTC
- 机构:未披露机构
- 工业优先级:强
TikTok上线:3.46倍吞吐的生成式召回
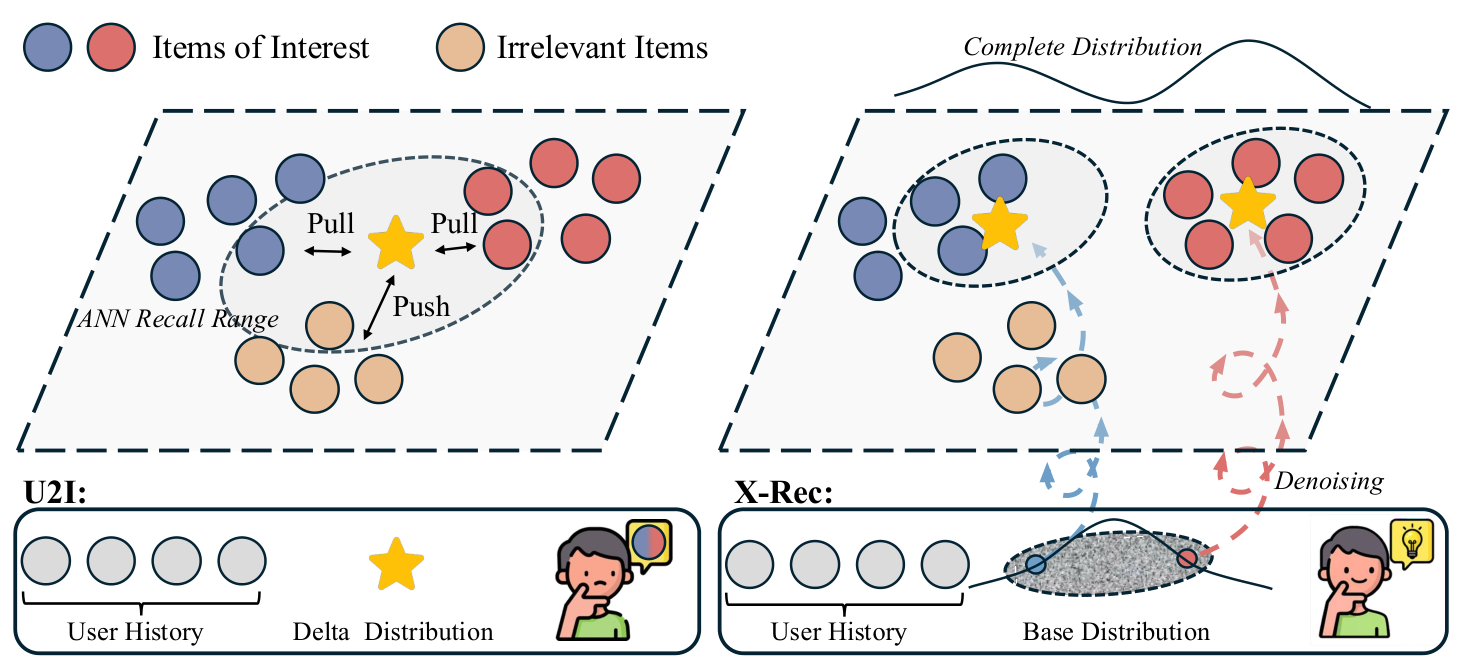
各位算法同学们,双塔U2I把用户兴趣压成一个点,SID-AR又要逐token解码,吞吐被卡死——有没有一条路,既保留多峰分布又不用离散化?TikTok这篇X-Rec给了一个挺工程化的答案。
📄 X-Rec Technical Report
🔧 锚点条件生成:先预测目标embedding所属的簇(锚点),再以锚点为条件做细粒度生成,把从零生成item向量拆成“选大致语义区域+局部精修”,官方说这一项让Recall@20涨了2.05个百分点,还能通过调整锚点分布主动控制召回多样性。
🧩 黎曼流匹配:item embedding大多在余弦对比学习下训出来,本身就躺在球面上,所以生成轨迹直接沿球面测地线走,而不是在欧氏空间里强行把向量拽回球面,比rectified FM的Recall@20高1.78个绝对百分点。
⚙️ late-interaction DiT:速度场估计只在最后一层Transformer做,前面几层不做重复去噪。代价是Recall@20只掉1.05个百分点,生成吞吐却涨了约8.28倍,这个交换比在召回场景里算很划算。
📊 流式benchmark上明显超过U2I基线,召回质量和SID-AR打平,推理吞吐是SID-AR的3.46倍。
📈 已作为TikTok某垂直内容的新召回源上线,连续两次launch带来垂直互动+4.1484%。
✅ 大盘互动也有+0.0111%,别小看这个数,召回侧能撬动全站指标通常很难。
📉 消融里三项设计各自都有正收益,不是靠堆参数堆出来的。
总结:如果你在做大规模召回、又被SID-AR的解码延迟折磨,这篇值得细看,重点盯吞吐-Recall的权衡曲线,以及锚点数量和聚类更新频率怎么设。坑在于连续空间生成对ANN索引和线上一致性要求更高,离线Recall涨了不代表线上一定涨,最好先小流量验证锚点分布的可控性。
4. ScalarLens: Numerical Embeddings with Stable Coordinates and Contextual Responses for CTR Prediction
- 论文链接:AlphaXiv
- 更新时间:2026-09-24 07:54 UTC
- 机构:Ant Group,Independent Researcher,Alibaba Inc.,Henan Polytechnic University
- 工业优先级:中
- 备注:12 pages, 5 figures
🔍同一个数值,CTR证据会反号
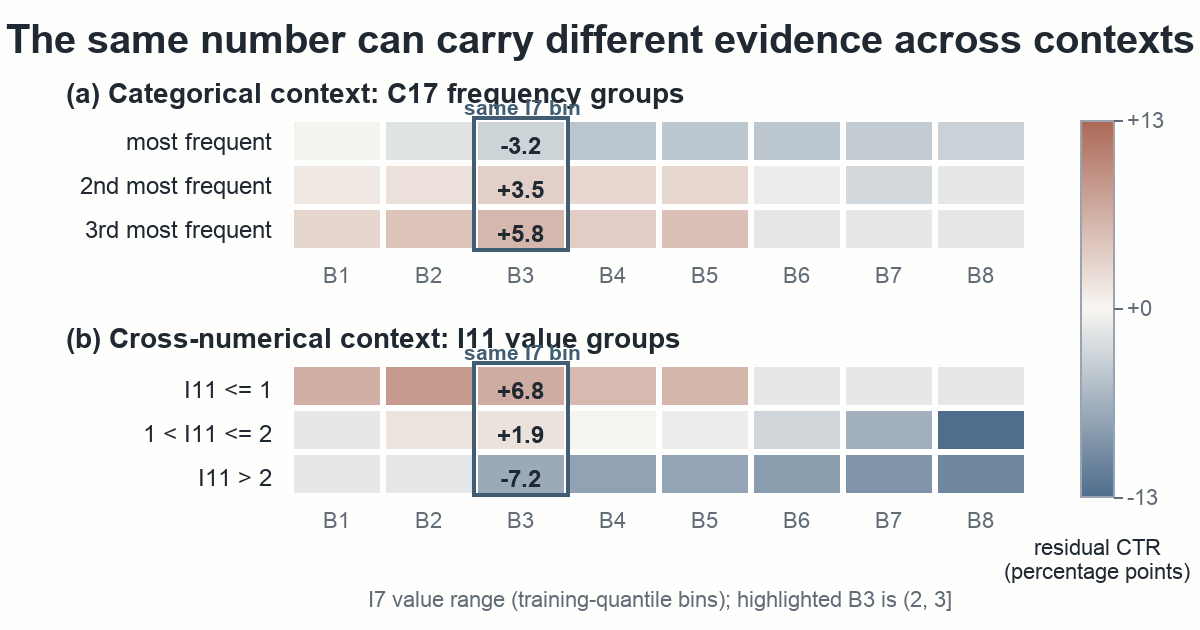
各位算法同学们,同一个数值区间,在不同上下文里的点击证据能正负反转。这篇把数值 embedding 从“一个标量一个表示”改成“坐标稳定、响应看上下文”,而且没动 CTR backbone。
📄 ScalarLens: Numerical Embeddings with Stable Coordinates and Contextual Responses for CTR Prediction
🔧 核心是把数值接口拆成两个可检查对象:坐标只由标量本身决定,响应才吃类别和辅助数值上下文。上下文不能移动坐标,只能改它怎么被解释。
🧩 坐标用单调局部 mesh 生成,保留数值顺序;响应是有界低秩动态,固定步数更新,不替换类别 token,也不另起一套交互 backbone。
⚙️ 模块只返回数值 embedding,类别 embedding 原样绕过。作者类比计算物理里的 model reduction,作为 inductive bias,而不是说 CTR 数据服从物理定律。
📊 主评估 1,539 次 run,覆盖 19 种表示、3 个数据集、9 个 backbone、3 个 seed。原始数值尺度下,27 个设置里 25 个排第一,剩下 2 个排第二。
📈 Criteo 验证集上,I7 的 (2,3] 区间在 C17 分组下残差点击证据为 -3.2、+3.5、+5.8 个百分点;在 I11 不同范围下为 +6.8、+1.9、-7.2,符号会反。
✅ 匹配消融显示,scale correction、额外局部容量、generic conditioning 都复现不了增益;统一标准化重跑后,对 DEER、DAES、NaryDis 仍有显著优势。
总结一句:如果你在做 CTR 数值特征,这篇适合看它怎么划“坐标 vs 响应”的边界。要盯原始尺度和标准化后是否都稳、换 backbone 后排名是否保持;坑在上下文来源选择和训练/服务同步,别把无关上下文也塞进响应。
5. From Interests to Semantic IDs: Retrieval-Grounded Credit Assignment for Generative Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-09-24 15:34 UTC
- 机构:未披露机构
- 工业优先级:中
SID奖励太稀疏?把信用分给兴趣句
各位算法同学们:一组 rollout 全都没命中目标 SID 时,group-relative RL 的优势直接归零,这批采样等于白跑;更隐蔽的是,两条推理完全不同的轨迹,只要 SID 奖励相同,拿到的更新就一模一样。这篇要补的就是这个 credit assignment 的缺口。
📄 From Interests to Semantic IDs: Retrieval-Grounded Credit Assignment for Generative Recommendation
🔧 把一条 rollout 拆成 history summary、若干条 interest hypothesis 和最终 SID,兴趣句用固定格式输出,因此可以逐条被独立检验,而不是只能靠最后那个 SID 背锅。
🧩 每条 interest 都拿去问一个冻结的 retriever,谁把目标捞进 top-K,正优势就只发给那一行兴趣;而且检索这条通道永远不会去更新最终 SID 那段 span,SID 还是由 exact-match 单独管。
⚙️ 于是同一个 SID 奖励的 rollout 能拿到不同更新;一组里 SID 奖励全为 0、但检索奖励有差异时,兴趣行依然有梯度可学。结构、检索、SID 三路奖励分别归一化。
📊 三个 Amazon Reviews 数据集上,SID 推荐指标一致提升。
📈 Video Games 的 oracle 分析显示,在生成的兴趣里挑出与目标相关的那条 query,recall 和 ranking 都会变好,说明兴趣条件化的 SID 解码还有余量;兴趣本身也能当辅助召回池,约束解码时的候选 trie。
✅ 论文还统计了检索通道能把多少 SID 全 0 的组重新激活,代码已开源。
总结:适合已经在跑 SID + reasoning RL、又被稀疏奖励卡住的人。落地先盯冻结 retriever 的召回和 top-K 取值,检索器不行的话,正信号会被系统性压低,反倒把兴趣句带偏;另外它没替换 SID 奖励,只是在旁边加了一条检索旁路,和 PROMISE、HCGRec 这类沿 SID 路径做过程监督的思路是互补而非替代。
6. Decoupled Learning and Selection in Slate Recommendation for Privacy and Stability Under Noisy Scores
- 论文链接:AlphaXiv
- 更新时间:2026-09-24 12:09 UTC
- 机构:University of Bergen,City University of Macau
- 工业优先级:中
- 备注:20 pages including supplementary appendix. Accepted at ACM RecSys 2026
🔍推荐加DP,隐私就够了吗?
各位算法同学们,给推荐系统套上差分隐私,端到端隐私就自动成立了吗?这篇的答案是:不一定,卡点不在学习器,而在那个确定性选择器读了什么。它把 slate 推荐拆成“随机打分 + 贪心选列表”两段,专门算清隐私、可审计和稳定性各在哪一层成立。
📄 Decoupled Learning and Selection in Slate Recommendation for Privacy and Stability Under Noisy Scores
🔧 把 slate 推荐形式化成随机分数学习器加确定性选择器:隐私靠后处理穿过选择器和审计轨迹,但范围取决于每个非学习器输入。公开或独立、先前 DP 输出、单独记账的输入才能撑起端到端 DP;直接固定原始 state 或候选信息,只剩条件保证。
🧩 给出一个可审计的 margin 证书:分数变化诱导的目标移动只要低于最小贪心决策 margin 的一半,有序 slate 就保证不变,margin 和扰动包络都写在决策日志里。
| ⚙️ anchor 混合可以压低 top-K 的分数不稳定,证书进一步说明这种稳定性什么时候能传到最终列表;审计成本是 O( | C_t | ) 个标量字段、至多 O(K_t | C_t | ) 次相似度查询,不是 O( | C_t | ^2) 的稠密矩阵。 |
📊 受控固定 margin 测试里,指数缩放的经验斜率是 -0.220,95% CI [-0.231, -0.210],独立噪声参考是 -1/4,接近线性。
📈 在 OULAD、MovieLens-25M、Amazon Musical Instruments 上,anchor 权重越大,分数噪声引起的排序 churn 越小。
✅ OULAD 和 EdNet 的证书检查对上了日志不等式;闭环仿真里目标漂移有界,但下游效用随设置变化,并不是一律变好。
我的判断:做两段式推荐、要写 DP 报告或做审计的同学可以跟,重点盯选择器输入清单和 margin 日志这两件事。坑也很明确:非私有 anchor 只能用于稳定性分析,混进端到端 DP 声明就错了;而且它没给普适效用提升,分数稳定不等于业务指标一定涨。