推荐算法日报 · 2026-09-25
总览
今天这四篇没有那种一看就要掀桌子的新范式,但整体成色相当扎实,而且罕见地都愿意把自己的坑讲清楚。主线基本两条:一条是生成式推荐怎么在真实工业约束下落地,另一条是把大家习以为常的中间表示和输出接口拎出来做受控打假。落地这条线上,最值得看的是那篇把 LLM 式序列生成以「加法式升级」滑进成熟排序栈的工作——换回旧配置能精确退化成基线、支持按请求级 fallback、还敢拿两个大流量 surface 的七天在线 A/B 说话,这种工程诚实度今天真的不多见;另一篇在生产流媒体数据上直接对 LLM 用户画像做了同下游、同 embedding 的受控消融,结论挺反直觉:全量用户上 LLM 画像反而掉点,只有一小撮 explorer 用户能翻盘,而且 diversity 好看的同时 catalog coverage 塌得很惨。打假这条线上,semantic ID 那篇复现研究最有方法论价值,它用统一预处理加固定 backbone 把「codebook utilization 越高越好」这个流传已久的直觉证伪了,还顺手说明生成式并不天然强过 SASRec,这种结论比再刷一个 SOTA 有用得多;watch-time 那篇把点估计升级成分布 serving interface 的思路也挺妙,尤其 matched-readout 那段控制实验,直接暴露了主表里那截检索提升到底来自表示还是决策层,这种自证式设计值得学。唯一要泼的冷水是:四篇里只有一篇有真实线上结果,其余全是离线指标,看到动辄十几个点的相对提升先别急着信,另外两篇工业向的结论都还局限在自家场景,跨域泛化仍是空白。今天优先看 LIGE-GR 和那篇 semantic ID 复现研究,前者学怎么在旧栈里落地,后者学怎么不被漂亮的指标忽悠。
论文列表
1. LIGE-GR: A Smooth Leap from Ranking to Generative Recommendation in the LLM Era
- 论文链接:AlphaXiv
- 更新时间:2026-09-20 18:06 UTC
- 机构:未披露机构
- 工业优先级:强
把排序变生成,线上只涨1.14% 🤔
各位算法同学们,把成熟排序系统改成生成式推荐,线上时长只涨 1.14%,但多花的推理资源约等于原 context-free 排序组件的 10%——这可能是工业界更愿意接受的一步。这篇 LIGE-GR 想解决的是:LLM 式 listwise 生成到底怎么塞进已有推荐栈,而不是推倒重来。
📄 LIGE-GR: A Smooth Leap from Ranking to Generative Recommendation in the LLM Era
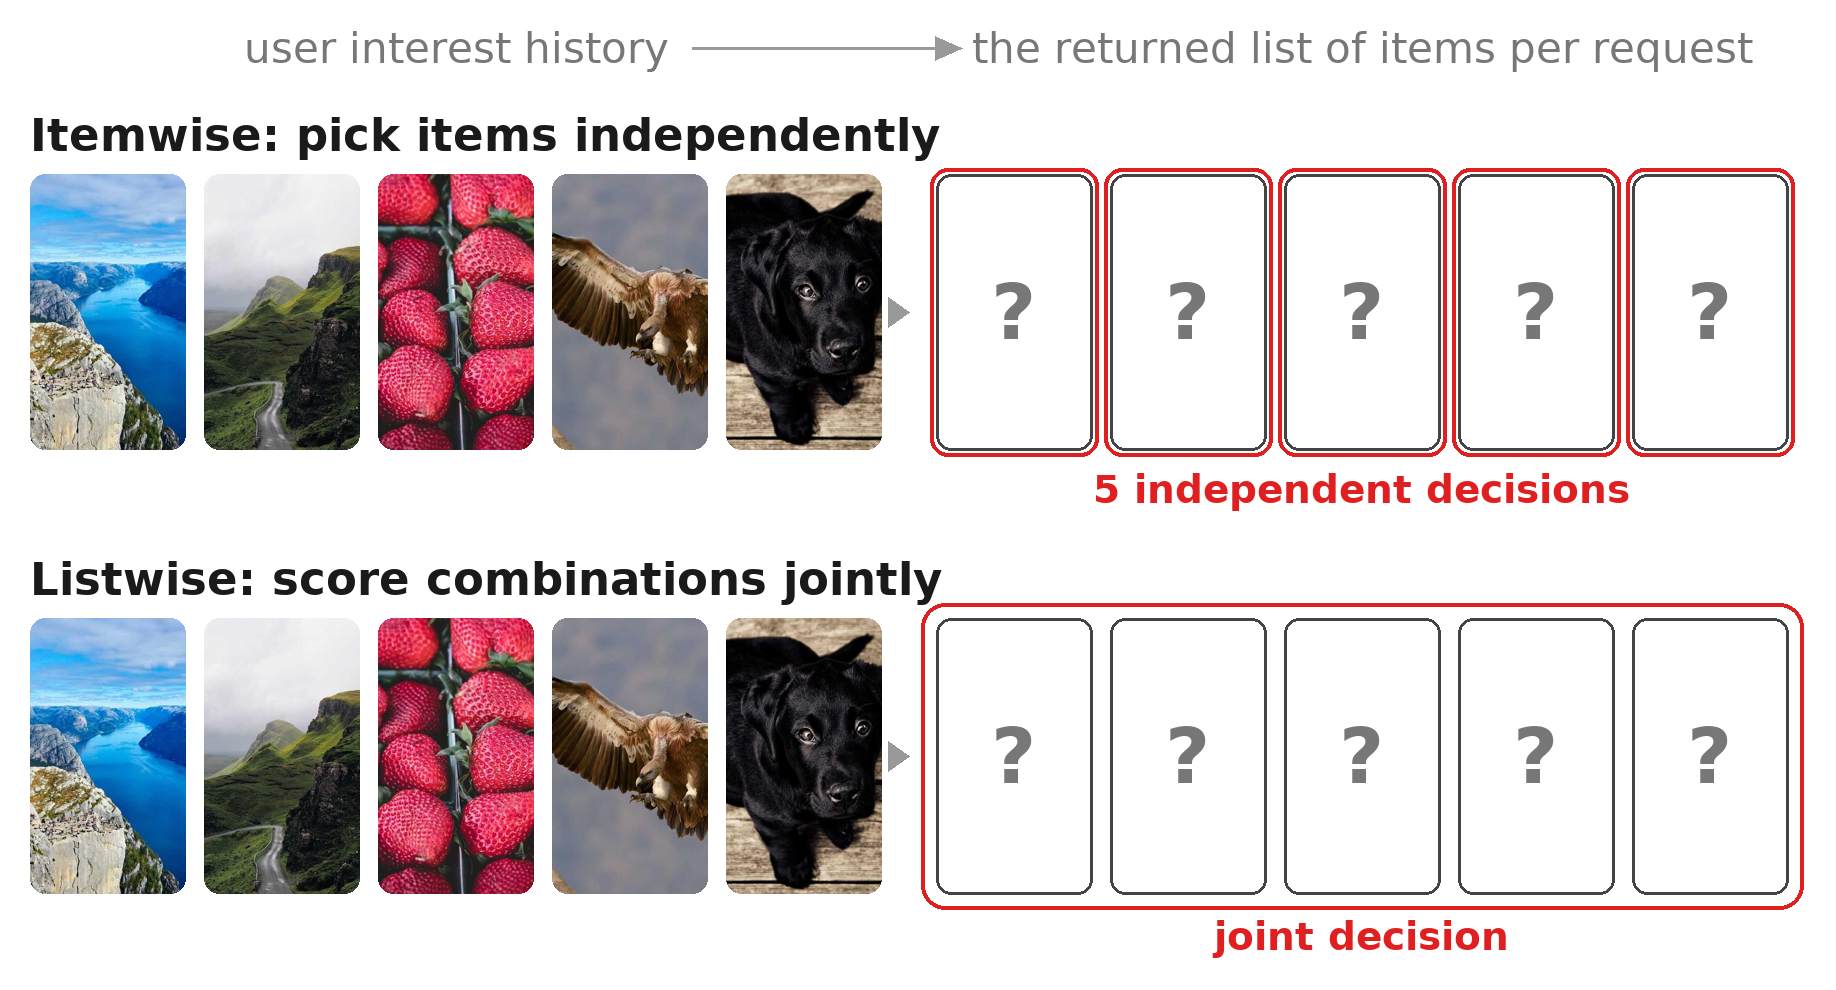
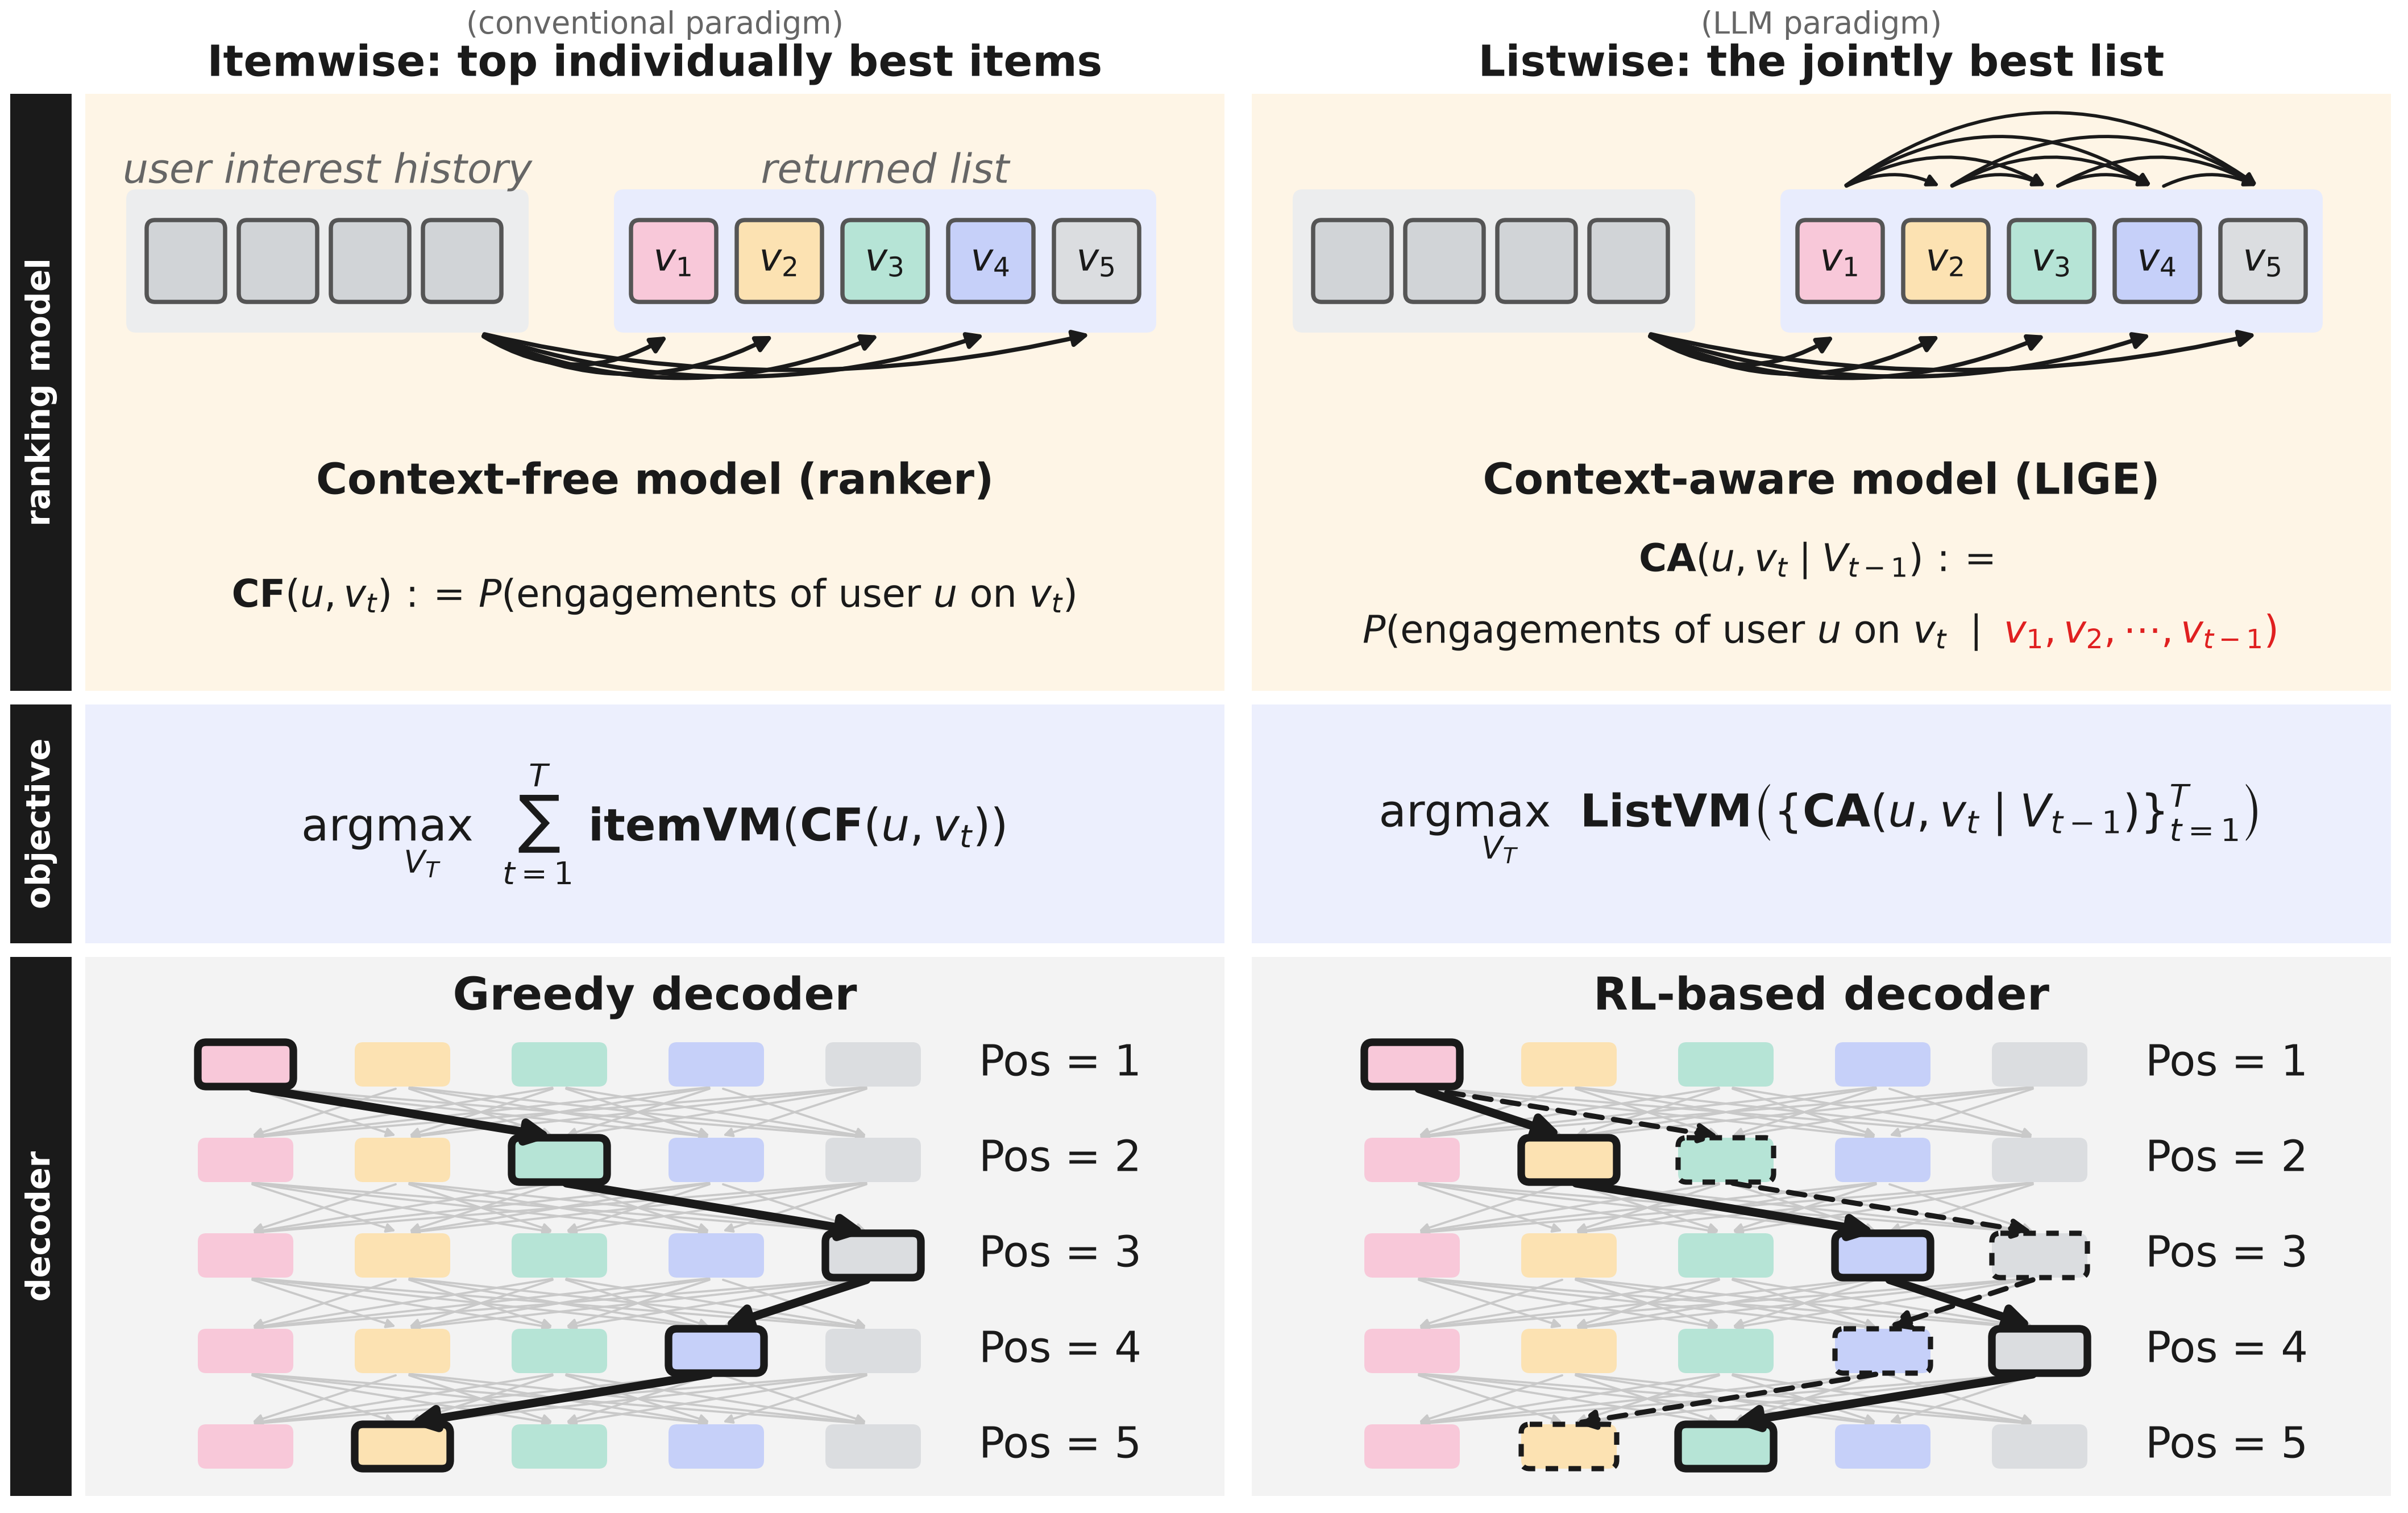
🔧 排序模型从 context-free 升级到 context-aware:每个 item 的预估值不再只看用户和自己,还会看已排进列表的前缀,用轻量 4 层 causal Transformer 做条件修正。
🧩 目标函数从 itemwise 打分求和,扩成 listwise value model,整条序列一起评估;同时保留原控制层做多样性和业务约束,兼容已有 value function。
⚙️ 解码从逐位置贪心选最高分,换成 RL-based 序列解码(Palette decoder),在位置×候选的路径里探索;且三个模块都能回退,退回去就恢复原系统。
📊 Instagram Reels 上 time spent 提升 1.14%。
📈 Facebook Video 上 time spent 提升 0.72%。
✅ 额外推理资源约为 context-free 排序组件的 10%,端到端每请求延迟增加约 7%。
✅ 列表长度 T 设为 10 左右,不是重造整条链路。
我的判断:它更适合已经有成熟排序栈、想试 listwise 优化又不想大换血的团队。要盯的是延迟预算、RL 解码在线上是否稳定、回退开关是否真能无损;如果 baseline 已经调得很强,百分位收益的复现难度不低,别只看离线的序列指标。
2. When LLM-Based User Profiling Adds Value in Production Streaming Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-09-23 00:42 UTC
- 机构:DePaul University / Comcast Technology AI,Comcast Technology AI
- 工业优先级:中
LLM做用户画像,别急着全量上线🧪
各位算法同学们,LLM生成用户画像不是万能钥匙:这篇生产流媒体推荐论文发现,聚合质心在习惯型用户上更稳,LLM只对探索型用户有准确率增益。它真正回答的是,贵出来的LLM画像什么时候才该上。
📄 When LLM-Based User Profiling Adds Value in Production Streaming Recommendation
🔧 2×2设计:表示类型分SBERT质心与LLM自然语言摘要,时间处理分全历史与短期/长期注意力融合,得到Centroid、TemporalCentroid、Narrative、TemporalNarrative四种策略。
🧩 控制变量干净:物品embedding、下游MLP、训练和评估全一致,唯一变量是用户画像向量怎么构造,方便看画像设计本身。
⚙️ 结论分人群:习惯型用户上聚合方法占优;探索型用户未来消费和过去行为偏离时,LLM画像才有准确率收益。
📊 四个策略、2×2交叉、top-K全目录打分,都在同一套生产数据协议下比,不是拿公开电商benchmark直接外推。
📈 反直觉:LLM让单条推荐列表略更多样,但系统整体更集中到更小、更热门的内容子集,目录覆盖率和推荐新颖度有可测下降。
✅ 时间窗口超参有工作区间,别默认短期/长期切分一定涨点;论文把部署代价和收益分开看。
总结:做内容推荐、候选集大、用户行为异质的话,这篇可以当上线检查表。别先问LLM画像能不能涨AUC,先按用户分层看探索型占比,再盯覆盖率和novelty,和聚合质心做A/B。坑是LLM画像成本、刷新频率和工程复杂度,别全量替换默认策略。
3. What Makes a Good Semantic ID for Generative Recommendation? A Reproducibility Study
- 论文链接:AlphaXiv
- 更新时间:2026-09-21 11:26 UTC
- 机构:Shandong University,University of Glasgow,Leiden University
- 工业优先级:中
- 备注:Accepted by SIGIR-AP 2026
🔍SID设计没有全局最优?复现研究
各位算法同学们,如果你的生成式推荐还在默认堆 RQ-VAE、顺手把 SID 加长,这篇复现研究可能会先泼你一盆冷水:SID 设计的影响大多是非单调的,没有哪种设计在所有数据集上都最好。
📄 What Makes a Good Semantic ID for Generative Recommendation? A Reproducibility Study
🔧 统一框架下重跑:同一套预处理、数据划分和评测器做方法级对比,再固定生成骨干和训练协议、只改 SID,把标识符本身的影响单独拎出来看。
🧩 四个研究问题拆解:不同 SID 设计的相对效果、码本利用率与推荐质量的关系、SID 长度和骨干规模两个维度的 scaling、以及 SID 设计对局部语义邻域保持的影响。
⚙️ 加了一层诊断:除了排序指标,还跨数据集看一级码本均衡度和局部语义保持,覆盖不同数据规模和邻域大小。
📊 统一框架下四个数据集,RQ-VAE 和 OPQ 这类常用设计表现并不一致,谁赢跟数据集强相关。
📈 一级码本最均衡的方法并不是稳定最优的推荐器,说明利用率能当诊断信号,但不够当选择标准。
✅ 加长 SID 或放大 T5 骨干都不总是有收益,scaling 同样呈非单调。
🔍 语义邻域上,OPQ 更擅长找回语义近邻,RQ-Kmeans 更擅长保住最近邻的排序,两者互补,且在四个数据集和不同邻域大小下都稳定。
总结:这篇的作用是提醒你别再把 SID 当免费午餐。做生成式推荐的同学,可以先在自己的数据上对齐复现,盯住一级码本均衡度、SID 长度收益拐点和局部邻域保持这几个指标,而不是直接照搬某个所谓最好的 tokenizer。要注意的坑是,结论来自四个数据集,换到你的类目分布或冷启场景,非单调可能更明显。代码已开源,可以拿来当 baseline 校准,但不必当成选型定论。
4. Beyond a Scalar: Distributional Serving Interfaces for Watch-Time Prediction
- 论文链接:AlphaXiv
- 更新时间:2026-09-23 16:57 UTC
- 机构:Shanghai Jiao Tong University,Rice University
- 工业优先级:中
📉推荐模型别只输出一个标量
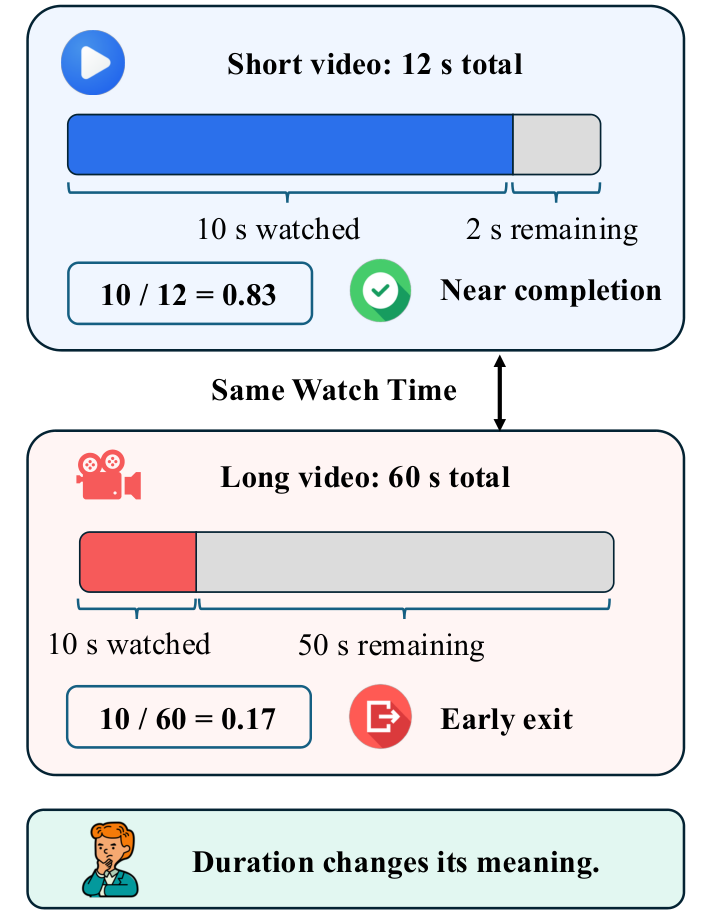
各位算法同学们,同一条“看了10秒”,放在12秒视频里是快看完,放在60秒视频里只是刚开头,但很多推荐系统下游拿到的仍然只是一个标量。这篇把观看时长预测从“给个点估计”改成可复用的分布接口,正好戳中多任务场景的痛点。
📄 Beyond a Scalar: Distributional Serving Interfaces for Watch-Time Prediction
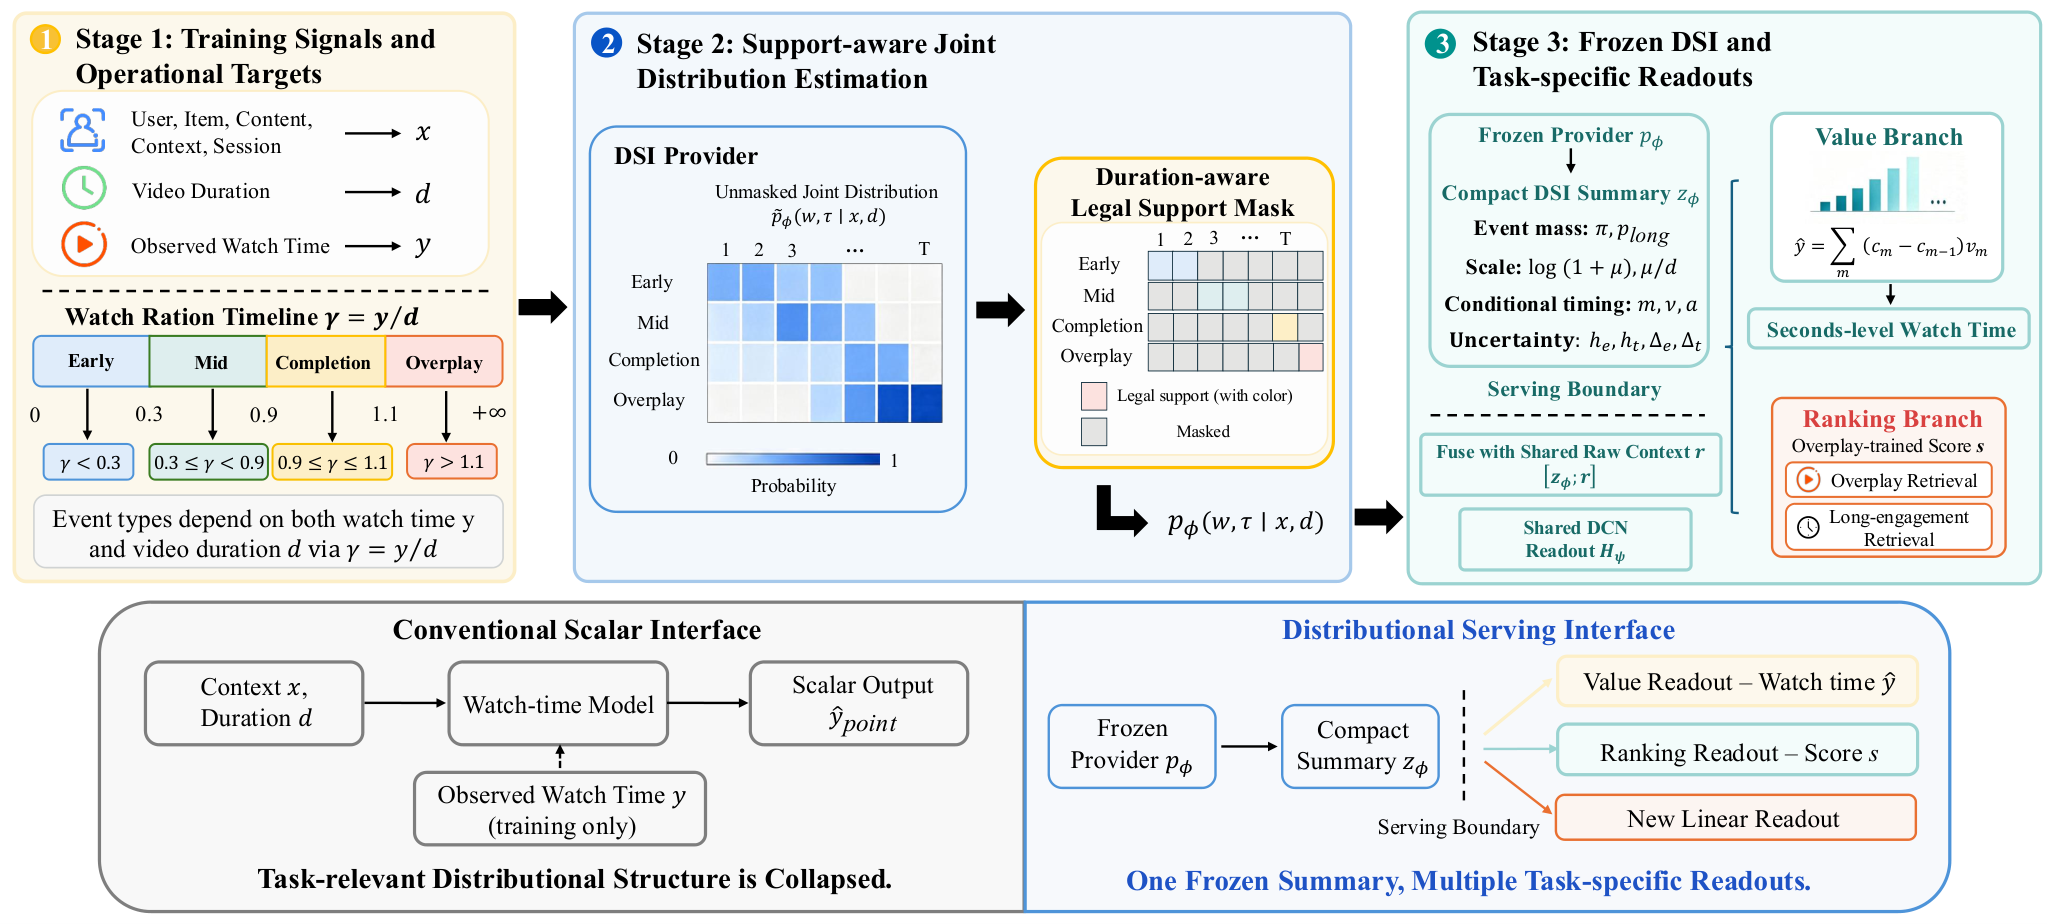
🔧 把观看行为拆成 early、mid、completion、overplay 四类事件,用观看比例 γ=y/d 生成监督,不需要额外收集新标签。
🧩 训练 provider 估计“事件类型 × 事件时间”的联合分布,用视频时长构造支持约束,过滤不合法组合,再加秒级 restoration loss,保证预测回到秒数仍然准。
⚙️ 推理时冻结 provider,只往下游暴露低维 summary,包含事件概率、相对时长和不确定性;新任务接轻量 readout 就行,不用重训 provider。
📊 在 KuaiRec、KuaiRand-1K、WeChat21 三个数据集上,完整 DSI 的 MAE 都最低,比九个基线里最强结果好 1.9% 到 8.5%。
📈 XAUC 在两个数据集上取得最好结果;比较完整系统时,考虑视频时长的 retrieval 指标也领先。
✅ 固定 readout 做对比,summary 仍保留超出“预测均值 + 视频时长”的任务信息;同一套线性头换到两个新观看时长目标上表现最好,并提升了一个单独记录的 engagement 目标。
🧪 随机初始化 provider 复现不出这个增益,说明收益主要来自学到的分布结构,而不是接口本身。
各位算法同学们要是做短视频排序、多目标或时长预估,这篇可以拿来对照自己的 serving 输出。落地时先看 provider 的分箱和 support mask 是否贴合业务时长分布,再盯 MAE、XAUC 和 duration-aware retrieval;如果基线只是 duration-aware 标量,记得用固定 readout 做同条件比较,不然容易把接口增益和模型容量混在一起。